EINE DATENBANK FÜR IHRE APP- und KI-AGENTEN
Couchbase Server
Couchbase Server ist eine schnelle Datenbank für Ihre Apps und KI-Agenten – sowohl lokal als auch in jeder Cloud. Ihre Kunden müssen nicht mehr auf langsame Daten warten, und Ihr Team muss nicht mehr zwischen vier Systemen umschalten.
Stoppen Sie die Zahlung für Systeme, die Sie verlangsamen
Jede zusätzliche Datenbank erfordert eine zusätzliche Bereitstellungsaufgabe, eine Synchronisierung und eine Bereitschaftsdienstrotation. Couchbase Server erledigt die Arbeit von vier Systemen, sodass Ihr Team schneller arbeiten kann.
Schnell, wenn es zu hohen Verkehrsstaus kommt
Ein Speicher-first-Design und eine integrierte Cache-Funktion sorgen dafür, dass Apps auch bei Spitzenverkehr schnell funktionieren – damit Ihr stressigster Tag nicht zu Ihrem schlimmsten Ausfall führt.
Eine Datenbank statt vier
Ihr Dokumentenarchiv, Ihre Cache-Datenbank, Ihre Suchmaschine und Ihre Vektordatenbank werden zu einem Ganzen zusammengefasst. Ein einziger Rechnungsbetrag, eine einzige Bereitschaftsdauer – und nichts mehr zu synchronisieren.
KI ohne eine weitere Vektordatenbank
Die Vektor- und Hybridsuche wird auf den Daten Ihrer Live-App ausgeführt, sodass die Antworten der KI aus dem aktuellen Stand der Dinge stammen, nicht aus der Kopie von gestern Abend.
Skalierbar und stabil
Fügen Sie Knoten hinzu, während Ihre App weiterhin läuft. Wenn einer fehlschlägt, übernehmen die Repliken das Senden in Sekundenschnelle. Ihre Kunden merken das gar nicht erst.
Was ist Couchbase Server?
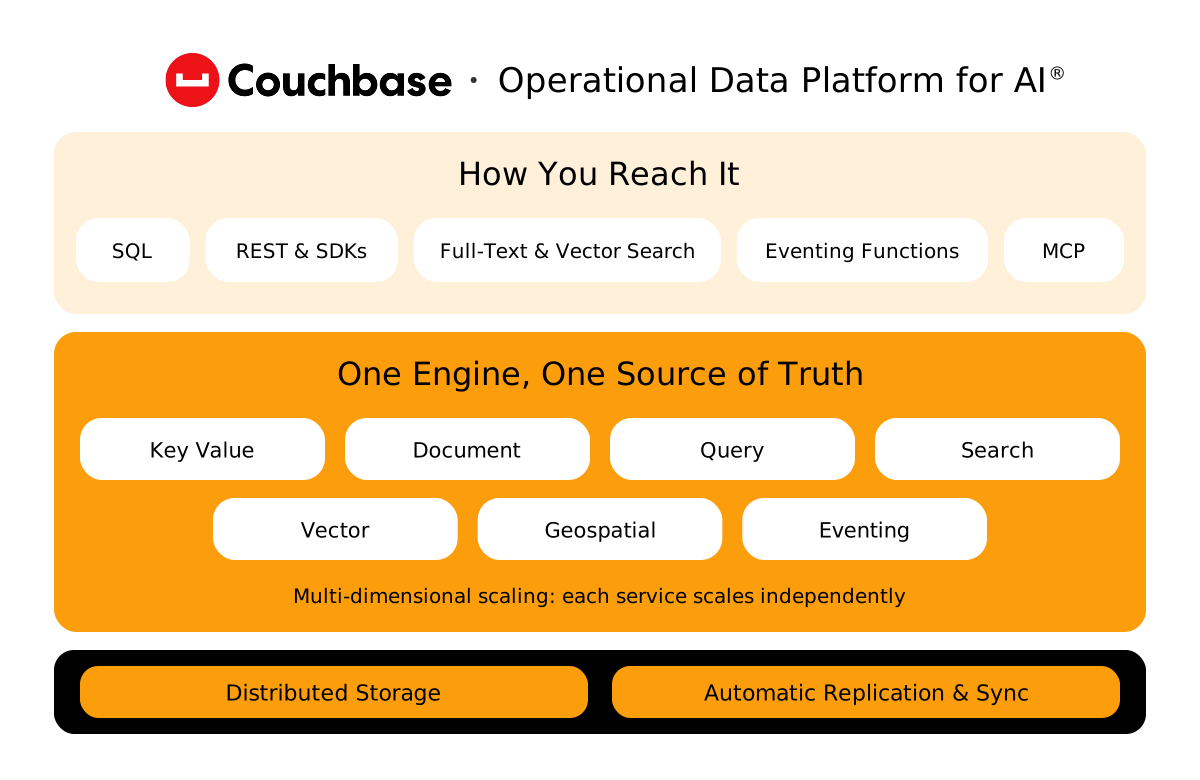
Couchbase Server ist eine verteilte NoSQL-Datenbank, die JSON speichert und Schlüssel-Wert-, SQL-, Such- und Vektor-Workloads aus einer einzigen Engine bereitstellt.
Die Schlüssel-Wert-Suche, SQL-Abfragen, Volltextsuche, Vektor-Suche und Eventing werden alle in Couchbase Server auf dieselben Daten ausgeführt – mit einem integrierten Cache voran. Indizes werden automatisch aktualisiert, wenn Dokumente geändert werden, sodass Ihre Apps und KI-Agenten aus einer einzigen Quelle der Wahrheit auskommen. Es gibt keine ETL-Jobs zwischen den Datenbanken, die erst am 2. Uhr morgens zur Ausführung warten.
SQL++ ist SQL für JSON. Jeder, der SQL kennt, kann bereits am ersten Tag Verbindungen, Unterabfragen, Aggregate und ACID-Transaktionen über mehrere Dokumente mit flexiblen JSON-Dokumenten erstellen. Sie erhalten die Flexibilität einer Dokumentendatenbank, ohne Ihr Team neu auszubilden oder eine proprietäre Abfrage-Sprache einzusetzen. Entwickler können auch einfach in Englisch fragen und erhalten anschließend eine SQL-Ausgabe.
Die multidimensionale Skalierung ermöglicht es, Daten, Abfragen, Indexe und Suchvorgänge auf eigenen Knoten auszuführen. Bei starken Suchverkehrsstromen fügen Sie Suchknoten hinzu, nicht eine größere Kopie der Daten. Die Rebalancing-Verfahren laufen während der Online-Dienstfähigkeit Ihrer App, sodass eine Wartungsphase für die Skalierung nicht erforderlich ist. In Server 8.5 werden ganze Datendateien kopiert, was in internen Tests im Durchschnitt etwa 4x schneller ist.
Die Cross Data Center Replication (XDCR) ermöglicht es Cluster in jeder Region oder in der Cloud, Schreibvorgänge durchzuführen und sie in beide Richtungen zu replizieren. So werden Konflikte automatisch gelöst. Für die Datensouveränität entscheiden Filter, welche Dokumente eine Region verlassen dürfen. So bleibt regulierte Daten in dem jeweiligen Land, während die restlichen repliziert werden. Sollte eine Region ausfallen, wird der Datenverkehr auf eine andere Region umgeleitet, die bereits aktiv ist.
Statistiken und Benchmarks
<1ms
Lesungen mit geringer Latenz aus dem integrierten Cache, auch bei Spitzenbelastung
3.9x
Höhere Durchsatzleistung als eine führende Dokumentdatenbank, gleiche BenchANT-Konfiguration
KUNDENERGEBNISSE
Vertraut von Apps, die nicht ausfallen können


WAS IST NEUES IN 8.5
Alles, was Ihre Apps von einer einzigen Datenbank benötigen
Nachgewiesene Leistungsfähigkeit sowie neue Funktionen in der privaten Preview von Server 8.5.
- Skala
- Schützen
- Suche
- Verwalten
- Verbinden
Erweitern Sie die Kapazität in wenigen Minuten und passen Sie mehr Mieter pro Cluster an.
Hauptfunktionen
Schnellerer Rebalancing
Rebalance kopiert nun ganze Datendateien zwischen den Knoten ab, anstatt jeweils ein Dokument. In internen Tests war die Geschwindigkeit im Durchschnitt um das Vierfache höher. In internen Tests war die Geschwindigkeit im Durchschnitt um das Vierfache höher.
Mehrdimensionale Skalierung
Verarbeiten Sie Daten, führen Sie Abfragen, erstellen Sie Indizes und führen Sie Suchvorgänge auf eigenen Knoten aus. Fügen Sie Kapazität nur hinzu, wenn eine Arbeitslast dies erfordert.
Höchstgrenzen für die Anzahl der Behälter
Garantieren Sie eine hohe Durchsatzleistung für kritische Workloads wie Kassenabwicklung und verringern Sie lautstarke Workloads wie Batch-Jobs, damit ein Anwender den anderen nicht unterbricht.
Alles auf der Festplatte verschlüsseln und die Daten auf die zweite Festplatte wiederherstellen – nicht auf die von gestern Abend.
Hauptfunktionen
Point-in-time-Wiederherstellung
Die kontinuierliche Sicherung sendet alle Änderungen so oft an den Speicher, wie alle zwei Minuten. Wiederherstellen kann man bis zu zwei Sekunden vor einem Fehler, also auf eine einzige Sammlung.
Native Verschlüsselung im Ruhezustand
Die integrierte Verschlüsselung deckt alle Dienste ab, außerdem werden Protokolle und Überwachungspfade erstellt. Die Schlüssel bleiben in Ihrem Schlüsselmanager gespeichert und werden nach einem festgelegten Zeitplan gewechselt.
Moderne Identität und Geheimnisse
Verwenden Sie JWT-Tokens und Einmal-Authentifizierung anstatt gespeicherter Passwörter. Ein Credential-Store speichert Schlüssel für die Cloud-Speicherung und KI-Modelle.
Die Vektor-, Text- und Hybridsuche werden auf Ihren Live-Daten ausgeführt, sodass KI-Apps eine präzise Kontextinformation erhalten können, ohne eine separate Vektordatenbank benötigen.
Hauptfunktionen
Vektor- und Textsuche
Verwenden Sie die Funktion „Vergleichbarkeit“ und die Volltextsuche auf Live-Betriebsdaten, ohne dass eine separate Vektordatenbank synchronisiert werden muss.
Hybrid-Suche in SQL
Kombinieren Sie Schlüsselwörter und Vektor-Suche, oder sparse und dense Vektoren, und fügen Sie die Ergebnisse in eine Rangliste zusammen – alles in SQL.
Fragen Sie einfach in klarer Sprache
Fragen Sie einfach und verständlich und behalten Sie den Kontext im gesamten Chat bei. Fügen Sie Ihre Geschäftsbedingungen hinzu, z. B. was ein Nettoumsatz bedeutet, um bessere Antworten zu erhalten.
Aktualisieren Sie ohne Überraschungen und verarbeiten Sie Ihre Datenlake ohne ETL.
Hauptfunktionen
Autonomer Operator
Automatisieren Sie die Bereitstellung, Skalierung, Upgrades und Backups in Kubernetes, einschließlich OpenShift und verwalteten Clouds.
Abfragen von Apache Iceberg-Tabellen
Verknüpfen Sie Live-Daten mit Iceberg-Tabellen in S3, Google Cloud Storage oder Microsoft Azure aus einer einzigen SQL-Abfrage. Kein ETL-Pipeline-Schritt erforderlich, keine Kopien erforderlich.
Vielseitigkeit
Lauf JavaScript-Funktionen, sobald sich die Daten ändern, für Warnmeldungen, Erweiterungen und weitere Aktualisierungen.
Kopieren Sie Anwendungen in verschiedenen Regionen, Clouds und Geräten und stellen Sie sicher, dass Apps immer aktiv sind.
Hauptfunktionen
Active-Active-Replikation
XDCR repliziert Daten in beide Richtungen über Regionen und Clouds hinweg, sodass Apps auch dann weiterhin funktionieren, wenn eine Region ausfällt.
Nur lokale Änderungen senden
In einem globalen Mesh kann jeder Cluster nur seine eigenen Änderungen einmal senden, um die Übertragungskosten zwischen den Regionen zu senken.
Synchronisieren auf Mobilgerät und Edge
Sync Gateway hält die Couchbase Lite-Apps und -Agenten auf den Geräten mit der Cloud synchronisiert, sodass sie immer online bleiben.
- Ein Motor
- Betrug
ARCHITEKTUR
Ein Motor, keine vier Datenbanken
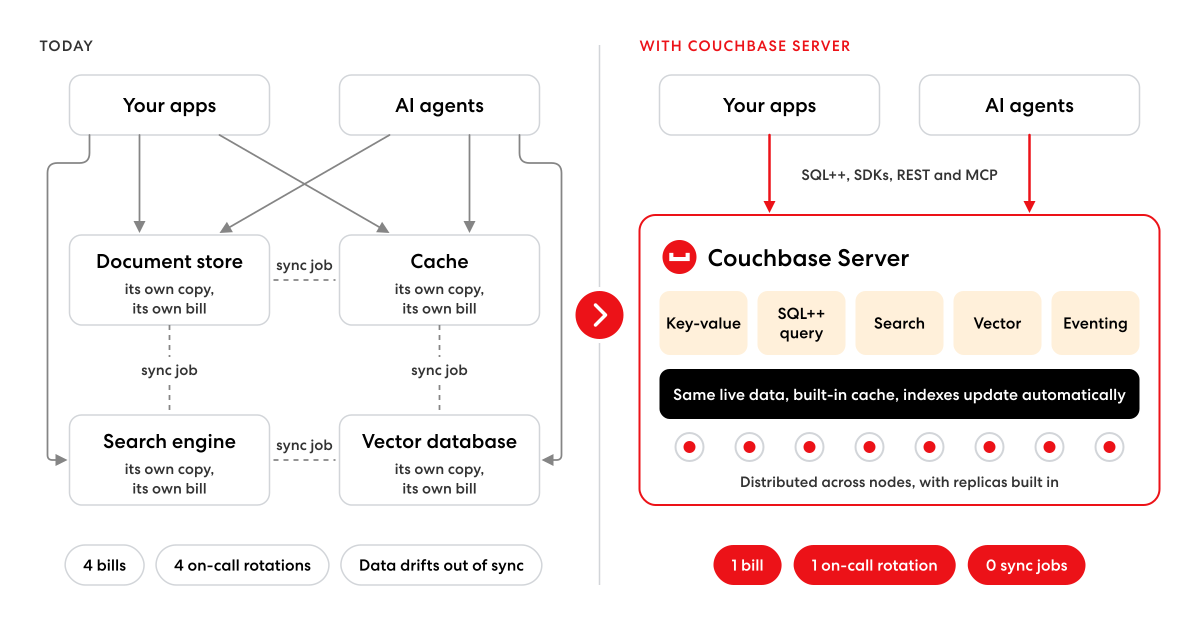
Die meisten Teams verfügen über einen Dokumenten-Store, einen Cache, eine Suchmaschine und eine Vektordatenbank sowie über die Synchronisierung zwischen diesen Komponenten. Couchbase Server verarbeitet alle vier Aufgaben mit den gleichen Live-Daten. Sie benötigen weniger Systeme zur Pflege, weniger Bereitschaftsdienste und keine Pipeline-Verfahren, die den Ablauf stören.
ARCHITEKTUR
Alle Transaktionen rechtzeitig abspeichern
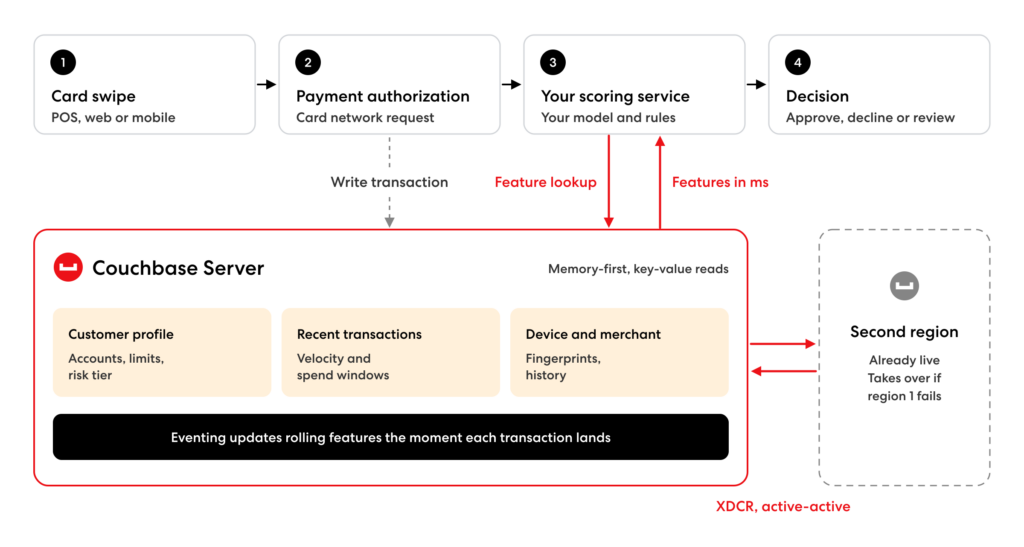
Betrugsmuster benötigen innerhalb von Millisekunden neue Funktionen, bevor die Karte den Schalter verlässt. Couchbase Server speichert diese in der Zwischenspeicherung, während Ihre Scoring-Software den Vorgang abwickelt. Wells Fargo prüft auf diese Weise 100% von seinen täglich verarbeiteten Transaktionen – mit einer Geschwindigkeit von unter 10 Millisekunden pro Operation.
CLOUD-MARKETPLATSEN
Den Beschaffungsmarathon umgehen
Die Couchbase Server Enterprise Edition ist auf den AWS-, Google Cloud- und Microsoft Azure-Marktplätzen verfügbar, sodass Sie sie über ein Cloud-Konto kaufen können, das bereits von Ihrem Unternehmen genehmigt wurde. Es gibt keine neuen Anbieter zu integrieren und keine separate Rechnung. Sie zahlen pro Stunde oder bringen Ihre eigene Lizenz mit, und berechtigte Einkäufe können zu Ihrem festgelegten Verbrauch bei diesem Anbieter addiert werden.
Dieselmotor gleicher Bauart, drei verschiedene Betriebsarten
Selbstverantwortung
Server
Starten Sie kostenlos mit der Community-Edition, die bis zu fünf Knoten mit jeweils vier Kernen und Community-Support unterstützt. Übersetzen Sie die Anwendung in die Enterprise-Edition für die Produktion: Keine Knotenbegrenzungen, aktiver-aktiver XDCR, Vektor-Suche, 24/7-Support und in 8.5 auch Point-in-Time-Recovery und unumschaffbare Backups.
MANAGED CLOUD
Capella
Capella ist die voll verwaltete Version von Couchbase Server, mit demselben Engine, das Ihre Apps, Caching, Suche und KI-Workloads betreibt. Couchbase übernimmt die Einrichtung, Backups, Skalierung und Upgrades auf AWS, Google Cloud und Azure, sodass Ihr Team Funktionen einbringt statt Cluster zu aktualisieren.
PRIVATE CLOUD
Kubernetes
Der Couchbase Autonomous Operator automatisiert die Bereitstellung, Skalierung, Upgrades und Backups auf Kubernetes, einschließlich OpenShift, EKS, AKS und GKE. Ihr Plattformteam verwaltet die Datenbank auf die gleiche Weise wie alle anderen Komponenten.
FAQs zum Couchbase Server
Antworten auf häufig gestellte Fragen zu Couchbase Server, Server 8.5 und zu dessen Vergleich zu Capella.
Teams verwenden Couchbase Server für Benutzerprofile, Katalogen, Sitzungsspeicher, Caching, Echtzeit-Betrugsprüfungen und KI-Apps, die Vektorgeschäftsdaten benötigen. Damit werden mehrere Datenbanken durch eine ersetzt.
Ja. Couchbase Server ist eine verteilte NoSQL-Datenbank, die JSON-Dokumente speichert. Es unterstützt außerdem SQL für JSON (SQL++), sodass Sie diese JSON-Daten mit Joins, Aggregaten und ACID-Transaktionen abfragen können.
Server 8.5 bietet Time-to-Point-Recovery, unveränderliche Backups, Verschlüsselung in allen Diensten, schnelleres Rebalance, hybride Suche und Chat-ähnliche Abfragen. Es steht in einer privaten Preview und soll im Januar 2027 in der GA-Version verfügbar sein.
Nein, aber sie verwenden denselben Server. Sie betreiben Couchbase Server selbst, entweder lokal oder in der Cloud. Couchbase stellt Capella als vollverwaltete Dienstleistung auf AWS, Azure und Google Cloud bereit.
Ja. Couchbase Server führt eine Vektor-Suche auf dieselben Live-Daten ab, wie sie in Ihren Apps verwendet werden. In 8.5 können Sie Schlüsselwörter und Vektor-Suche in einer SQL-Abfrage kombinieren.
Ja. Der Couchbase Autonomous Operator stellt Couchbase Server auf Kubernetes bereit, skaliert sie, aktualisiert sie und sichert sie ab, einschließlich OpenShift und verwalteter Dienste wie EKS, AKS und GKE.
Fortfahren mit der Erkundung
-
Couchbase Architektur unter der Haube
Wie sich Motor, Service und Wartung zueinander verhalten und warum das wichtig ist.
-
Was ist neu in Couchbase Server 8.5
Schnellere Skalierung, Wiederherstellung auf die zweite Ebene und hybride Suche in SQL++.
-
Interessiert? Beginnen Sie heute.
Lassen Sie uns heute darüber sprechen, wie Sie intelligenter für eine künstliche Intelligenz der Zukunft bauen können.