UNE BASE DE DÉTAILS POUR VOS APPLICATIONS ET VOS AGENTS DE L’IA
Serveur Couchbase
Couchbase Server est une base de données rapide pour vos applications et vos agents d'IA, sur site ou dans n'importe quel cloud. Vos clients ne doivent plus attendre des données lentes, et votre équipe n'a plus besoin de jongler avec quatre systèmes.
Arrêtez de payer pour des systèmes qui vous ralentissent
Chaque base de données supplémentaire ajoute un coût, un travail de synchronisation et une rotation des équipes de veille. Couchbase Server fait le travail de quatre systèmes, ce qui permet à votre équipe de travailler plus rapidement.
Rapidité lors de pics de trafic
Une conception orientée mémoire et un cache intégré permettent aux applications de fonctionner rapidement en période de trafic intense, de sorte que votre journée la plus chargée ne se transforme pas en votre pire panne.
Une seule base de données au lieu de quatre
Votre magasin de documents, votre cache, votre moteur de recherche et votre base de données vectorielle deviennent un tout. Un seul relevé de factures, une seule rotation de jour et de nuit, rien à synchroniser.
IA sans une autre base de données vectorielle
La recherche vectorielle et hybride s’appuie sur les données de votre application en cours d’exécution, de sorte que les réponses de l’IA proviennent de ce qui est vrai en ce moment, et non de la version d’hier soir.
Il s’adapte et reste en fonction
Ajoutez des nœuds pendant que votre application continue de fonctionner. Si un nœud tombe en panne, des répliques prennent le relais en quelques secondes. Vos clients ne le remarqueront même pas.
Qu'est-ce que Couchbase Server ?
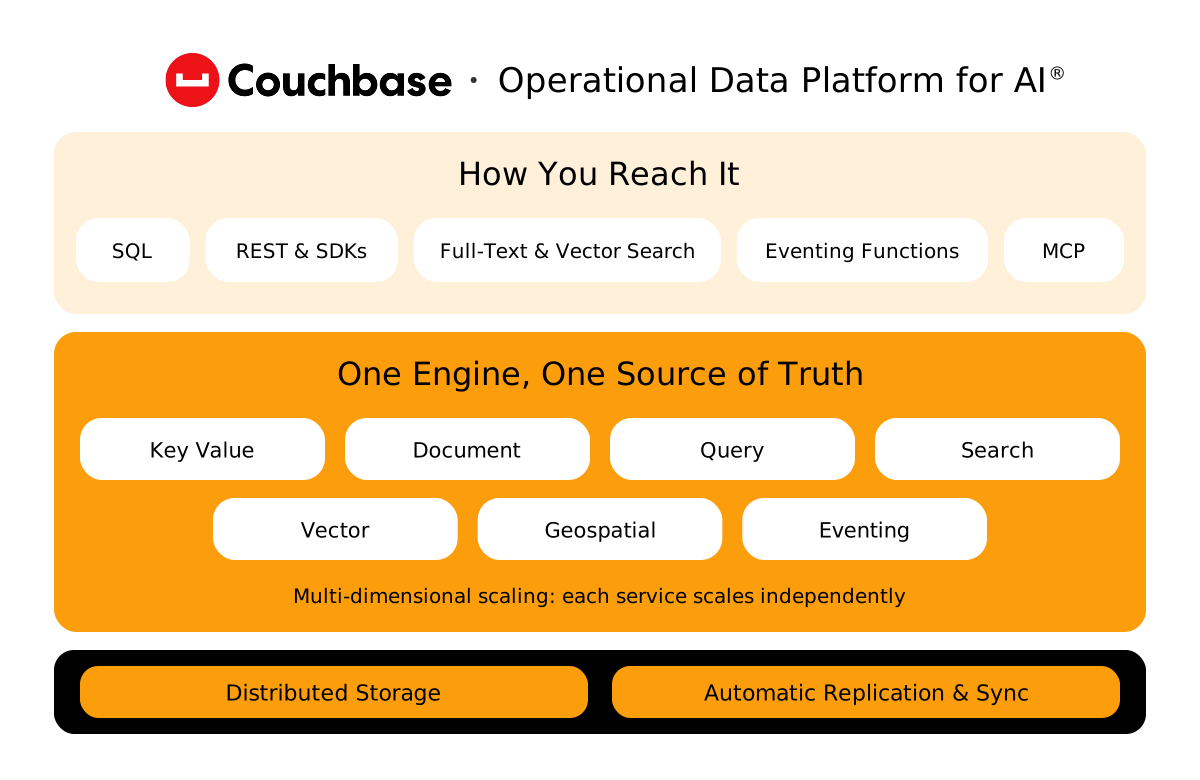
Couchbase Server est une base de données NoSQL distribuée qui stocke des données JSON et fournit des workloads clés-valeurs, SQL, de recherche et de vectorisation à partir d’un seul moteur.
Les recherches par clé-valeur, les requêtes SQL, la recherche de texte intégral, la recherche vectorielle et l’événementnalité sont toutes exécutées dans Couchbase Server sur les mêmes données, avec un cache intégré en amont. Les index sont mis à jour automatiquement au fur et à mesure que les documents changent, de sorte que vos applications et vos agents d’IA fonctionnent à partir d’une source unique de vérité. Il n’y a pas de tâches ETL entre les bases de données qui attendent d’être interrompues à 2 heures du matin.
SQL++ est SQL pour JSON. Toute personne qui connaît SQL peut écrire des joins, des sous-queries, des agrégats et des transactions ACID multi-documents à partir de documents JSON flexibles dès le premier jour. Vous bénéficiez de la flexibilité d'une base de données documentaires sans avoir à former votre équipe ou à embaucher pour un langage de requête propriétaire. Les développeurs peuvent également demander en langage simple et obtenir un retour en SQL.
Le scalage multidimensionnel vous permet de traiter les données, de réaliser des requêtes, d’indexer et de rechercher sur leurs propres nœuds. Lorsque le trafic de recherche atteint un pic, vous ajoutez des nœuds de recherche, pas une copie plus grande de tout. Le rééquilibrage se déroule pendant que votre application reste en ligne, de sorte que l’ajustement de la taille de la base de données n’entraîne pas de maintenance. Dans Server 8.5, il copie les fichiers de données entiers, environ 4 fois plus rapidement en moyenne dans des tests internes.
La réplication croisée des data centers (XDCR) permet aux clusters de n’importe quelle région ou cloud de réaliser des opérations de sauvegarde et de réplication dans les deux sens, résolvant automatiquement les conflits. En matière de souveraineté des données, des filtres déterminent quels documents doivent quitter une région, de sorte que les données réglementées restent dans le pays tout en faisant répliquer le reste. Si une région tombe en panne, il suffit de déplacer le trafic vers une autre qui est déjà opérationnelle.
Statistiques et critères de référence
<1ms
Lectures à faible latence grâce au cache intégré, même en période de pointe de demande
3.9x
une capacité de traitement plus élevée que celle d'une base de données de documents de premier plan, avec la même configuration BenchANT
RESULTATS CLIENTS
Confiance accordée aux applications qui ne peuvent pas tomber en panne


QUELQUES NOUVEAUTÉS EN 8.5
Tout ce dont vos applications ont besoin dans une seule base de données
Des capacités éprouvées, ainsi que de nouvelles fonctionnalités dans la version privée de Server 8.5.
- Échelle
- Protégez
- Recherche
- Gérer
- Connectez-vous
Augmentez la capacité en quelques minutes et intégrez davantage de locataires dans chaque cluster.
Principales capacités
Un rééquilibrage plus rapide
Rebalance copie désormais les fichiers de données entiers entre les nœuds plutôt qu'un document à la fois. Dans des tests internes, il a fonctionné en moyenne 4 fois plus rapidement. Dans des tests internes, il a fonctionné en moyenne 4 fois plus rapidement.
Mise à l'échelle multidimensionnelle
Effectuez des calculs de données, des requêtes, des indexations et des recherches sur vos propres nœuds. Ajoutez de la capacité uniquement là où une charge de travail en a besoin.
Limite de débit par cuve
Garantir un débit suffisant pour les workloads critiques comme les paiements et les tâches volumineuses comme les jobs batch afin que l’un des tenants ne puisse pas faire souffrir l’autre.
Chacun des éléments du disque doit être chiffré et restauré à la deuxième version, et non à celle d'hier soir.
Principales capacités
Récupération en temps réel
La sauvegarde continue envoie toutes les modifications vers le stockage toutes les deux minutes. La restauration se fait à la seconde suivant l’erreur, jusqu’à une seule collection.
Chiffrement natif en veille
La cryptage intégré couvre tous les services, ainsi que les journaux et les traces d’audit. Les clés restent dans votre gestionnaire de clés et sont renouvelées selon un calendrier prédéterminé.
Identité et secrets modernes
Utilisez les jetons JWT et l’authentification unique au lieu des mots de passe stockés. Un système de stockage de données de connexion conserve les clés pour le stockage dans le cloud et les modèles d’IA.
La recherche vectorielle, textuelle et hybride s’effectue sur vos données en temps réel, ce qui permet aux applications d’IA d’obtenir un contexte précis sans avoir besoin d’une base de données vectorielle distincte.
Principales capacités
Recherche vectorielle et textuelle
Effectuez une recherche de similitude et une recherche de texte intégral sur des données opérationnelles en temps réel, sans avoir besoin d’une base de données vectorielle distincte à synchroniser.
Recherche hybride dans SQL
Combinez la recherche par mots-clés et la recherche vectorielle, ou les vecteurs sparse et dense, et fusionnez les scores en une liste rangée, tout cela en SQL.
Demandez-le en termes simples
Parlez-en en termes simples et gardez le contexte lors de la discussion. Ajoutez vos termes commerciaux, comme par exemple ce que signifie le chiffre d’affaires net, pour obtenir des réponses plus précises.
Améliorez votre infrastructure sans surprises et consultez votre bassin de données sans ETL.
Principales capacités
Opérateur autonome
Automatiser le déploiement, l’échelle, les mises à jour et les sauvegardes sur Kubernetes, y compris OpenShift et les clouds gérés.
Exécution de requêtes sur les tables Apache Iceberg
Rassemblez en temps réel les données avec les tables Iceberg dans S3, Google Cloud Storage ou Microsoft Azure à partir d'une seule requête SQL. Pas de pipeline ETL, pas de copies.
Concours complet
Exécutez des fonctions JavaScript dès que des données changent, pour les alertes, l’enrichissement et les mises à jour ultérieures.
Répliquez sur plusieurs régions, clouds et appareils et maintenez les applications toujours actives.
Principales capacités
Réplication active-active
XDCR réplique les données entre les régions et les clouds dans les deux sens, de sorte que les applications restent opérationnelles lorsque la région tombe en panne.
Envoyer uniquement les modifications locales
Dans un réseau global, chaque cluster peut envoyer ses propres modifications une fois seulement, afin de réduire les coûts de transfert entre régions.
Synchronisation avec le mobile et le cloud
Sync Gateway permet de synchroniser les applications et les agents Couchbase Lite sur les appareils avec le cloud, afin qu'ils restent disponibles en permanence.
- Un moteur
- Fraude
ARCHITECTURE
Un moteur, pas quatre bases de données
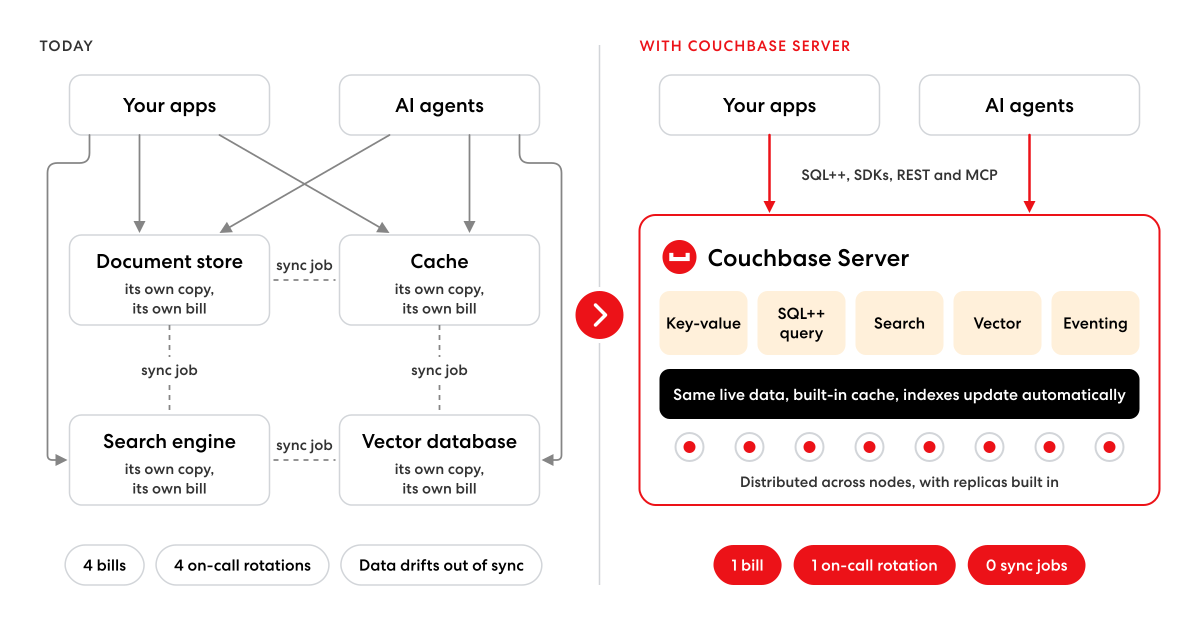
La plupart des équipes utilisent un magasin de documents, un cache, un moteur de recherche et une base de données vectorielle, ainsi que des tâches de synchronisation entre eux. Couchbase Server gère toutes ces tâches sur les mêmes données réelles. Vous n’avez donc besoin que de moins de systèmes à patcher, moins de rotations de personnel en service et aucun pipeline à gérer.
ARCHITECTURE
Gérer toutes les transactions en temps opportun
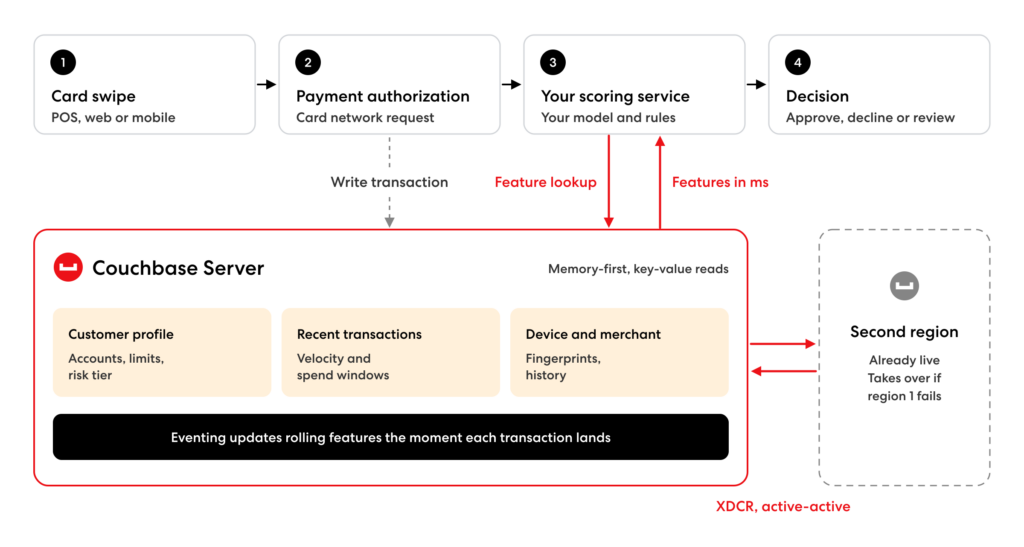
Les modèles de fraude nécessitent des fonctionnalités nouvelles en quelques millisecondes, avant que la carte ne quitte le guichet. Couchbase Server les fournit en mémoire, tandis que votre service de scoring effectue la requête. Wells Fargo vérifie 100% des 50 millions de transactions quotidiennes de cette manière, en moins de 10 ms par opération.
CLOUDS DE MARCHÉ
Évitez le marathon des achats
Couchbase Server Enterprise Edition est disponible sur les marketplaces AWS, Google Cloud et Microsoft Azure, vous pouvez donc l’acheter via un compte cloud déjà approuvé par votre entreprise. Il n’y a pas besoin de s’inscrire auprès d’un nouveau fournisseur et vous n’avez pas à payer de frais supplémentaires. Payer par heure ou apporter votre propre licence, et les achats admissibles pourront être pris en compte dans votre budget global avec ce fournisseur.
Même moteur, trois manières de l’utiliser
Autogestion
Server
Commencez gratuitement avec la Community Edition, qui peut gérer jusqu'à cinq nœuds avec quatre cœurs chacun et une prise en charge communautaire. Passez à l'Edition Enterprise pour une production : pas de limitation de nœuds, XDCR actif-actif, recherche vectorielle, support 24/7 et, dans la version 8.5, restauration en temps réel et sauvegardes immutables.
CLOUDS GÉRÉS
Capella
Capella est la version entièrement gérée de Couchbase Server, avec le même moteur qui gère vos applications, le cache, la recherche et les workloads d’IA. Couchbase s’occupe de la configuration, des sauvegardes, de l’échelle et des mises à niveau sur AWS, Google Cloud et Azure, de sorte que votre équipe puisse proposer des fonctionnalités plutôt que de mettre à jour les clusters.
CLOU PRIVÉ
Kubernetes
Le Couchbase Autonomous Operator automatise le déploiement, l’échelle, les mises à niveau et les sauvegardes sur Kubernetes, y compris OpenShift, EKS, AKS et GKE. Votre équipe de plateforme gère la base de données de la même manière qu’elle gère tout le reste.
FAQ sur Couchbase Server
Réponses aux questions fréquentes concernant Couchbase Server, Server 8.5 et sa comparaison avec Capella.
Les équipes utilisent Couchbase Server pour les profils d’utilisateurs, les catalogues, les magasins de sessions, le cachement, les vérifications en temps réel des fraudes et les applications d’IA nécessitant une recherche vectorielle sur des données en temps réel. Il remplace plusieurs bases de données par une seule.
Oui. Couchbase Server est une base de données NoSQL distribuée qui stocke des documents JSON. Elle prend également en charge SQL pour JSON (SQL++), ce qui vous permet de consulter ce JSON grâce à des joins, des agrégats et des transactions ACID.
Le serveur 8.5 ajoute la récupération en point de restauration, des sauvegardes immutables, le chiffrement de tous les services, un rééquilibrage plus rapide, une recherche hybride et des requêtes en mode chat. Il est en version privée d’essai, avec une sortie générale en janvier 2027.
Non, mais ils utilisent le même moteur. Vous pouvez utiliser Couchbase Server en interne ou dans n'importe quel cloud. Couchbase vous offre Capella en tant que service entièrement géré sur AWS, Azure et Google Cloud.
Oui. Couchbase Server exploite la recherche vectorielle sur les mêmes données en temps réel que vos applications. Dans 8.5, vous pouvez également combiner la recherche par mots clés et la recherche vectorielle dans une seule requête SQL.
Oui. Le Couchbase Autonomous Operator déploye, scale, met à jour et sauvegarde Couchbase Server sur Kubernetes, y compris OpenShift et des services gérés tels que EKS, AKS et GKE.
Continuez d'explorer
-
L'architecture Couchbase sous le capot
Comment les moteurs, les services et le stockage s’entremêlent et pourquoi cela importe.
-
Quels sont les nouveautés de Couchbase Server 8.5
Scalage plus rapide, récupération en second et recherche hybride dans SQL++.
-
Interessé ? Commencez dès aujourd'hui.
Parlons de la manière dont vous pouvez devenir plus intelligent pour préparer l’avenir de l’IA aujourd’hui.