UMA BÁSICA PARA OS SEUS APP E AGENTES DE IA
Couchbase Server
O Couchbase Server é um banco de dados rápido para seus aplicativos e agentes de IA, tanto em ambiente local quanto em qualquer nuvem. Os seus clientes deixam de esperar por dados lentos e a sua equipe deixa de ter que lidar com quatro sistemas diferentes.
Pare de pagar por sistemas que o atrasam
Cada banco de dados adicional adiciona uma fatura, um trabalho de sincronização e uma rotatividade de funcionários disponíveis para atendimento. O Couchbase Server realiza as funções de quatro sistemas, permitindo que sua equipe trabalhe com mais rapidez.
Rápido quando o tráfego aumenta
Um design baseado em memória e um cache integrado mantêm os aplicativos rápidos durante o pico de tráfego, para que o seu dia mais movimentado não se torne a pior situação de interrupção.
Uma base de dados em vez de quatro
O seu banco de dados de documentos, o cache, o mecanismo de pesquisa e a base de dados vetorial tornam-se um só. Um único recibo, uma mesma rotina de trabalho e nada a sincronizar.
IA sem outro banco de dados de vetores
A pesquisa vetorial e híbrida é executada com base nos dados da sua aplicação, portanto as respostas da IA são baseadas no que é verdade neste momento, não na cópia de ontem à noite.
Scala e permanece ativo
Adicione nós enquanto o seu aplicativo continua a funcionar. Se um falhar, as réplicas assumem o controle em segundos. Os seus clientes nem sequer percebem.
O que é o Couchbase Server?
O Couchbase Server é um banco de dados distribuído no formato NoSQL que armazena JSON e oferece serviços de cargas de trabalho de chave-valor, SQL, pesquisa e vetores a partir de um único mecanismo.
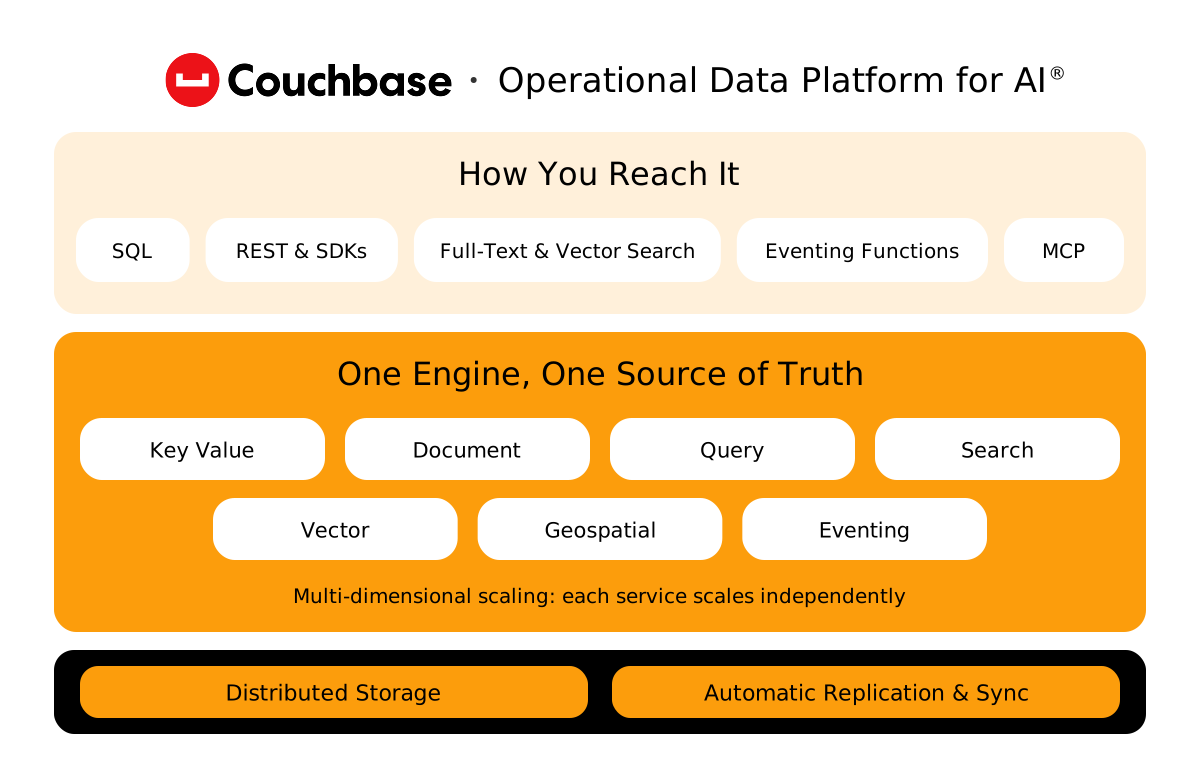
As consultas de chave-valor, consultas SQL, busca de texto completo, busca vetorial e eventos são todas executadas no Couchbase Server em relação aos mesmos dados, com um cache integrado na frente. As indexações são atualizadas automaticamente à medida que os documentos mudam, de modo que seus aplicativos e agentes de IA funcionem com uma fonte única de dados. Não há trabalhos de ETL entre bancos de dados aguardando para falhar às 2 da manhã.
O SQL++ é o SQL para JSON. Qualquer pessoa que conheça o SQL pode escrever joins, subqueryes, agregações e transações ACID em vários documentos usando documentos JSON flexíveis desde o primeiro dia. Você obtém a flexibilidade de uma base de dados documentada sem ter que reeducar sua equipe ou contratar um especialista em linguagem de consulta proprietária. Os desenvolvedores também podem perguntar em linguagem simples e receber respostas em SQL.
A escalabilidade multidimensional permite executar dados, realizar consultas, indexar e pesquisar em seus próprios nós. Quando o tráfego de busca aumenta, você adiciona nós de busca, não uma cópia maior de tudo. A rebalançoção é realizada enquanto o aplicativo permanece online, de modo que a escalabilidade não precisa de um período de manutenção. No Server 8.5, ela copia arquivos de dados inteiros, com uma média de cerca de 4x mais rapidez em testes internos.
A replicação cruzada de data centers (XDCR) permite que clusters em qualquer região ou nuvem realizem gravações e repliquem em ambas as direções, resolvendo automaticamente conflitos. Para garantir a soberania dos dados, filtros determinam quais documentos devem deixar uma região, de modo que os dados regulamentados permaneçam no país enquanto o restante é replicado. Se uma região falhar, mova o tráfego para uma região que já esteja operacional.
Estatísticas e benchmarks
<1ms
leitura de baixa latência a partir do cache integrado, mesmo em momentos de pico de demanda
3.9x
taxa de transferência mais alta do que uma base de dados de documentos líder de mercado, com a mesma configuração do BenchANT
RESULTADOS DOS CLIENTES
Confidencial por aplicativos que não podem ficar offline


O QUE É NOVO NA VERSÃO 8.5
Tudo o que seus aplicativos precisam de uma única base de dados
Capacidades comprovadas, além de novas funcionalidades na prévia privada do Server 8.5.
- Escala
- Proteja
- Pesquisa
- Gerenciar
- Conectar
Aumente a capacidade em minutos e acomode mais inquilinos em cada cluster.
Principais capacidades
Reequilíbrio mais rápido
O Rebalance agora copia todos os arquivos de dados entre os nós, em vez de um documento por vez. Em testes internos, ele rodou 4x mais rápido em média. Em testes internos, ele rodou 4x mais rápido em média.
Dimensionamento multidimensional
Executar dados, consultas, indexação e busca em seus próprios nós. Acrescentar capacidade apenas quando a carga de trabalho precisar.
Limite de volume de sacos
Garantia de desempenho para cargas de trabalho críticas, como checkout e cap, e para outras que geram ruído, como trabalhos em lote, para que um inquilino não possa privar o outro.
Encriptar tudo no disco e restaurar para o segundo, não para a noite passada.
Principais capacidades
Recuperação em um único ponto no tempo
O backup contínuo envia todas as alterações para o armazenamento com uma frequência de dois minutos. Restauração até o segundo antes de um erro, até uma única coleção.
Encriptação nativa em repouso
A criptografia integrada cobre todos os serviços, além de logs e rastreios de auditoria. As chaves ficam no seu gerenciador de chaves e são rotacionadas de acordo com um cronograma.
Identidade moderna e segredos
Use tokens JWT e autenticação única em vez de senhas armazenadas. Um banco de credenciais mantém chaves para armazenamento em nuvem e modelos de IA.
A pesquisa com vetores, texto e híbrida é executada nos seus dados existentes, de modo que os aplicativos de IA obtêm contexto preciso sem a necessidade de um banco de dados separado para vetores.
Principais capacidades
Pesquisa vetorial e de texto
Executar busca de semelhança e busca de texto completo em dados operacionais em tempo real, sem a necessidade de manter uma base de dados vetorial separada para manter a sincronia.
Pesquisa híbrida no SQL
Combine a busca por palavras-chave e por vetores, ou vetores esparsos e densos, e combine as pontuações em uma lista ordenada, tudo isso usando o SQL.
Pergunte de forma simples e direta
Pergunte de forma simples e mantenha o contexto durante toda a conversa. Adicione os termos da sua empresa, como o que significa a receita líquida, para obter respostas mais precisas.
Realize atualizações sem surpresas e consulte seu data lake sem ETL.
Principais capacidades
Operador autônomo
Automatize a implantação, a escalabilidade, as atualizações e os backups no Kubernetes, incluindo o OpenShift e os clouds gerenciados.
Consultar tabelas do Apache Iceberg
Combine dados em tempo real com tabelas do Iceberg no S3, no Google Cloud Storage ou no Microsoft Azure a partir de uma única consulta SQL. Sem pipeline de ETL, sem cópias.
Eventos
Executar funções JavaScript no momento em que os dados mudam, para alertas, enriquecimento e atualizações subsequentes.
Replicar em várias regiões, nuvens e dispositivos e manter os aplicativos sempre ativos.
Principais capacidades
Replicação ativa-ativa
O XDCR replica os dados em todas as regiões e nuvens em ambas as direções, de modo que os aplicativos continuem a funcionar quando uma região falha.
Enviar apenas as alterações locais
Em uma rede global, cada cluster só pode enviar suas próprias alterações uma vez, para reduzir os custos de transferência entre regiões.
Sincronização com dispositivos móveis e edge
O Sync Gateway mantém os aplicativos e agentes do Couchbase Lite sincronizados com a nuvem nos dispositivos, para que eles permaneçam sempre ativos.
- Um motor
- Fraude
ARQUITETURA
Um motor, não quatro bancos de dados
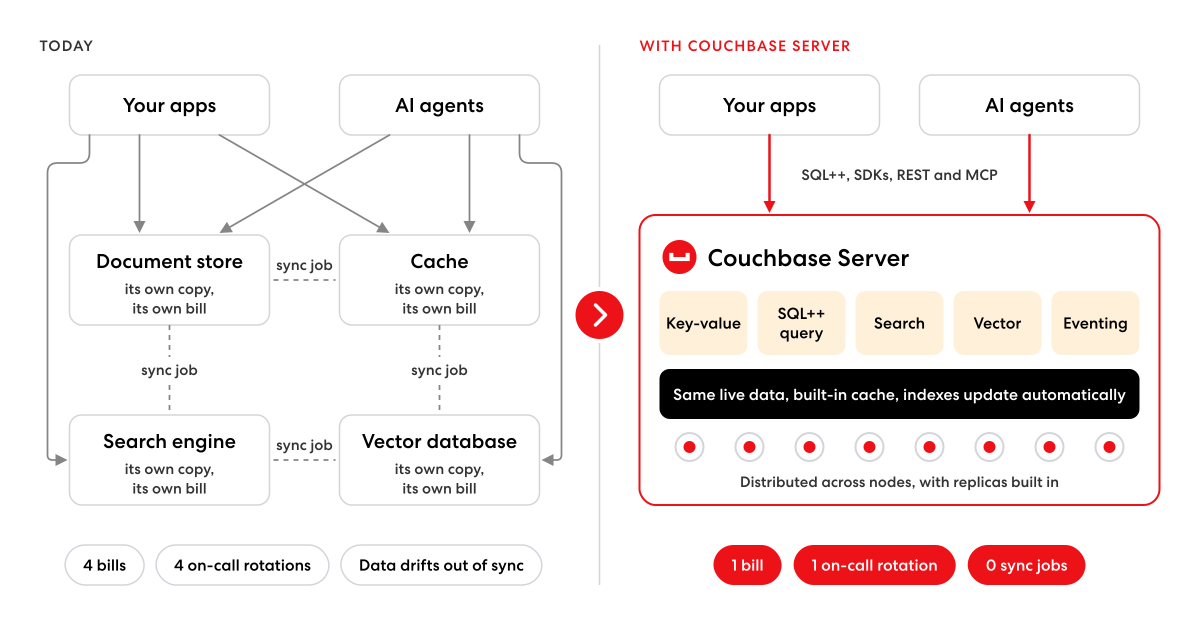
A maioria das equipes possui um armazenamento de documentos, um cache, um mecanismo de pesquisa e um banco de dados vetorial, além dos trabalhos de sincronização entre eles. O Couchbase Server executa todas as quatro cargas de trabalho com os mesmos dados em tempo real. Você dispõe de menos sistemas para atualização, menos rotas de trabalho e não há necessidade de pipelines para manter a continuidade dos processos.
ARQUITETURA
Registre todas as transações no prazo
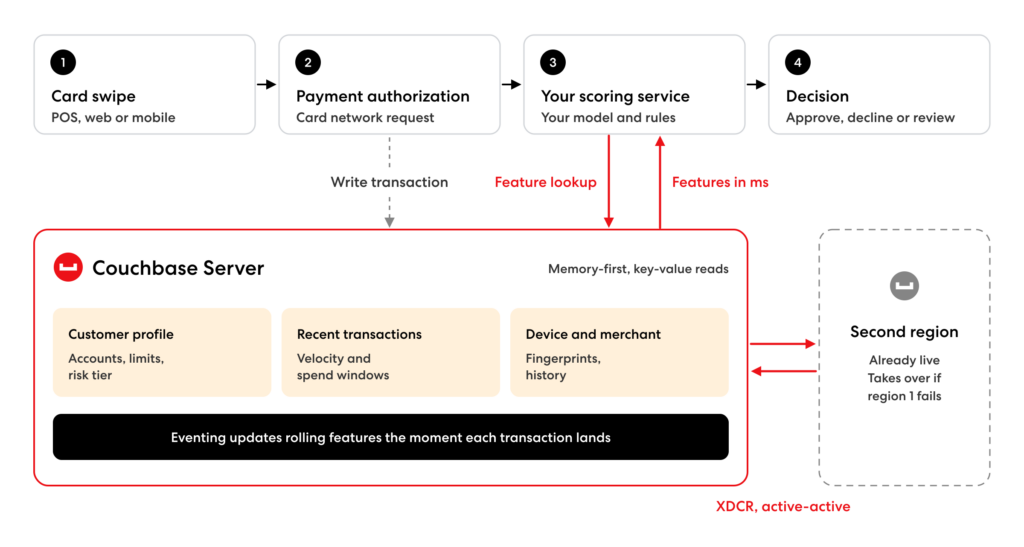
Os modelos de fraude precisam de funcionalidades atualizadas em milésimos de segundo, antes que o cartão saia do caixa. O Couchbase Server os fornece a partir da memória enquanto o seu serviço de pontuação realiza a consulta. A Wells Fargo verifica 100% das suas 50 milhões de transações diárias desta forma, em menos de 10 milissésimos por operação.
CLOUDS MARKETPLACES
Evite o maratona de contratações
A versão Enterprise do Couchbase Server está disponível nos marketplaces da AWS, do Google Cloud e do Microsoft Azure, portanto você pode comprá-la através de uma conta de nuvem que sua empresa já tenha aprovado. Não há necessidade de contratar um novo fornecedor e não há necessidade de emitir uma fatura separada. Pague por hora ou traga sua própria licença, e as compras elegíveis poderão ser contabilizadas no seu gasto comprometido com esse provedor.
Mesmo motor, três maneiras de o utilizar
AUTOMAÇÃO
Server
Comece gratuitamente com a Edição Community, que permite executar até cinco nós com quatro núcleos cada e suporte comunitário. Transfira para a Edição Enterprise para produção: sem limites de nós, XDCR ativo-ativo, busca vetorial, suporte 24/7 e, em 8.5, recuperação ponto-em-tempo e backups imutáveis.
CLOUDE GESTIONADO
Capela
Capella é a versão totalmente gerenciada do Couchbase Server, com o mesmo mecanismo executando suas aplicações, fazendo o cache, a busca e o processamento de inteligência artificial. O Couchbase cuida do setup, dos backups, do escalonamento e das atualizações no AWS, no Google Cloud e no Azure, de modo que sua equipe possa lançar novos recursos em vez de fazer patches nos clusters existentes.
CLOUDE PRIVADO
Kubernetes
O Couchbase Autonomous Operator automatiza o implantação, o dimensionamento, as atualizações e os backups no Kubernetes, incluindo o OpenShift, o EKS, o AKS e o GKE. A sua equipa de plataforma executa o banco de dados da mesma forma que tudo o resto.
Perguntas frequentes sobre o Couchbase Server
Respostas a perguntas comuns sobre o Couchbase Server, o Server 8.5 e como ele se compara ao Capella.
As equipes utilizam o Couchbase Server para perfis de usuários, catálogos, bancos de dados de sessões, armazenamento em cache, verificações de fraudes em tempo real e aplicativos de inteligência artificial que necessitam de busca vetorial em dados em tempo real. Isso substitui várias bases de dados por uma única.
Sim. O Couchbase Server é um banco de dados NoSQL distribuído que armazena documentos em formato JSON. Além disso, ele também suporta o SQL para JSON (SQL++), permitindo que você faça consultas nesse JSON usando junções, agregações e transações ACID.
O servidor 8.5 adiciona recuperação em um único ponto no tempo, backups imutáveis, criptografia em todos os serviços, rebalanceamento mais rápido, pesquisa híbrida e consultas no estilo de bate-papo. Ele está em pré-visualização privada e será lançado em janeiro de 2027.
Não, mas eles utilizam o mesmo motor. Você opera o Couchbase Server diretamente, em sua própria infraestrutura ou em qualquer nuvem. O Couchbase opera o Capella para você como um serviço totalmente gerenciado na AWS, no Azure e no Google Cloud.
Sim. O Couchbase Server executa a busca vetorial nos mesmos dados em tempo real que seus aplicativos. Na versão 8.5, você também pode combinar a busca vetorial e a busca por palavras-chave em uma única consulta SQL.
Sim. O Couchbase Autonomous Operator instala, dimensiona, atualiza e faz backup do Couchbase Server no Kubernetes, incluindo o OpenShift e serviços gerenciados como o EKS, o AKS e o GKE.
Continue explorando
-
Arquitetura do Couchbase sob o capô
Como o motor, os serviços e o armazenamento se complementam e por que isso é importante.
-
O que há de novo no Couchbase Server 8.5
Escalabilidade mais rápida, recuperação para a segunda posição e pesquisa híbrida no SQL++.
-
Interessado? Comece hoje mesmo.
Vamos conversar sobre como você pode se preparar melhor para o futuro da IA hoje mesmo.