UNA BASE DI DATI PER LE VOSTRE APP E I VOSI AGENTI AI
Couchbase Server
Couchbase Server è un database veloce per le tue app e gli agenti di intelligenza artificiale, sia in locale che in qualsiasi cloud. I tuoi clienti smetteranno di aspettare dati lenti, e il tuo team smetterà di dover gestire quattro sistemi.
Smetta di pagare per sistemi che vi rallentano
Ogni database aggiuntivo comporta un costo aggiuntivo, un lavoro di sincronizzazione e una rotazione dei turni di servizio. Couchbase Server gestisce tutti i compiti di quattro sistemi, così il tuo team lavora più velocemente.
Veloce quando il traffico aumenta
Un design orientato alla memoria e una cache integrata mantengono le applicazioni veloci durante i momenti di traffico intenso, così che il giorno più intenso non si traduca in un’interruzione del servizio più grave.
Una banca dati invece di quattro
Il vostro archivio dei documenti, la cache, il motore di ricerca e il database vettoriale diventano un tutt’uno. Un solo fattore di conto, una sola rotazione di servizio, niente da sincronizzare.
IA senza un altro database di dati
La ricerca vettoriale e quella ibrida vengono eseguite sui dati dell’app esistente, quindi le risposte dell’intelligenza artificiale derivano da ciò che è vero in questo momento, non dalla copia di ieri sera.
Scala in base alle esigenze e rimane acceso
Aggiungi nodi mentre la tua app continua a funzionare. Se uno di essi dovesse fallire, le repliche si prendono il controllo in pochi secondi. I tuoi clienti non se ne accorgeranno nemmeno.
Cos'è Couchbase Server?
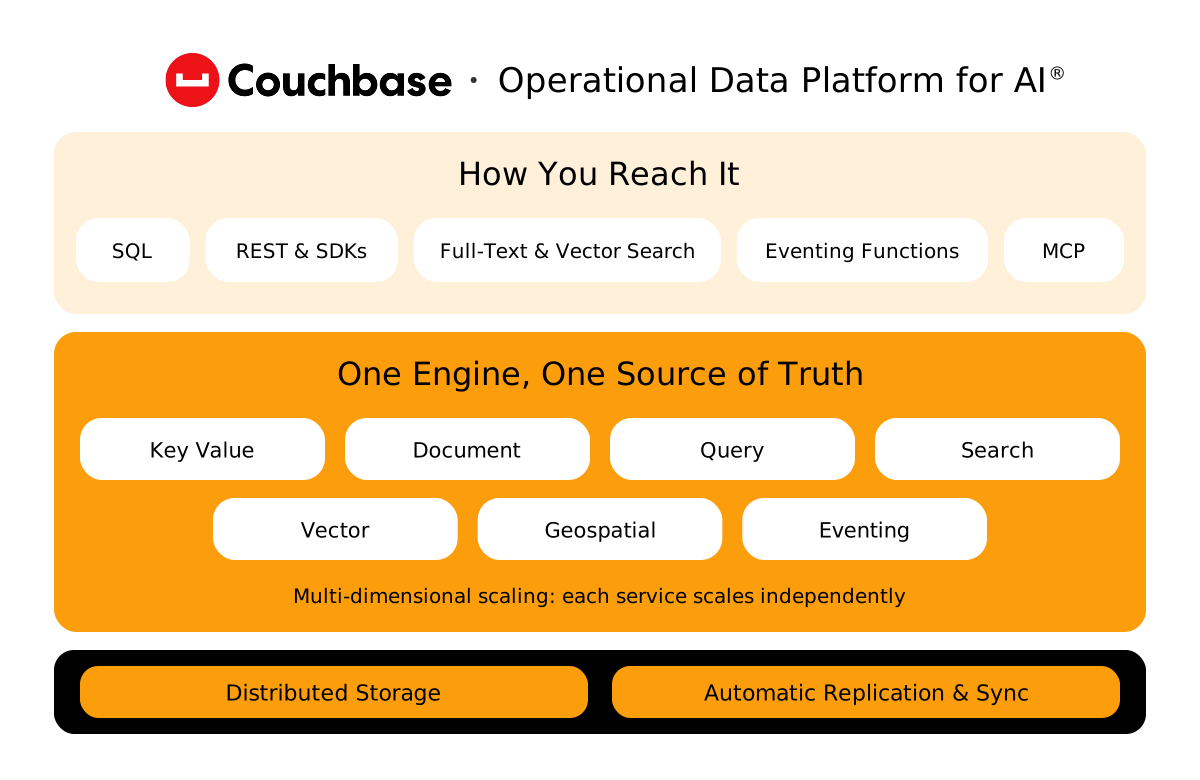
Couchbase Server è un database NoSQL distribuito che archivia i dati in formato JSON e gestisce workload di tipo chiave-valore, SQL, ricerca e vettoriali da un unico motore.
Le ricerche chiave-valore, le query SQL, la ricerca full-text, la ricerca vettoriale e l’eventing vengono tutte eseguite in Couchbase Server su dati identici, con un cache integrato in precedenza. Gli indici vengono aggiornati automaticamente in base ai cambiamenti dei documenti, così le tue app e gli agenti di intelligenza artificiale possono operare con una sola fonte di verità. Non ci sono processi ETL tra database in attesa di interruzioni alle 2 del mattino.
SQL++ è SQL per JSON. Chiunque conosca SQL può scrivere join, subquery, aggregati e transazioni ACID su documenti multipli in JSON già dalla prima giornata. Ottiene la flessibilità di un database documentale senza dover ricreare il team o assumere personale per sviluppare un linguaggio di query proprietario. Inoltre, gli sviluppatori possono chiedere in modo chiaro e comprensibile e ricevere risposte in SQL.
La scalatura multidimensionale consente di eseguire operazioni di elaborazione dei dati, query, indagine e ricerca sui propri nodi. Quando il traffico di ricerca aumenta, aggiungi dei nodi di ricerca, non una copia più grande di tutto. Il riequilibrio viene eseguito mentre l’app rimane online, quindi lo scaling non richiede un periodo di manutenzione. In Server 8.5 copia gli interi file di dati, in media circa 4 volte più velocemente nei test interni.
La replicazione trans-data center (XDCR) consente ai cluster di qualsiasi regione o cloud di effettuare gli invii e la replicazione in entrambe le direzioni, risolvendo automaticamente i conflitti. Per garantire la sovranità dei dati, i filtri decidono quali documenti lasciare in una determinata regione, così i dati regolamentati restano nel paese mentre il resto viene replicato. In caso di guasto di una regione, spostare il traffico su un altro che sia già attivo.
Statistiche e benchmark
<1ms
Letture a bassa latenza tramite la cache integrata, anche in caso di massima richiesta
3.9x
processo più veloce rispetto a un database di documenti leader del settore, stessa configurazione BenchANT
RISULTATI PER I CLIENTI
Contattato da app che non possono interrompersi


Cosa c’è di nuovo in 8.5
Tutto ciò di cui le vostre app hanno bisogno in un'unica banca dati
Capacità comprovate, oltre alle nuove funzionalità presenti nella preview privata di Server 8.5.
- Scala
- Proteggere
- Ricerca
- Gestire
- Connettersi
Aumentate la capacità in pochi minuti e inserite più locatari in ogni cluster.
Principali funzionalità
Rinquadro più veloce
Rebalance ora copia tutti i file di dati tra i nodi, anziché uno alla volta. In test interni, ha funzionato in media 4 volte più velocemente.In test interni, ha funzionato in media 4 volte più velocemente.
Scala multidimensionale
Eseguire il calcolo dei dati, le query, gli indici e le ricerche sui propri nodi. Aggiungere capacità solo quando è necessario per un carico di lavoro.
Limite di volume di spogliatura
Assicura un throughput elevato per workload critici come checkout e capi, mentre i workload rumorosi come i batch jobs non possono soffocare l'altro.
Crittografate tutto sul disco e recuperate quello del secondo giorno, non quello di ieri sera.
Principali funzionalità
Ripristino in un dato momento
Il backup continuo invia ogni modifica allo storage ogni due minuti. Il ripristino avviene al secondo dopo un errore, fino a una singola raccolta.
Encriptazione nativa in fase di quiescenza
La crittografia integrata copre tutti i servizi, oltre a registrare i log e i trail di audit. Le chiavi rimangono nel tuo gestore delle chiavi e vengono rinnovate secondo un programma definito.
Identità e segreti moderni
Utilizzare token JWT e l'autenticazione singola anziché le password memorizzate. Un repository di credenziali contiene le chiavi per lo storage nel cloud e i modelli di intelligenza artificiale.
La ricerca basata su vettori, testo e combinazione di entrambi viene eseguita sui dati in tempo reale, quindi le app basate sull’intelligenza artificiale dispongono di un contesto accurato senza la necessità di un database vettoriale separato.
Principali funzionalità
Ricerca vettoriale e testuale
Effettuare la comparazione e la ricerca full-text sui dati operativi in tempo reale, senza la necessità di un database vettoriale separato da mantenere sincronizzato.
Ricerca ibrida in SQL
Combinare la ricerca per parole chiave e quella per vettori, oppure vettori sparse e dense, e fondere le valutazioni in un elenco classificato, tutto in SQL.
Chiedete in modo semplice e chiaro
Chiedete in modo chiaro e semplice e mantenete il contesto durante la conversazione. Aggiungete i termini aziendali, come ad esempio cosa significa il fatturato netto, per ottenere risposte più accurate.
Aggiornamento senza sorprese e consultazione del data lake senza ETL.
Principali funzionalità
Operatore autonomo
Automatizza la distribuzione, l’espansione, gli aggiornamenti e i backup su Kubernetes, anche su OpenShift e cloud gestiti.
Query delle tabelle Apache Iceberg
Unire i dati in tempo reale alle tabelle Iceberg in S3, Google Cloud Storage o Microsoft Azure da una singola query SQL. Nessun pipeline ETL, nessun duplicato dei dati.
Eventi
Esegui le funzioni JavaScript nel momento in cui i dati cambiano, per avvisi, arricchimenti e aggiornamenti successivi.
Compatibilizzare le applicazioni su più regioni, cloud e dispositivi e mantenerle sempre attive.
Principali funzionalità
Replicazione attiva-attiva
XDCR replica i dati tra le regioni e i cloud in entrambe le direzioni, così le applicazioni continuano a funzionare anche quando una regione non funziona.
Invia solo le modifiche locali
In una rete globale, ogni cluster può inviare solo i propri cambiamenti, una sola volta, per ridurre i costi di trasferimento tra regioni.
Sincronizzazione con il dispositivo mobile e l'edge
Sync Gateway mantiene le app e gli agenti di Couchbase Lite sincronizzati con il cloud, per garantire un funzionamento sempre attivo delle applicazioni e degli agenti.
- Un motore
- Trattato di frode
ARCHITETTURA
Un motore, non quattro database
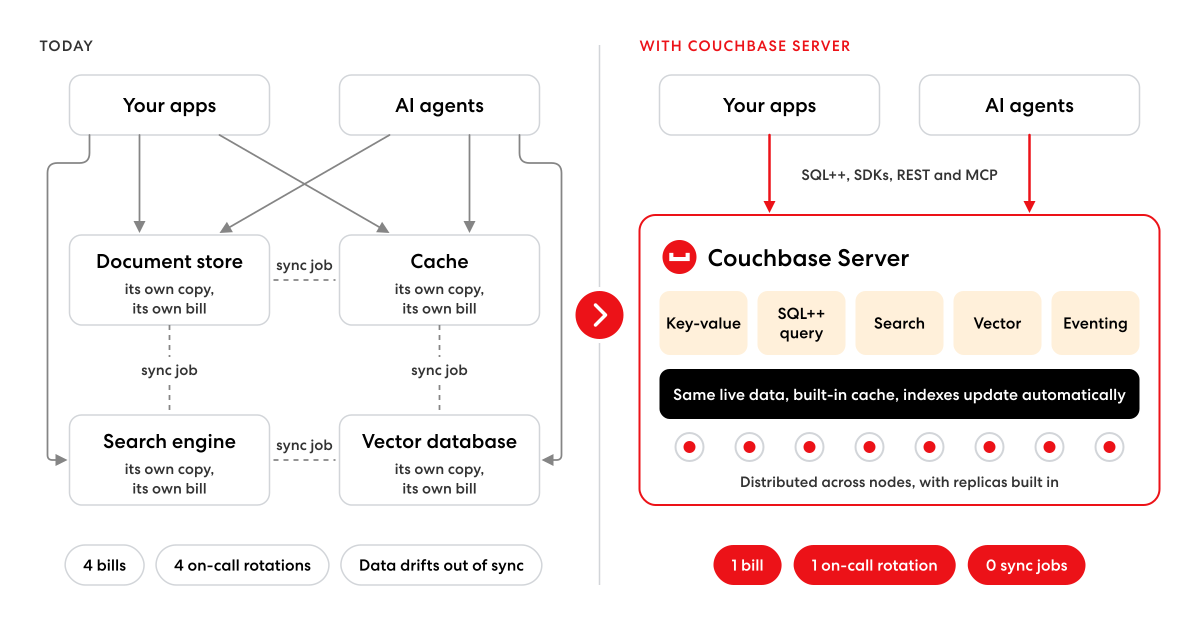
La maggior parte delle squadre gestisce un repository di documenti, un cache, un motore di ricerca e un database vettoriale, oltre ai processi di sincronizzazione tra questi. Couchbase Server gestisce tutti e quattro i workload sulla stessa base dati live. Si eliminano così i sistemi da patchare e i turni di disponibilità, oltre a non dover mantenere pipeline in funzione.
ARCHITETTURA
Registrare ogni transazione in tempo
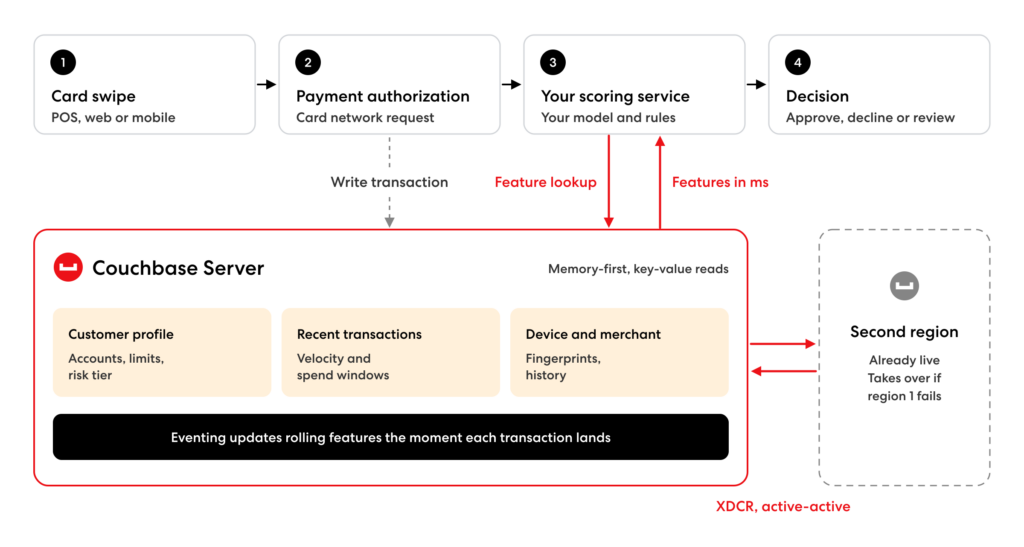
I modelli antifrode necessitano di funzionalità aggiornate in pochi millisecondi prima che la carta lasci il banco. Couchbase Server li fornisce dalla memoria mentre il vostro servizio di scoring effettua la chiamata. Wells Fargo controlla 100% delle sue 50 milioni di transazioni giornaliere in questo modo, in meno di 10 ms per operazione.
CLOUD MARKETPLACES
Evita il maratona delle procedure di appalto
Couchbase Server Enterprise Edition è disponibile sui marketplace AWS, Google Cloud e Microsoft Azure, quindi puoi acquistarlo tramite un account cloud già approvato dalla tua azienda. Non è necessario attivare un nuovo account e non è necessario un preventivo separato. Puoi pagare per ora lavorata o portare la tua licenza personale; gli acquisti ammissibili potranno essere conteggiati nel tuo consumo totale con quel provider.
Lo stesso motore, tre modi per usarlo
Autogestione
Server
Iniziare gratuitamente con la Community Edition, che consente di gestire fino a cinque nodi con quattro core ciascuno e supporto comunitario. Passare alla Enterprise Edition per la produzione: senza limiti di nodi, XDCR attivo-attivo, ricerca vettoriale, supporto 24/7 e, in 8.5, recovery in tempo reale e backup immutabili.
CLOUD MANEGGIATO
Capella
Capella è la versione completamente gestita di Couchbase Server, con lo stesso motore che gestisce le applicazioni, il caching, la ricerca e le attività di intelligenza artificiale. Couchbase gestisce l'installazione, i backup, l'espansione e gli aggiornamenti su AWS, Google Cloud e Azure, così il tuo team può rilasciare nuove funzionalità anziché patchare i cluster.
CLOUDS PRIVATI
Kubernetes
Couchbase Autonomous Operator automatizza la distribuzione, la scalabilità, gli aggiornamenti e i backup su Kubernetes, inclusi OpenShift, EKS, AKS e GKE. Il team della vostra piattaforma gestisce il database allo stesso modo in cui gestisce tutto il resto.
Domande frequenti su Couchbase Server
Risposte alle domande più frequenti relative a Couchbase Server, Server 8.5 e al modo in cui si differenzia da Capella.
Le squadre utilizzano Couchbase Server per i profili degli utenti, i cataloghi, i database delle sessioni, il caching, i controlli antifrode in tempo reale e le app di intelligenza artificiale che necessitano di ricerca vettoriale sui dati in tempo reale. Questo sistema sostituisce diverse database con un unico.
Sì. Couchbase Server è un database NoSQL distribuito che memorizza documenti JSON. Inoltre supporta SQL per JSON (SQL++), quindi è possibile effettuare query su quel JSON tramite union, aggregazioni e transazioni ACID.
Server 8.5 aggiunge il recovery point-in-time, i backup immutabili, la crittografia su tutti i servizi, un riequilibrio più veloce, la ricerca ibrida e le query in stile chat. È in anteprima privata e sarà disponibile in GA nel gennaio 2027.
No, ma utilizzano la stessa piattaforma. Puoi gestire Couchbase Server in locale o in cloud. Couchbase gestisce Capella per te come servizio completamente gestito su AWS, Azure e Google Cloud.
Sì. Couchbase Server esegue la ricerca vettoriale sui dati in tempo reale utilizzati dalle tue app. In 8.5 è possibile combinare la ricerca vettoriale e quella per parole chiave in una stessa query SQL.
Sì. Il Couchbase Autonomous Operator consente di distribuire, scalare, aggiornare e eseguire il backup di Couchbase Server su Kubernetes, inclusi OpenShift e servizi gestiti come EKS, AKS e GKE.
Continuate a esplorare
-
L'architettura di Couchbase sotto il cofano
Come si integrano il motore, i servizi e lo spazio di archiviazione e perché ciò è importante.
-
Cosa c’è di nuovo in Couchbase Server 8.5
Scalabilità più veloce, recupero al secondo livello e ricerca ibrida in SQL++.
-
Interessato? Comincia oggi stesso.
Parliamo di come costruire una strategia più intelligente per un futuro basato sull’intelligenza artificiale, oggi stesso.