WARUM NOSQL?
NoSQL erklärt: Was es ist, wie es funktioniert und warum es wichtig ist
NoSQL-Datenbanken bieten Skalierbarkeit, Flexibilität und hohe Performance für moderne Anwendungen. Sie verarbeiten unstrukturierte Daten, unterstützen horizontale Skalierung und eliminieren komplexe ORM-Schichten. Ideal für KI, Big Data und Echtzeit-Analysen ermöglicht NoSQL Agilität und schnelleres Entwickeln.
Übersicht: NoSQL-Struktur und Schlüsselkonzepte
Um besser zu verstehen, wie NoSQL-Datenbanken funktionieren, werden auf dieser Seite folgende Themen behandelt:
- Was ist eine NoSQL-Datenbank?
- Was ist der Unterschied zwischen SQL und NoSQL?
- Typen von NoSQL-Datenbanken
- Warum NoSQL verwenden?
- NoSQL-Tutorial
- Warum relationalen Datenbanken Grenzen gesetzt sind
- Schlussfolgerung
Was ist eine NoSQL-Datenbank?
Eine NoSQL-Datenbank, kurz für “not only SQL (Structured Query Language)”, ist eine nicht-relationale Datenbank, die darauf ausgelegt ist, vielfältige und flexible Datenstrukturen zu verarbeiten. Die NoSQL-Definition bezieht sich auf Datenbanken, die mehrere Modelle unterstützen – darunter Dokument-, Graph-, Schlüssel-Wert-, breite-Spalten- und Vektor-Speichereinheiten –, was eine größere Skalierbarkeit und Anpassungsfähigkeit im Vergleich zu traditionellen SQL-Datenbanken, die auf strukturierten Tabellen und festen Schemata basieren, bietet.
Die Bedeutung von NoSQL hat sich mit der Entwicklung von CPUs, RAM, Cloud-Computing und KI-Interaktionen weiterentwickelt und ermöglicht es modernen Datenbanken, große Echtzeit-Datensätze effizient zu verwalten. horizontale Skalierung Und was die Performance betrifft, sorgen NoSQL-Datenbanken für eine nahtlose Datenverteilung über mehrere Knotenpunkte, was sie zu der bevorzugten Wahl für KI, Big Data und Echtzeitanalysen macht, wo herkömmliche Datenbanken oft nicht mehr mithalten können.
ZUSAMMENFASSUNG
NoSQL bezieht sich auf Datenbanken, die Daten in flexiblen Formaten speichern, beispielsweise in Form von Dokumenten, Schlüssel-Wert-Speichern oder Vektordatenbanken. Ihre Skalierbarkeit und Leistungsfähigkeit machen sie ideal für moderne Anwendungen, die Echtzeitzugriff erfordern und große dynamische Workloads verarbeiten müssen.
Was ist der Unterschied zwischen SQL und NoSQL?
SQL- und NoSQL-Datenbanken Sie unterscheiden sich in der Art und Weise, wie sie Daten speichern und abfragen.. SQL-Datenbanken verlassen sich auf Tabellen mit Spalten und Zeilen, um strukturierte Daten abzurufen und zu schreiben, während NoSQL-Datenbanken flexible Datamodelle verwenden, die besser für unstrukturierte und halbstrukturierten Daten geeignet sind.
SQL, Die SQL-Datenbanken wurden erstmals in den 1970er Jahren eingeführt und werden heute weltweit von Entwicklern und Datenanalysten eingesetzt, um Daten in relationalen Systemen zu finden und zu berichten. SQL-Datenbanken eignen sich ideal für Anwendungen, die Integrität der Daten erfordern und strukturierte Beziehungen sowie standardisierte Abfragen verwenden (z. B. Software für die Unternehmensressourcenplanung). Obwohl NoSQL Der Begriff existiert seit den 1960er Jahren; er wurde erstmals Anfang der 2000er Jahre geprägt, da es für Entwickler von entscheidender Bedeutung wurde, Datenbanken zu verwenden, die in der Lage sind, Daten für Echtzeit-Anwendungen zu speichern und abzurufen.
Es ist anzumerken, dass SQL sich erweitert hat, um NoSQL-Zugriffsmodelle zu unterstützen. So unterstützen viele relationalen Datenbanken JSON (JavaScript Object Notation) als Datentyp. Einige Datenbanken haben sogar SQL erweitert, um direkt auf JSON-Strukturen zuzugreifen, darunter Couchbase, die SQL++ (SQL für JSON) unterstützt.
ZUSAMMENFASSUNG
Der Unterschied zwischen SQL- und NoSQL-Datenbanken liegt in ihrer Struktur und ihren Einsatzbereichen. SQL-Datenbanken verwenden Tabellen, was sie ideal für Anwendungen macht, die eine feste Struktur und normalisierte Daten benötigen. Im Gegensatz dazu verwenden NoSQL-Datenbanken flexible Modelle, was sie für die Verarbeitung unstrukturiertem und semistrukturierten Daten besser geeignet macht und gleichzeitig einen Echtzeitzugriff ermöglicht.
Typen von NoSQL-Datenbanken
Dies sind die beliebtesten Typen von NoSQL-Datenbankzugriffsmustern:
- Key-value-Speicher Gruppenverknüpfte Daten werden in separaten Tabellen gespeichert, wobei die Datensätze durch eindeutige Schlüssel identifiziert werden, um eine einfache Suche zu ermöglichen. Sie verfügen über die notwendige Struktur, um die Werte relationaler Datenbanken zu reproduzieren, und bieten gleichzeitig die Vorteile einer NoSQL-Datenzugriffsstruktur in Bezug auf Leistung und Zugänglichkeit. Schlüssel-Wert-Daten können leicht in einer Zwischenspeicherung gespeichert werden, wobei Daten, die häufig abgerufen werden, in der RAM-Speicherung für schnelle Lesevorgänge aufbewahrt werden. Schreib-, Aktualisierungs- und neue Leseanforderungen werden programmatisch an die persistenten Speicherorte weitergeleitet. Schlüssel-Wert-Speichersysteme legen den Fokus auf atomaren Zugriffsschnelligkeit vor Konsistenz, Isolation und Haltbarkeit.
- Dokumentendatenbanken Speichern sie Informationen hauptsächlich als logische Dokumente, einschließlich JSON-Dokumenten. Diese Systeme können beispielsweise auch XML-Dokumente oder binäre Objekte speichern. Aufgrund der flexiblen Struktur des Formats und der Kontrolle, die sie Entwicklern bietet, werden Dokumentenbanken bei der Entwicklung datengetriebener Anwendungen bevorzugt.
- Breite-Spalten- und Säulendatabases Daten in einem Speicher speichern Spalten statt Zeilen, das die Suchleistung für analytische Workloads und die Verarbeitung großer Datenmengen optimiert. Wie Schlüssel-Wert-Datenbanken haben auch breite Spaltendatenbanken eine grundlegende NoSQL-Struktur, die gleichzeitig Flexibilität, Datenverarbeitung und Aggregationsfunktionen beibehält.
- Suchdatenbanken Erlaubt es Benutzern, semi-strukturierten und unstrukturierten Daten wie Webseiten, Dokumenten, Karten, JSON- und XML-Dateien nachzuschlagen. Sie nutzen spezielle invertierte Indizes, um Schlüsselwörter innerhalb von Texten zu finden und relevante Daten zu finden – ähnlich wie man im Internet “googelt”.
- Graph-Datenbanken Verwenden Sie Graphenstrukturen wie Knoten, Kanten und Eigenschaften, um die Beziehungen zwischen gespeicherten Datenelementen zu definieren. Graphendatenbanken eignen sich besonders gut zur Identifizierung von Beziehungsmustern in unstrukturiert und Halbstrukturierte Informationen, die Erstellung von sozialen Netzwerken, Bauteile, Organisationsstrukturen und Ontologien. Graphbasiskataloge werden stark in Empfehlungssystemen, der Erkennung von Betrugsmustern, in vorausschauenden KI-Funktionen und der Verknüpfung sozialer Netzwerke eingesetzt.
- Zeitreihendatenbanken Erlauben Sie Benutzern, Datenänderungen im Laufe der Zeit zu verfolgen und Anomalien in Aktienkursdiagrammen, Maschinenprotokollen, Gesundheitsüberwachungsgeräten und Alarmsystemen zu erkennen. Da Zeitreihendaten schnell ändern, generieren diese Datenbanken enorme Datenmengen, was potenziell Skalierungsprobleme mit sich bringen kann.
- Vektordatenbanken Hilft bei der Verbesserung der Genauigkeit generativer KI-Modelle, indem Hinweise (Vektoren) bereitgestellt werden, die Hilf ihnen, die “richtigen” Antworten zu finden In ihren Trainingsdaten. Vector-Datenbanken arbeiten in Verbindung mit Retrieval-Augmented-Generation (RAG)-Prozessen, um Vektor-Integritäten zu speichern, die dazu beitragen, generative KI-Halbwahrheiten zu reduzieren und den Fortschritt des Modells zu gewährleisten.
ZUSAMMENFASSUNG
Beliebte NoSQL-Datenzugriffsmodelle umfassen Schlüssel-Wert-Stores, Dokumentenbasen, breite-Spalten- und Säulendatenbanken, Suchdatenbanken, Graphdatenbanken, Zeitreihendatenbanken und Vektordatenbanken. Jede dieser NoSQL-Typen weist einzigartige Eigenschaften auf, wie Skalierbarkeit, Schemaflexibilität und Abfragenleistung. Sie sollten diese in vollem Umfang erkunden, um zu entscheiden, welche NoSQL-Datenbank verwendet werden soll.
Warum NoSQL verwenden?
Unternehmen bevorzugen NoSQL-Datenbanken aufgrund ihrer Fähigkeit, große Datenmengen mit unterschiedlichen und wachsenden Datenbeständen zu verwalten. Besonderen Vorteilen von NoSQL-Datenbanken sind:
- Skalierbarkeit: NoSQL-Datenbanken skalieren horizontal, indem sie Daten auf mehrere Server verteilen, was sie ideal für große Workloads macht.
- Flexibilität: Im Gegensatz zu relationalen Datenbanken ermöglicht NoSQL schemaloses Datenspeichern, wodurch das Speichern und Verwalten unstrukturierter oder halbstrukturiertem Daten einfacher wird.
- Hohe Leistung: Optimiert für schnelle Lese- und Schreibgeschwindigkeiten reduzieren NoSQL-Datenbanken die Abfragenkomplexität und verbessern die Reaktionszeiten für Echtzeit-Anwendungen.
- Verschiedene Datenmodelle: NoSQL-Datenbanken bevorzugen Schlüssel-Wert-, Dokument-, breite-Spalten-, Such- und Zeitreihendatenmodelle, was sie ideal für mehrere Einsatzfälle macht.
- Big Data und Echtzeit-Verarbeitung: NoSQL wurde entwickelt, um massive Datenmengen zu verarbeiten, was es ideal für Big Data-Analytik, IoT, Caching und Sitzungshaltung.
- Cloud- und verteiltes Computing: NoSQL-Datenbanken funktionieren in Cloud-Umgebungen gut, da sie eine hohe Verfügbarkeit und Fehlertoleranz über verteilte Systeme gewährleisten.
- Einfachere Entwicklung und Iteration: Mit NoSQL können Entwickler die vorhandenen SQL-Kenntnisse nutzen und eine Datenbank verwenden, die mit vertrauten Tools integriert ist., integrierte Entwicklungsumgebungen (IDE), und Frameworks.
Die vielseitige NoSQL-Datenbank von Couchbase eignet sich besonders gut für KI-Anwendungen, da sie Folgendes bietet:
1. Hohe Leistung und geringe Latenzzeit
- Architektur mit dem Fokus auf Speicher: Verwendet ein verteiltes Speicherkonzept zur schnellen Les- und Schreibgeschwindigkeit und reduziert so die Latenzzeit der Algorithmus-Inferenz.
- Antwortzeiten von unter Millisekunde: Sorgt für Echtzeitdatenzugriff, was für Anwendungsfälle wie Empfehlungssysteme, Betrugserkennung und Predictive Analytics.
2. Skalierbarkeit und verteilte Architektur
- Mehrdimensionaler Skalieren: Kann horizontal oder vertikal skalieren, um massive KI-Datensätze und wachsende Arbeitslasten zu verarbeiten.
- Cross Data Center Replication (XDCR): Unterstützt die Bereitstellung von KI-Lösungen in mehreren Regionen und Cloud-Umgebungen mit hoher Verfügbarkeit.
3. Mehrmodulige und flexible Datenspeicherung
- JSON-basierte NoSQL-Datenbank: Speichert unstrukturierte und halbstrukturierten Daten, die für die Verarbeitung vielfältiger Datensätze in KI-Anwendungen unerlässlich sind.
- Unterstützung für Vektor-Suche: Hilft Entwicklern, Apps mit Vektor-Suche zu erstellen und ist mit anderen Systemen integrierbar. LangChain und LlamaIndex.
4. Eingebaute KI- und Analysefunktionen
- SQL für JSON (SQL++): Abfragen nach SQL-ähnlichen Strukturen mit Indexierung, Volltextsuche und Analysen für die Schulung und das Auswerten von KI-Modellen.
- Eventing und Stream-Verarbeitung: Ermöglicht Real-time-KI-Analysen mit integrierten Funktionen und einer Ereignisgesteuerten Architektur.
- Integration mit KI-/ML-Frameworks: Funktioniert mit TensorFlow, PyTorch und Apache Spark zur Schulung und Bereitstellung von KI-Modellen.
5. Implementierung von Multicloud- und Edge-AI
- Multicloud-Umgebung: Die Plattform läuft auf Amazon Web Services (AWS), Microsoft Azure und Google Cloud, sodass Entwickler KI-Anwendungen in der Cloud ihrer Wahl entwickeln und bereitstellen können.
- Unterstützung für Edge-Computing: Ideal für Echtzeit-KI-Anwendungen auf mobilen Geräten und in IoT-Systemen, da sie die Abhängigkeit von der Cloud verringern und die Reaktionszeiten verbessern.
6. Sicherheit und Compliance
- Sicherheit auf Unternehmensniveau: Eingebauter Verschlüsselung, rollenbasierter Zugriffskontrolle (RBAC) und Einhaltung von Vorschriften wie GDPR, HIPAA und SOC 2.
- Datenschutz und Governance: Unterstützt die KI-gestützte Überwachung der Compliance und die Erkennung von Betrug.
7. Kosteneffizienz
- Hohe Leistung zu einem niedrigeren Preis: Verringert die Kosten der Cloud-Infrastruktur, indem Ressourcen effizient verwaltet und die Datenübertragung minimiert wird.
- Multimodale Datenbank: Es ermöglicht Entwicklern, mehrere Datentypen zu speichern und zu abfragen, wodurch die Notwendigkeit zusätzlicher Datenbanken reduziert und potenzielle Integrationskosten, Lizenzgebühren und Ausgaben für die Cloud eingespart werden.
Zu den spezifischen Anwendungsfällen für KI-Anwendungen mit Couchbase gehören:
- Persönliche Empfehlungen: E-Commerce und Streaming-Dienste
- Betrugserkennung und Risikobewertung: Banking und Cybersicherheit
- Chatbots und agentische KI: Kundensupport und virtuelle Assistenten
- IoT und edge AI: Smart-Geräte und autonome Systeme
ZUSAMMENFASSUNG
Unternehmen bevorzugen NoSQL-Datenbanken aufgrund ihrer Flexibilität, Skalierbarkeit und hoher Performance beim Umgang mit großen Datenmengen in unterschiedlichen Formaten. Darüber hinaus nutzen NoSQL-Datenbanken horizontale Skalierung, indem Daten auf mehreren Servern verteilt werden, um die Performance bei steigender Belastung aufrechtzuerhalten. Diese Funktionen machen sie ideal für KI-Anwendungen, IoT-Systeme sowie adaptive Felddienstleistungen sowie für die Speicherung von Daten und die Verwaltung von Sitzungen.
Global 2000-Unternehmen greifen schnell auf NoSQL-Datenbanken zurück, um ihre missionkritischen Anwendungen zu betreiben:
-
"Wir haben festgestellt, dass die Replikationstechnologie für Couchbase über die Rechenzentren hinweg überlegen ist, insbesondere bei großen Workloads."
Claus Moldt, CIO, FICO<1ms
Reaktionszeiten

-
"Mit weniger als der Hälfte der Server können wir die Leistung steigern und erhalten eine wesentlich besser skalierbare Architektur."
Amir Ish-Shalom, Leitender Direktor für Betrieb, Viber15B
Anruf- und Nachrichtenereignisse/Tag

-
"Couchbase ist ein hochskalierbarer verteilter Datenspeicher, der eine entscheidende Rolle in unseren Caching-Systemen spielt."
Michael Kehoe, Sr. Staff Site Reliability Engineer, LinkedIn10M+
Abfragen pro Sekunde

-
"Boxen der Enterprise-Klasse kosten eine Menge Geld. Wir können mit handelsüblicher Hardware skalieren und hochverfügbar sein."
Thomas Vidnovic, Lösungsarchitekt, Marriott International4K
Transaktionen pro Sekunde

NoSQL-Tutorial
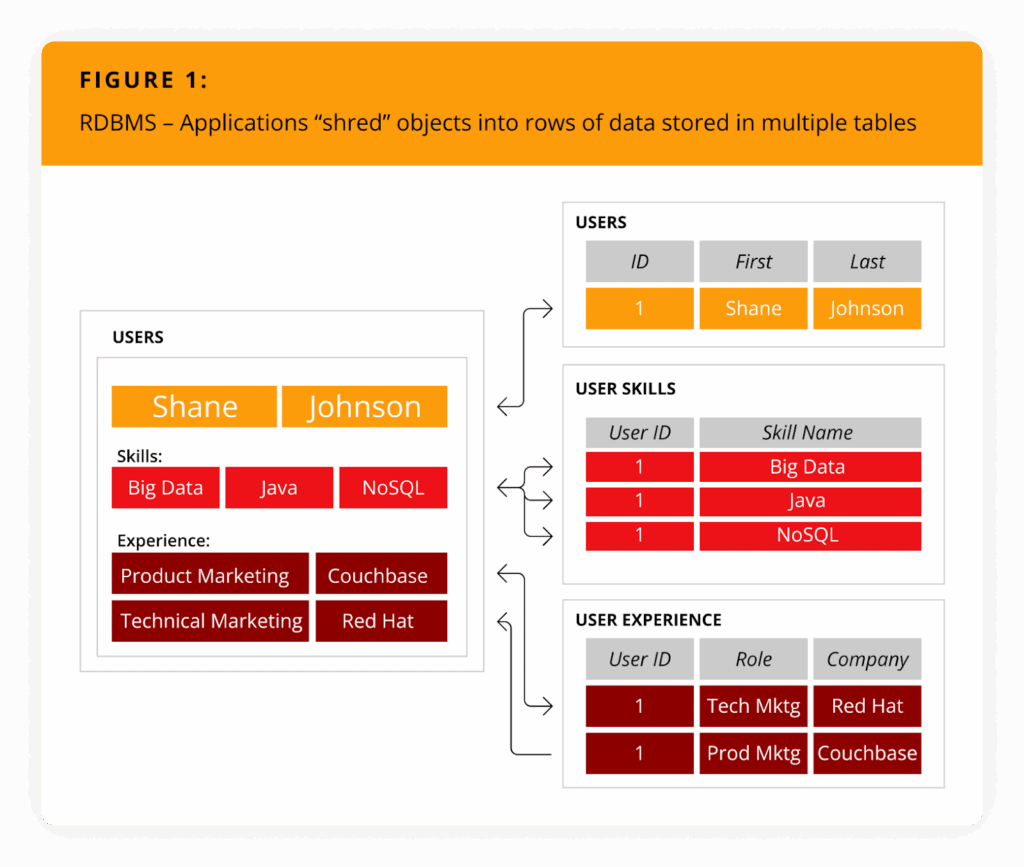
Wie vergleicht sich NoSQL mit relationalen Datenbanken? Lassen Sie uns genauer hinschauen. In dem folgenden Tutorial wird eine NoSQL-Anwendung vorgestellt, die zur Verwaltung von Lebensläufen verwendet wird. Diese interagiert mit Lebensläufen als Objekt (d. h. das Benutzerobjekt), enthält einen Array für Fähigkeiten und verfügt über eine Sammlung für Stellenangebote. Alternativ erfordert das Schreiben eines Lebenslaufs in eine relationalen Datenbank, dass die Anwendung das Benutzerobjekt “zerkleinert” (normalisiert).
Die Speicherung dieses Lebenslaufs würde erfordern, dass die Anwendung sechs Zeilen in drei Tabellen einfügt, wie in der Abbildung dargestellt. Abbildung 1.
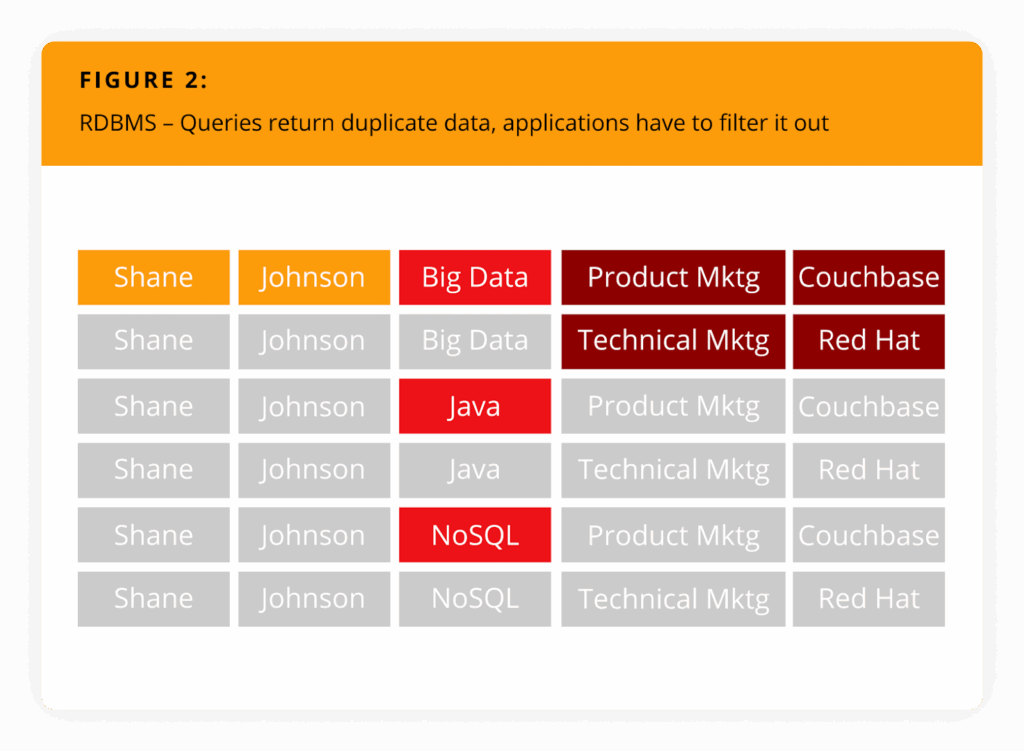
Und die Lese des Profils erfordert die Anwendung, sechs Zeilen aus drei Tabellen zu lesen, wie in der Abbildung dargestellt. Abbildung 2.
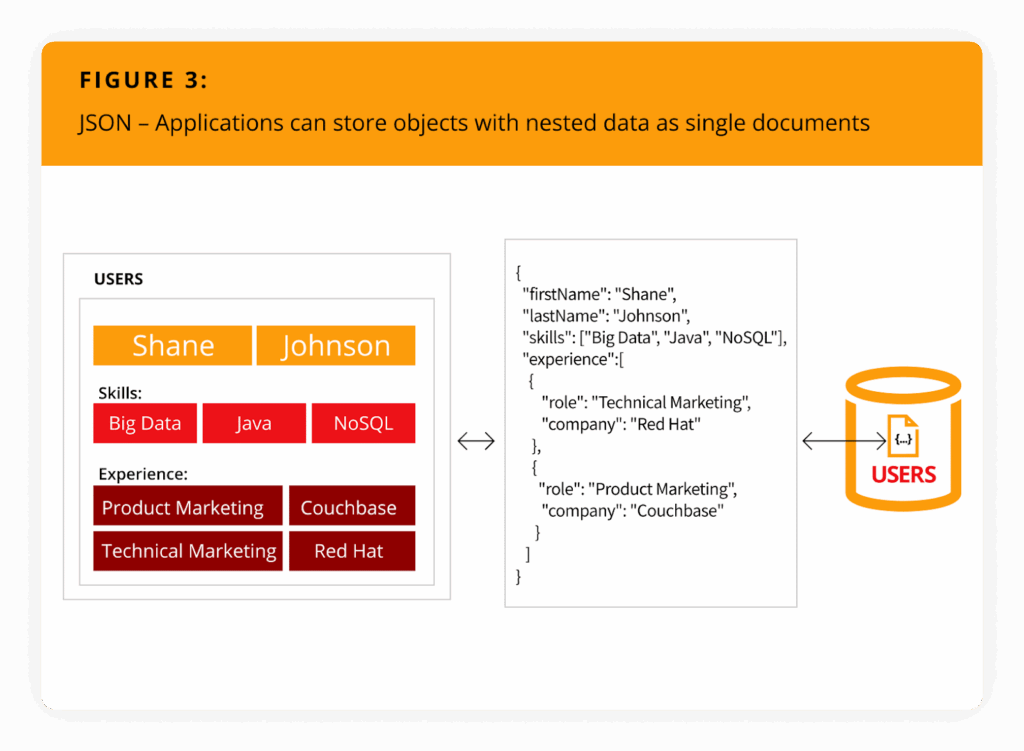
JSON beseitigt nicht nur das Objekt-relationales Impedanzungleichgewicht, sondern auch die üblichen Aufwände von Objekt-relationalen Mapping-Frameworks (ORM). Es vereinfacht die Anwendungsentwicklung, da Objekte gelesen und geschrieben werden können, ohne sie zu normalisieren (d. h., ein einzelnes Objekt kann als einzelnes Dokument gelesen oder geschrieben werden), wie in der folgenden Abbildung veranschaulicht: Abbildung 3.
Was ist mit Abfragen und SQL?
Manche könnten argumentieren, dass die Abfrage von NoSQL-Datenbanken schwieriger sei. Dies ist jedoch ein weit verbreitetes Missverständnis. Die durch die dokumentorientierte Struktur der NoSQL-Datenbanken begründete Flexibilität ermöglicht es, strukturierten und unstrukturierten Daten gleichermaßen gerecht zu werden, und neue Tools ermöglichen eine schnelleren Abfragevorgang als je zuvor.
Couchbase unterstützt SQL++, das es Entwicklern ermöglicht, die Leistungsfähigkeit von SQL und die Flexibilität von JSON zu nutzen. Es unterstützt nicht nur die Standardausdrücke SELECT / FROM / WHERE, sondern auch Aggregation (GROUP BY), Sortierung (SORT BY), Verknüpfungen (LEFT OUTER / INNER) und Abfragen von verschachtelten Arrays und Kollektionen. Darüber hinaus kann die Abfrageleistung durch zusammengesetzte, partielle und umfassende Indizes verbessert werden.
- SQL
- SQL++
SELECT RTRIM(p.FirstName) + ' ' + LTRIM(p.LastName) AS Name, d.City
ABER AdventureWorks2025.Person.Person AS p
INNER JOIN AdventureWorks2025.HumanResources.Employee und p.BusinessEntityID = e.BusinessEntityID
INNER JOIN
(SELECT bea.BusinessEntityID, a.City
Aus AdventureWorks2025.Person.Address AS
INNER JOIN AdventureWorks2025.Person.BusinessEntityAddress AS bea
ON a.AddressID = bea.AddressID) AS d
ON p.BusinessEntityID = d.BusinessEntityID
ORDER BY p.LastName, p.FirstName;
SELECT RTRIM(p.FirstName) || ' ' || LTRIM(p.LastName) AS Name, d.City
ABER AdventureWorks2025.Person.Person AS p
INNER JOIN AdventureWorks2025.HumanResources.Employee und p.BusinessEntityID = e.BusinessEntityID
INNER JOIN
(SELECT bea.BusinessEntityID, a.City
Aus AdventureWorks2025.Person.Address AS
INNER JOIN AdventureWorks2025.Person.BusinessEntityAddress AS bea
ON a.AddressID = bea.AddressID) AS d
ON p.BusinessEntityID = d.BusinessEntityID
ORDER BY p.LastName, p.FirstName;
ZUSAMMENFASSUNG
NoSQL-Datenbanken speichern Daten in flexiblen JSON-Dokumenten und entlasten so den Bedarf an komplexen Objekt-Relation-Mapping-Systemen (ORM). Zudem vereinfachen sie die Verwaltung strukturierter und unstrukturierter Daten. Diese Herangehensweise vereinfacht die Anwendungsentwicklung, da Objekte als ein einziges Dokument gespeichert und abgerufen werden können, anstatt in mehrere Tabellen aufgeteilt zu werden. Couchbase erweitert die Abfragenfunktionen zudem mit SQL++, das die bekannte SQL-Syntax unterstützt.
Warum relationalen Datenbanken Grenzen gesetzt sind
Relationales Datenbankmanagement wurde in der Ära der Mainframes und Business-Anwendungen entwickelt – lange vor dem Internet, der Cloud, Big Data, Mobiltechnologien, künstlicher Intelligenz und den heutigen massiv interaktiven Unternehmen. Diese Datenbanken wurden so konzipiert, dass sie auf einem einzigen Server ausgeführt werden konnten – je größer der Server, desto besser. Ihre Konstruktion zielte darauf ab, die Nutzung knapper Ressourcen für Speicherplatz, RAM und Verarbeitung zu optimieren. Die einzige Möglichkeit, die Kapazität dieser Datenbanken zu erhöhen, bestand darin, die Server (Prozessoren, Speicher und Festplatten) zu skalieren. In den Jahrzehnten wurden die meisten ursprünglichen Designbeschränkungen, einschließlich Normalisierung, starker Datentypgebung und referenzbezogener Integrität, gelockert oder aufgehoben.
NoSQL-Datenbank-Management-Systeme entstanden aufgrund des exponentiellen Wachstums des Internets und des Aufkommens von Webanwendungen. Google veröffentlichte die Bigtable-Forschungsbericht Im Jahr 2006 veröffentlichte Amazon die Dynamo-Forschungsbericht Im Jahr 2007 beschrieben diese Artikel detailliert, wie die beiden Unternehmen ihre Datenbanken so entwickelten, dass sie den sich verändernden Anforderungen der Unternehmen gerecht werden konnten. In der Praxis konzentrierten sich moderne Datenbanken auf Agil mitentwickeln, Anpassung an sich verändernde Anforderungenund Eliminierung der Datentransformation.
ZUSAMMENFASSUNG
Relational Database wurden ursprünglich für Umgebungen mit nur einem Server entwickelt, um begrenzte Ressourcen optimal zu nutzen. Im Zuge des Wachstums der Datenbedürfnisse mussten jedoch Skalierbarkeitsprobleme gelöst werden. Angeregt durch den Aufstieg des Internets und Webanwendungen tauchten NoSQL-Datenbanken auf, die auf Agilität, Skalierbarkeit und der Reduzierung der Komplexität der Datentransformation abzielen.
Schlussfolgerung
Also, wofür werden NoSQL-Datenbanken verwendet und warum sind sie wichtig? Da Unternehmen auf künstliche Intelligenz umsteigen – unterstützt durch Cloud-, Mobile-, Social-Media-, Machine-Learning- und GenAI-Technologien – Entwickler- und Betriebsteams müssen Web-, Mobile- und IoT-Anwendungen schneller und in größerem Umfang erstellen und pflegen. Flexible, leistungsstarke NoSQL-Technologien sind zunehmend die Datenbanktechnologie ihrer Wahl.
Tausende von Globales Unternehmen der 2000er-Jahre Entwickler und Millionen von Entwicklern in kleineren Unternehmen und Start-ups haben NoSQL übernommen. Für viele begann die Nutzung von NoSQL mit einem Cache, einem Proof-of-Concept oder einer kleinen Anwendung, die sich dann auf gezielte, missionkritische Anwendungen ausweitete und schließlich zur Grundlage für die gesamte Anwendungsentwicklung wurde.
Mit NoSQL-Datenbanken können Unternehmen agiler arbeiten, in jeder Größenordnung agieren und die Leistung und Verfügbarkeit bereitstellen, die für die Anforderungen von Unternehmen der digitalen Wirtschaft erforderlich sind.
Verwandte NoSQL-Datenbankressourcen erkunden
-
Whitepaper
Warum NoSQL-Datenbanken? Eine Entwickler-Anleitung
-
Webseite
Vergleich der NoSQL-Cloud-Datenbanken
-
Whitepaper
Warum NoSQL-Datenbanken für KI-gestützte Apps?