Real-Time-Analysen für Apps und KI-Agenten
Couchbase Operational Insights
Couchbase Analytics ist jetzt Couchbase Operational Insights: Echtzeit-Analysen auf Basis von live betrieblichen Daten, mit Ergebnissen, die direkt an die Apps und KI-Agenten weitergeleitet werden, die darauf reagieren.
Wo die traditionelle Analytik versagt
Die meisten Analysen basieren auf einer Kopie der Daten von gestern. Übergeben Sie diese Antwort einem KI-Agenten, und dieser verfährt fehlerhaft – sicher und in großem Maßstab.
Stale bei Ankunft
Jeder Pipeline-Hop führt zu einer Verzögerung, sodass Echtzeit-Veranstaltungen zu Stundenlängen dauern und Entscheidungen auf der Grundlage der letzten Nachts Kopie getroffen werden.
Brittle von Natur aus
ETL-Pipelines brechen, wenn eine App ein Feld hinzufügt oder ein Dokument ändert, und jemand muss sie manuell beheben.
Standardmäßig einseitig
Die Insights bleiben im Lager. Um sie wieder in Apps und Agenten zu bringen, ist eine inverse ETL-Aufgabe oder ein Skript erforderlich.
Häufige Anfragen verlangsamen die Produktion
Stattdessen führen Sie eine Analyse auf der betrieblichen Datenbank durch, und die Kunden, die Ihre Apps nutzen, spüren die Verlangsamung.
Was ist Couchbase Operational Insights?
Real-Time-Analysen, integriert in die Operational Data Platform für KI®. Es analysiert live betriebliche Daten und stellt die Antworten dort bereit, wo Apps und Agenten tätig sind.
Operational Insights speichert die operativen Daten in Echtzeit. Daten fließen von Couchbase Capella und Couchbase Server, MongoDB, DynamoDB, PostgreSQL, MySQL, Oracle und SQL Server über Kafka und aus JSON-, Parquet-, Avro-, CSV- und Delta Lake-Dateien in der Cloud-Speicherung. Es gibt keine täglichen Kopien und keine Pipeline, die beim Ändern der Dokumentstruktur neu erstellt werden muss.
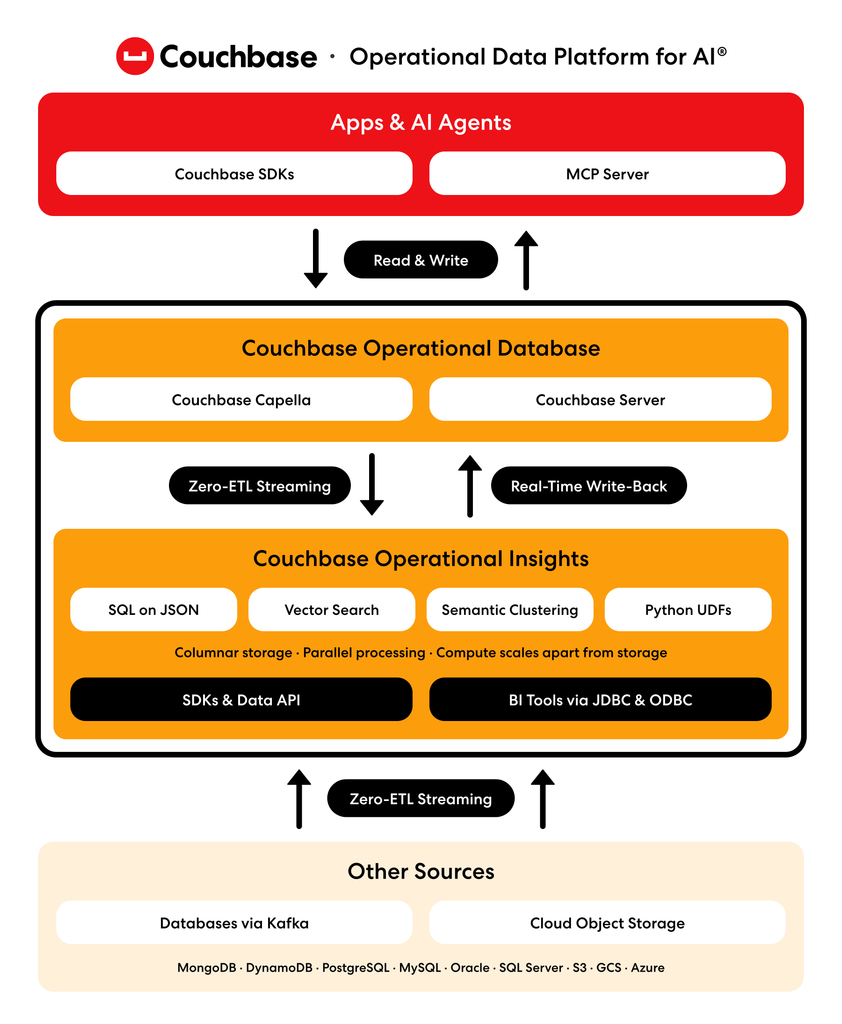
Die Analyse läuft auf einem eigenen Cluster, sodass schwere Abfragen die von Ihren Kunden verwendeten Apps niemals verlangsamen. Die Rechenleistung wird unabhängig von der Speicherplatzkapazität bereitgestellt, die in Objektspeicher gespeichert wird. So können Sie ohne Datenmigration Kapazität hinzufügen. Im Hintergrund werden JSON-Daten in Spaltenform gespeichert und Abfragen werden in parallelen Workloads auf den Knoten ausgeführt, die von einem kostensensitiven Optimierer geplant werden.
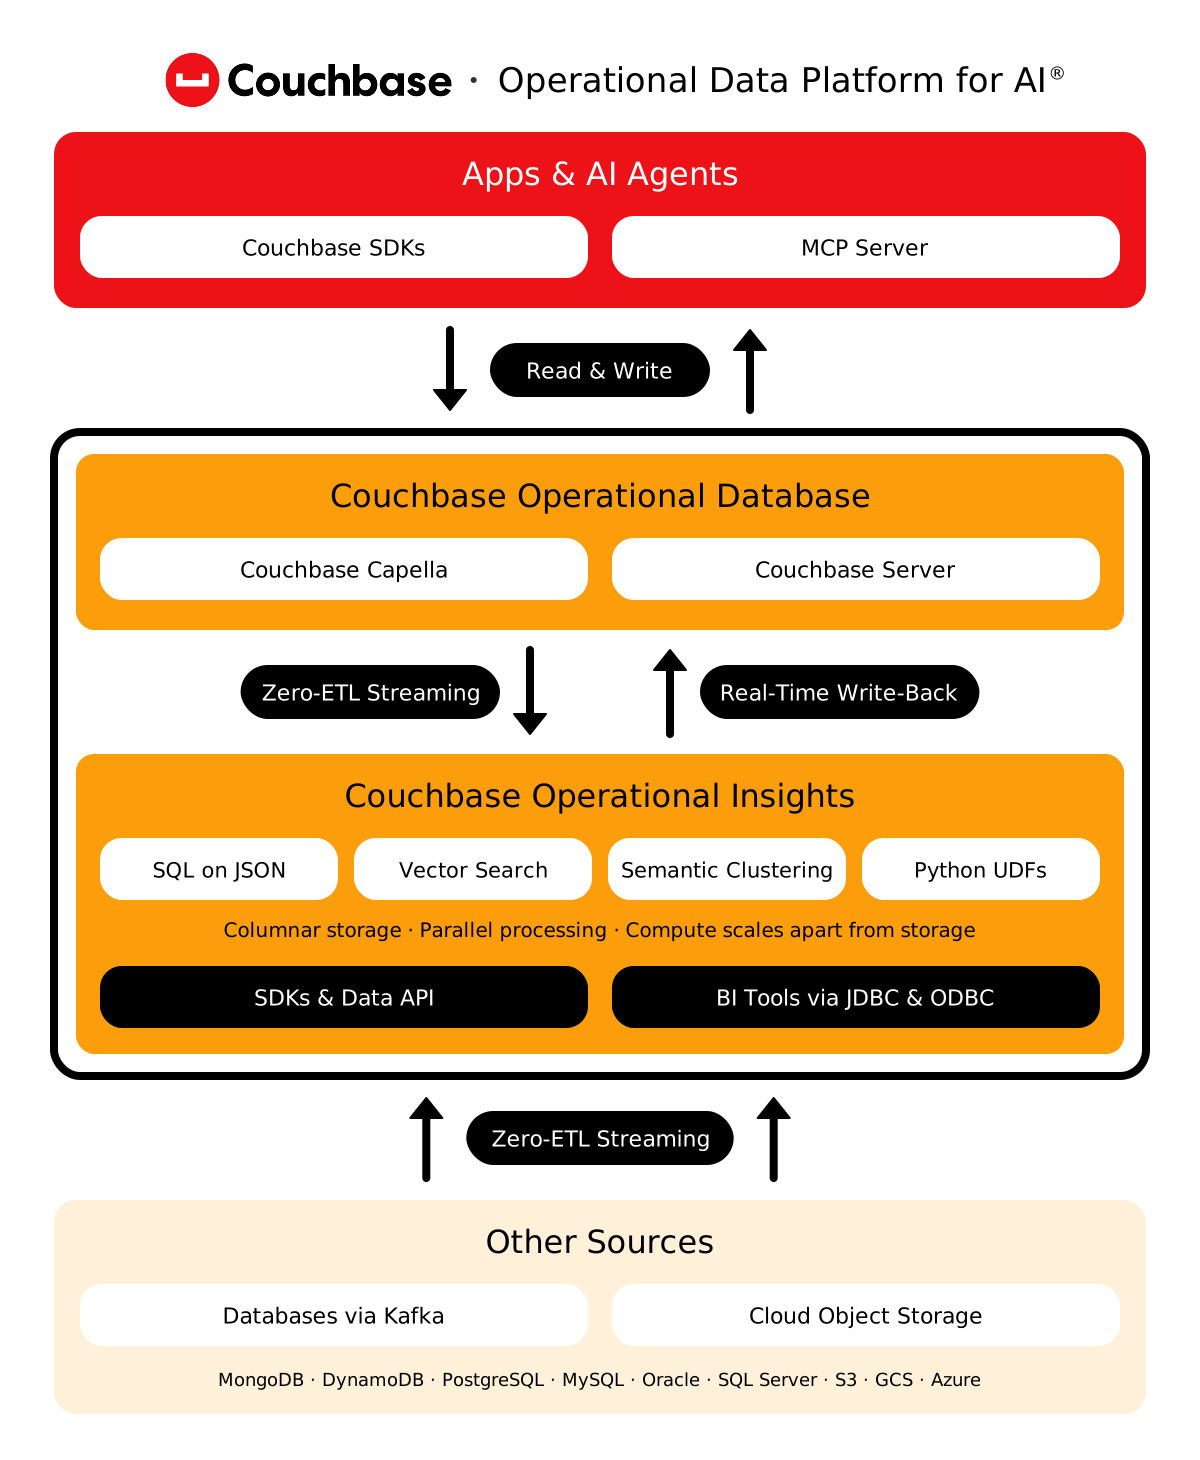
Ein Einblick zahlt sich aus, wenn etwas darauf reagiert. Schreiben Sie die Ergebnisse jeder SQL++-Abfrage direkt in die operative Datenbank ein, die Ihre Apps und Agenten bereits lesen: Kvarzitäts- und Betrugswerte, Kundensegmente, Cluster-Labels, Kennzahlen und die besten Alternativen. Es gibt keine Reverse-ETL-Verfahren oder Übergabe an andere Stellen, sodass die Antwort bereits bei der nächsten Lesung verfügbar ist.
Bei selbstverwalteten Bereitstellungen werden Gruppenaufzeichnungen nach exakter Wert oder Bedeutung mit semantischer Clustering-Technologie erstellt, die auf nativem Vektor-Suchwerkzeug basiert. Cluster-Bewertungen, Tickets oder Beschwerden werden in Themen gruppiert und in derselben SQL-Abfrage zusammengefasst. Die Unterstützung für Vektoren und SQL ermöglicht eine genaue Suche für Präzision und eine grobe Suche für Geschwindigkeit.
Statistiken und Benchmarks
~100×
Geringere Analyseabfrage-Latenz im Vergleich zu MongoDB Atlas (CH2++ 2025)
22/22
CH2++-Abfragen abgeschlossen. MongoDB Atlas verlor bei 8 von 22 Anfragen die Zeit.
OPERATIVE Einblicke für Kunden
Ergebnisse in der Produktion


So funktioniert es
Eine geschlossene Schleife, von den Daten bis zur Entscheidung
Operational Insights umfasst alle Schritte zwischen einem Dateneingabevorgang und der jeweiligen Aktion, die eine App oder ein Agentenprogramm darauf ausführt.
- Einnahme
- Analysieren
- Cluster
- Gesetz
Die Änderungen werden von Couchbase, anderen Datenbanken und der Cloud-Speicherung in Echtzeit abgerufen, ohne dass eine ETL-Pipeline aufgebaut oder überwacht werden muss.
Funktionen der Operational Insights-Funktionalität
Null ETL-Aufnahme
Daten aus Couchbase, MongoDB, DynamoDB, PostgreSQL, MySQL, Oracle und SQL Server streamen über Kafka und Dateien auf S3, GCS und Azure lesen.
Verwenden Sie SQL++, um gespeicherte JSON-Daten direkt in einer SQL-Anfrage abzufragen und dabei live betriebsrelevante Daten mit historischen und externen Quellen zu verbinden.
Funktionen der Operational Insights-Funktionalität
SQL auf JSON
Verknüpfung und Aggregation in verschachteltem JSON ohne Vertiefung. In der selbstverwalteten Version können Sie benutzerdefinierte Logik mithilfe von Python-UDFs hinzufügen und mehrere Schritte pro Anfrage ausführen.
Gruppendaten werden nach Bedeutung und Feld mit semantischem Clustering und Vektor-Suche zusammengefasst und anschließend in derselben Abfrage aggregiert (selbstverwaltet).
Funktionen der Operational Insights-Funktionalität
Semantisches Clustering und Vektor-Suche
CLUSTER BY groups erfasst die Datensätze nach Bedeutung in SQL++. Ausführen von exakter (KNN) oder annähernder (ANN) Vektorrecherche auf einem VTREE-Index (selbstverwaltet).
Die Ergebnisse werden direkt in die operative Datenbank geschrieben, sodass Apps und Agenten diese mit dem nächsten Zugriff nutzen können.
Funktionen der Operational Insights-Funktionalität
Rückschreiben in Echtzeit
Die Ergebnisse jeder SQL++-Abfrage werden in Couchbase Capella, Couchbase Server oder Cloud-Dateispeichern gespeichert. Kein Reverse-ETL.
- Datenfluss
- Vektor-Indexierung
ARCHITEKTUR
Wie Operational Insights funktioniert
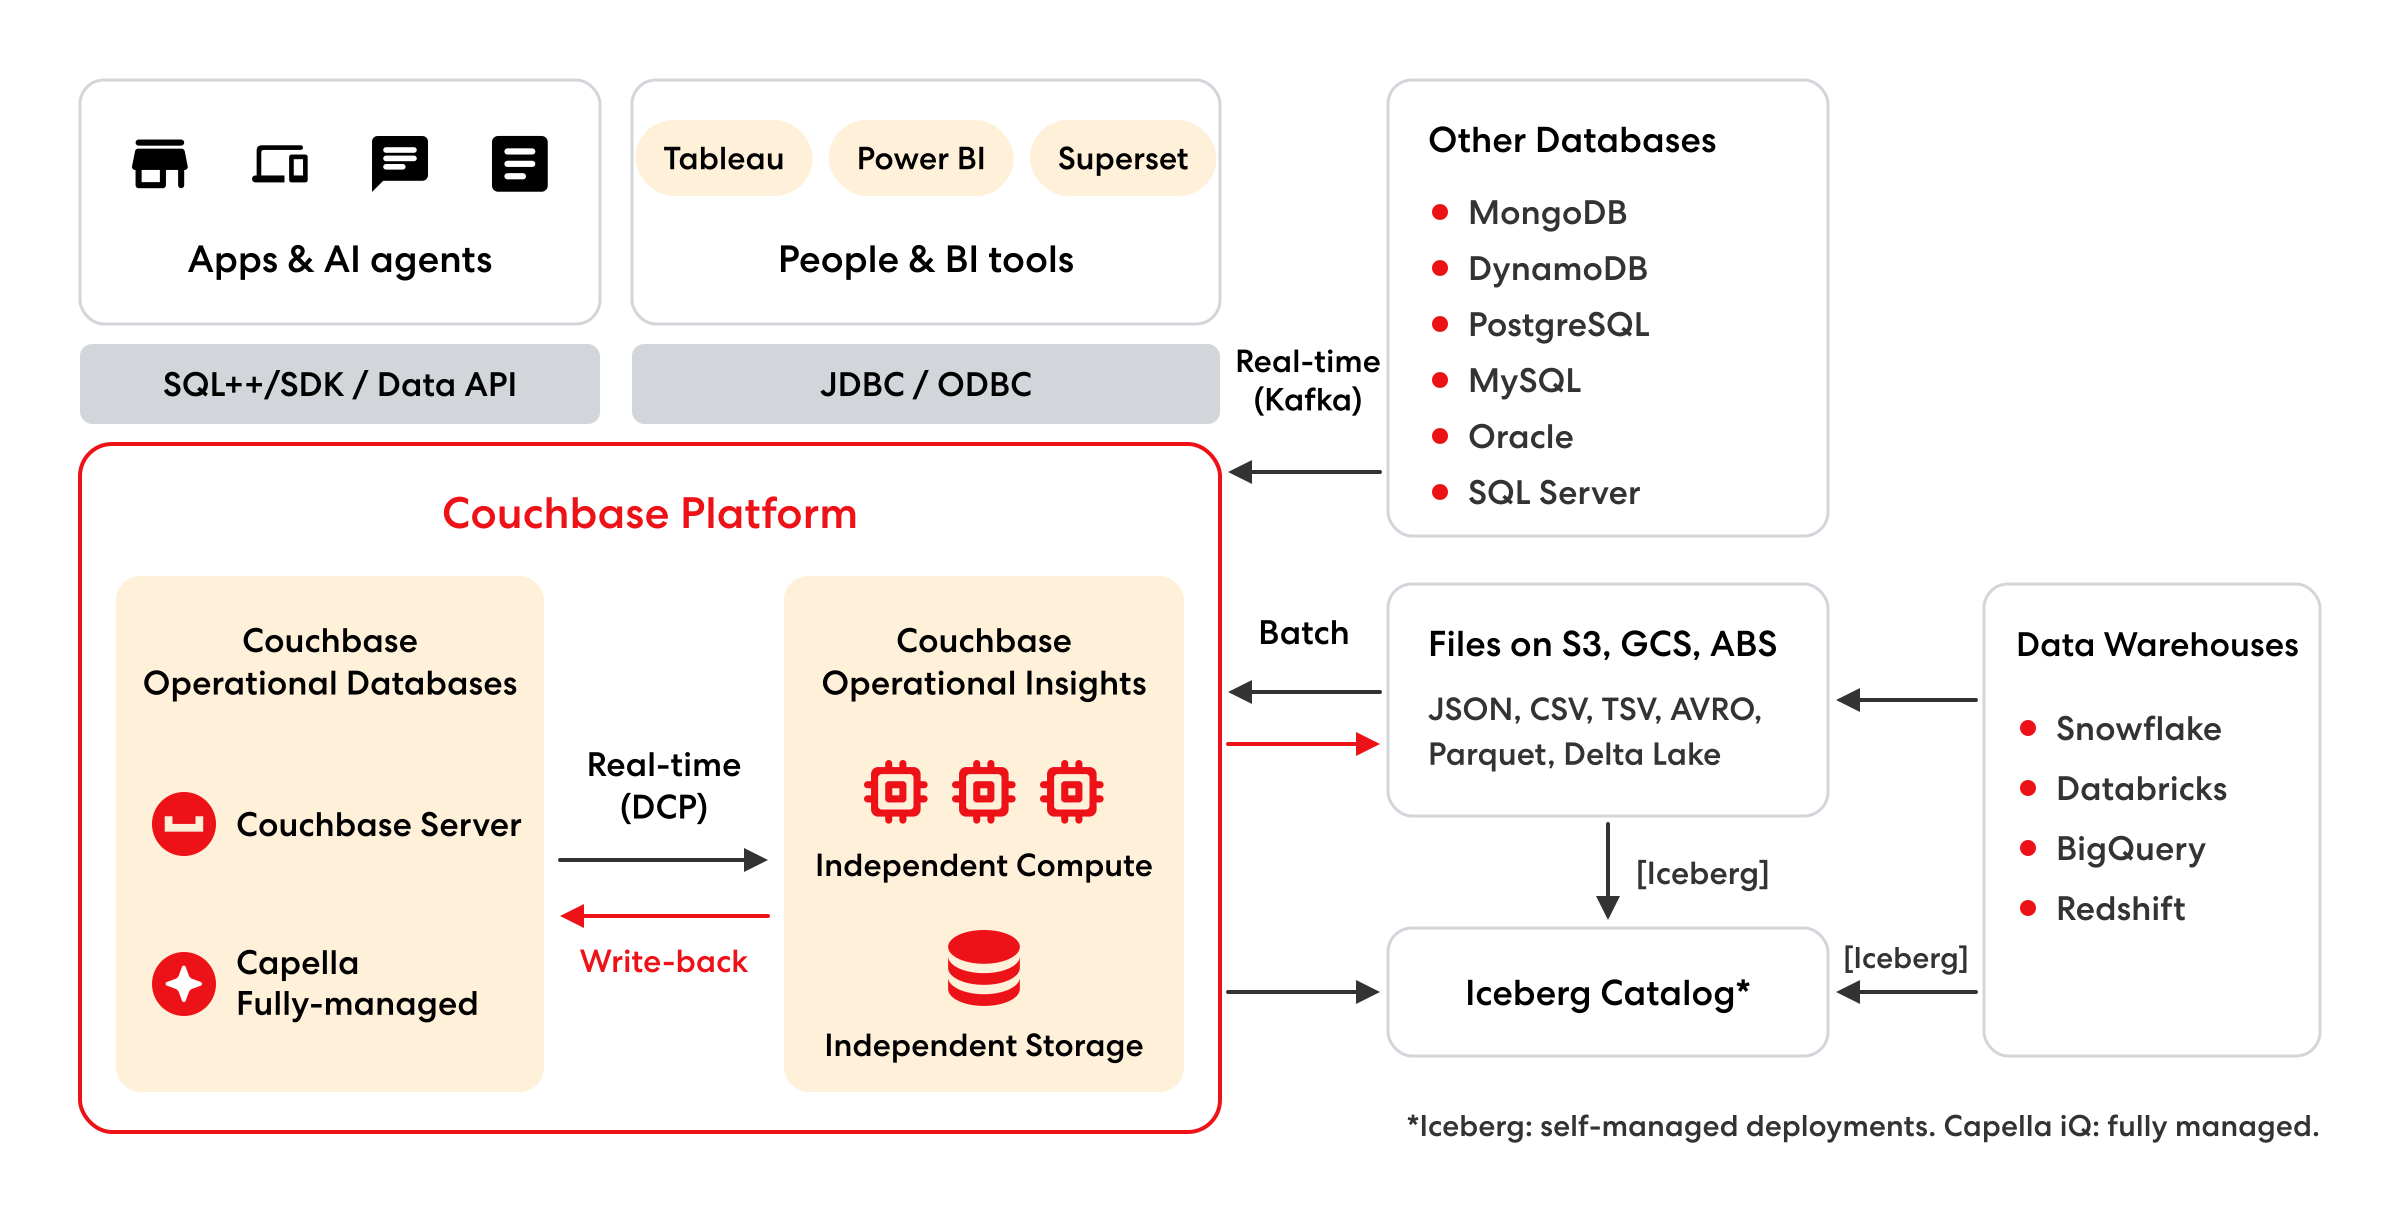
Schnelle Aufnahme
Zeitbasierte Streams aus Couchbase Capella und Couchbase Server, Kafka-Feeds aus MongoDB, DynamoDB, PostgreSQL, MySQL, Oracle und SQL Server sowie Dateien in S3, GCS und Azure.
Geschwindigkeit und Ausmaß
Spaltenweise Speicherung, parallele Verarbeitung und Rechenleistung, die sich unabhängig von der Speicherung skalieren lässt – so konkurriert die Analyse nie mit Ihren Apps um Ressourcen.
Real-time-Analysen
SQL++, Vektor-Suche und semantisches Clustering für Apps und Agenten über SDKs und die Data API sowie Tableau, Power BI und Superset über JDBC und ODBC.
Zurückschreiben
Die Ergebnisse stammen aus Couchbase Capella, Couchbase Server oder Cloud-Dateispeichern und sind für Apps und Agenten beim nächsten Zugriff verfügbar.
VECTOR-SUCHE
Wie funktionieren Vektor-Suchanfragen?
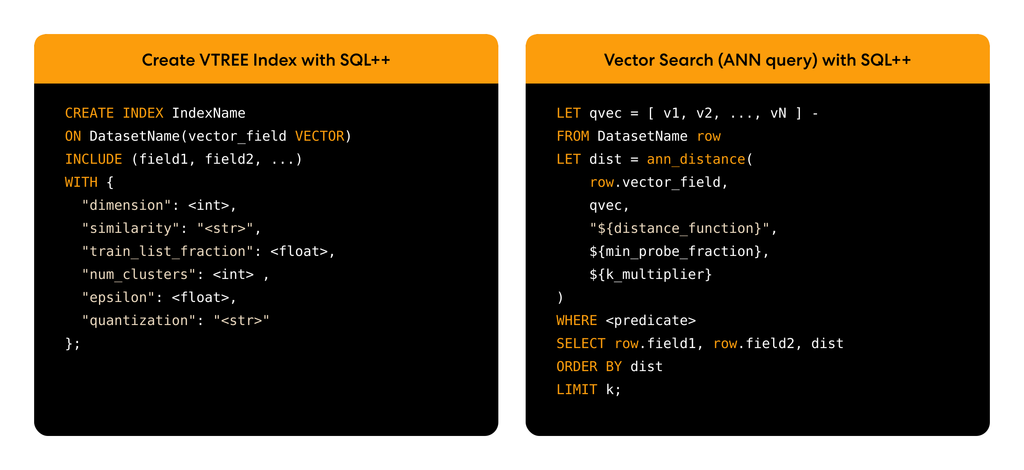
Vektor-Speicher
Die Embeddings befinden sich in JSON-Dokumenten neben den darin beschriebenen Daten, sodass Vektoren und Datensätze an einem Ort zusammengehalten werden.
VTREE-Index
Gruppen gruppieren ähnliche Vektoren in Blattcluster, die eine Suche direkt abfragen kann. Die optionale Quantisierung SQ4 oder SQ8 komprimiert gespeicherte Vektoren.
Exakte Suche (KNN)
Vergleicht die Abfrage mit jedem gespeicherten Vektor. Präzise, aber langsamer, je größer die Datenmenge wird.
Ungefähre Suche (ANN)
Verwendet den Index, um zuerst auf wahrscheinlich passende Ergebnisse zu beschränken. In großem Maßstab ist dies viel schneller möglich, wobei die Einstellungen die Wiedererkennung gegen Kosten ausgleichen. Die gleichen Vektoren ermöglichen semantisches Clustering.
Unter dem Deckel
Entwickelt für ständige, gleichzeitige Anfragen
KI-Agenten fragen ständig und oft gleichzeitig. Die Hash-basierte Aggregation berechnet in einem einzigen Durchlauf die DISTINCT-Zahlen. Die Abfrageplan-Caching-Funktion nutzt den besten Plan, wenn eine Frage wiederholt wird. Die gespeicherte Optimierungsplan-Statistik überspringt vollständige Tabellenscans, sodass die Statistikermenge mit der Datenmenge korreliert.
Ein Produkt, zwei Möglichkeiten, es zu nutzen
HÄRIGES VERWALTET
Auf Couchbase Capella
Starten Sie Operational Insights als Dienst auf AWS, Google Cloud oder Azure (für ausgewählte Regionen). Fragen Sie mit Capella iQ in einfacher Sprache, deaktivieren Sie die Cluster auf Anfrage oder nach einem Zeitplan und zahlen Sie nur für die Speicherplatznutzung, während diese deaktiviert ist, und lassen Sie Couchbase die Sicherung, Überwachung und Benachrichtigungen übernehmen.
Selbstverantwortung
Wo immer Sie es ausführen
Implementieren Sie die Lösung sowohl lokal als auch in Ihrem eigenen AWS-, Azure-, Google Cloud- oder OCI-Konto mit x86- oder ARM-Systemen und einem S3-kompatiblen Objektspeicher. Verwalten Sie Apache Iceberg-Tabellen direkt über offene REST-Kataloge und senden Sie Prometheus-konforme Metriken an die Überwachungswerkzeuge, die Sie bereits verwenden.
Allgemeine Fragen zu Operational Insights (ehemals Analytics)
Erhalten Sie schnelle Antworten zu Echtzeit-Analysen, Zero-ETL, Write-Back, KI-Agenten und Bereitstellungsoptionen.
Couchbase Operational Insights ist eine Echtzeit-Analytik, die in die Couchbase-Plattform integriert ist. Sie fragt mit SQL++ nach live-betrieblichen JSON-Daten und schreibt die Ergebnisse anschließend an Apps und KI-Agenten zurück, die sie verwenden können.
Ja. Im Oktober 2026 wurde Couchbase Analytics in Couchbase Operational Insights umbenannt. Capella Analytics und Enterprise Analytics sind nun Operational Insights, vollständig verwaltet oder selbst verwaltet.
Capella Columnar wurde im August 2025 in Capella Analytics umbenannt und im Oktober 2026 in Couchbase Operational Insights. Es handelt sich um denselben Service, daher beziehen sich ältere Videos, Dokumente und Blogbeiträge mit den Überschriften “Columnar” oder “Analytics” auf Operational Insights.
Nein. Daten fließen kontinuierlich von Couchbase, anderen Datenbanken über Kafka und aus Cloud-Objektspeicherquellen. Sie können sie nach Belieben abfragen, ohne einen ETL-Pipeline oder einen vordefinierten Schema zu benötigen.
Nein. Ein Lager meldet, was in der gesamten Organisation passiert ist. Operational Insights analysiert, was gerade passiert, und schreibt die Antwort an die App. Viele Teams nutzen beide Systeme – jeder für seine eigene Aufgabe.
Die zurückgeschriebenen Ergebnisse in der operativen Datenbank werden zu einem Live-Kontext, den die Agenten über den Couchbase MCP Server erreichen. Semantisches Clustering und Vektor-Suche werden in SQL++ ausgeführt.
Ja. Sie können es selbst verwalten, entweder lokal oder in Ihrer eigenen Cloud, oder vollständig verwaltet von Couchbase Capella, mit demselben Engine und SQL++. Apache Iceberg ist nur selbstverwalst; Capella iQ ist nur vollständig verwaltet.
Fortfahren mit der Erkundung
-
Erfahren Sie mehr über operative Erkenntnisse in Aktion
Sehen Sie sich an, wie Echtzeitanalysen und Write-Back den KI-Agenten aktuelle Kontextinformationen liefern.
-
Warum KI-Agenten in der Pilotphase stecken bleiben
Erfahren Sie, warum Agenten einen neuen, strukturierten Kontext benötigen, um von der Pilotphase in die Produktion zu übergehen.
-
Beginnen Sie in den Dokumenten
Stellen Sie Operational Insights, entweder verwaltet oder selbst verwaltet, ein und führen Sie Ihre erste Abfrage aus.