Analyse en temps réel pour les applications et les agents d'IA
Couchbase Operational Insights
Couchbase Analytics devient désormais Couchbase Operational Insights : analyse en temps réel des données opérationnelles en temps réel, avec des résultats directement réexpédiés aux applications et aux agents d’IA qui y agissent.
Là où l’analyse traditionnelle laisse à désirer
La plupart des analyses s’appuient sur une copie des données d’hier. Lorsqu’on transmet cette réponse à un agent IA, celui-ci prend une décision incorrecte, de manière fiable et à grande échelle.
Stale à l'arrivée
Chaque étape du pipeline ajoute du retard ; le temps réel se transforme alors en heures, et les décisions sont prises sur la base de la copie de la veille.
Brittle par conception
Les pipelines ETL s’interrompent lorsque l’application ajoute un champ ou modifie un document, et il faut alors les réparer manuellement.
Un sens unique par défaut
Les informations restent dans le stockage. Pour les réintégrer dans les applications et les agents, il faut effectuer un travail inverse de ETL ou un script.
De nombreuses requêtes ralentissent la production
Mettez plutôt en place une analyse de la base de données opérationnelle, et les clients utilisant vos applications ressentiront une baisse de performance.
Qu’est-ce que Couchbase Operational Insights ?
Analyse en temps réel intégrée dans la plateforme de données opérationnelles pour l’IA®. Il analyse les données opérationnelles en temps réel et met la réponse là où les applications et les agents interviennent.
Operational Insights reflète les données opérationnelles au fur et à mesure de leur modification. Les données sont collectées à partir de Couchbase Capella et Couchbase Server, de MongoDB, DynamoDB, PostgreSQL, MySQL, Oracle et SQL Server via Kafka, ainsi que de fichiers JSON, Parquet, Avro, CSV et Delta Lake stockés dans le cloud. Il n’y a pas de copie quotidienne ni de pipeline de reconstruction lorsque le format d’un document change.
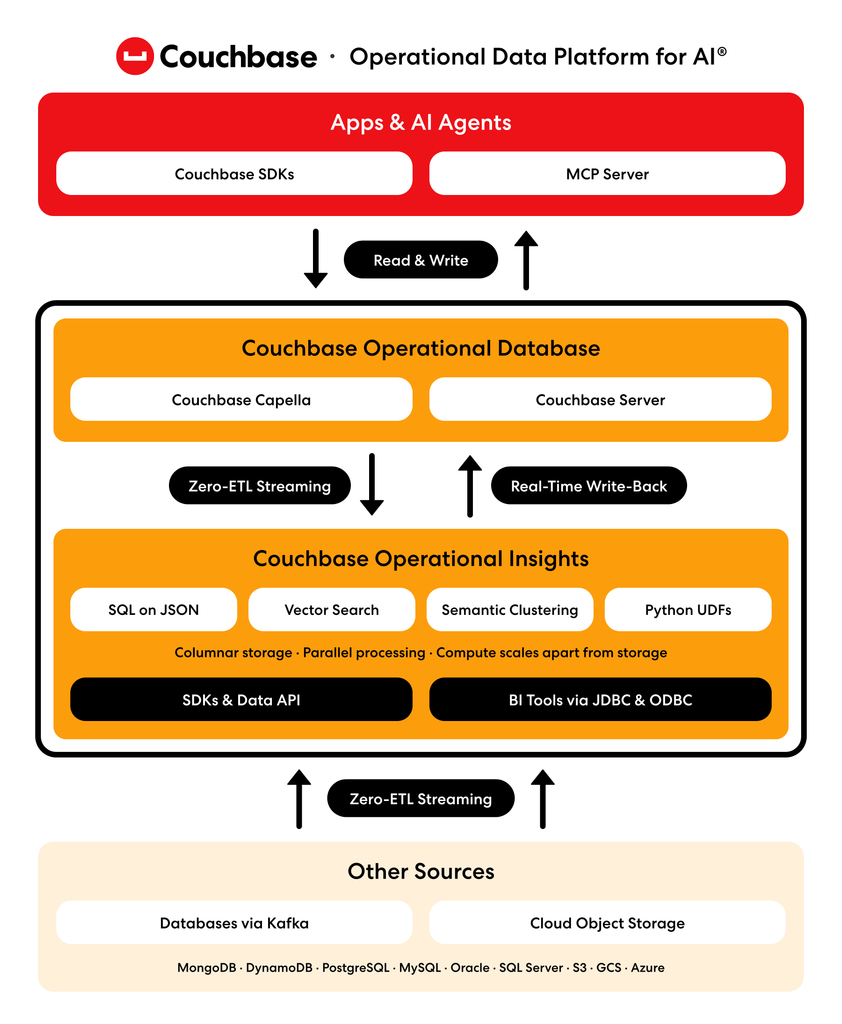
L'analyse s'exécute sur un cluster indépendant, de sorte que les requêtes lourdes n'affaiblissent jamais les applications utilisées par vos clients. Le calcul est séparé de l'espace de stockage, qui se situe dans un stockage d'objets, de sorte que vous pouvez ajouter de la capacité sans déplacer les données. En arrière-plan, les données JSON sont stockées colonne par colonne et les requêtes sont exécutées en parallèle sur tous les nœuds, planifiées par un optimiseur basé sur les coûts.
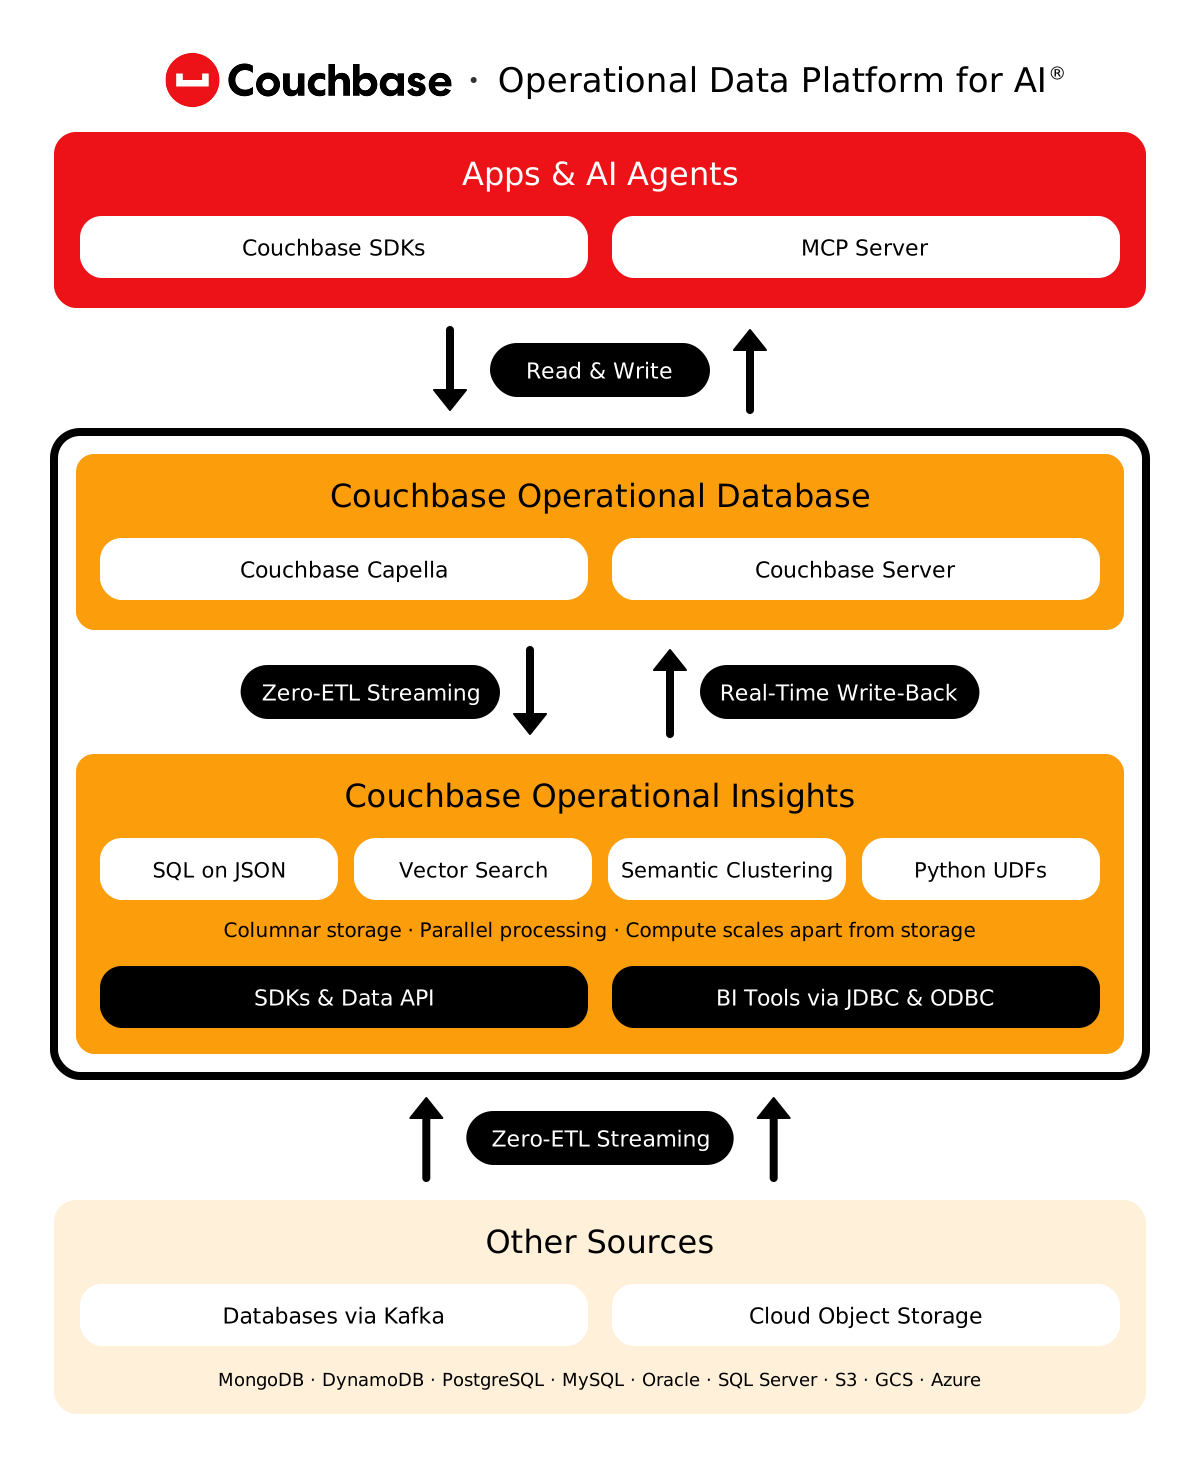
Une analyse paye quand elle est appliquée. Écrivez les résultats de toute requête SQL++ directement dans la base de données opérationnelle que vos applications et vos agents lisent déjà : taux de churn et de fraude, segments de clients, labels de cluster, KPI et propositions de valeur. Il n’y a pas de ETL inverse ni de transfert manuel, donc la réponse est disponible dès la prochaine lecture.
Pour les déploiements auto-gérés, les enregistrements de groupes sont classés par valeur exacte ou par signification grâce à un clustering sémantique, basé sur une recherche vectorielle native. Les évaluations de clusters, les tickets ou les réclamations sont regroupés dans des thèmes et agrégés dans la même requête SQL. Le support de vecteurs et le langage SQL permettent une recherche exacte pour une précision et une recherche approximative pour une rapidité.
Statistiques et critères de référence
~100×
une latence de requête analytique plus faible par rapport à MongoDB Atlas (CH2++ 2025)
22/22
Les requêtes CH2++ sont terminées. MongoDB Atlas a échoué sur 8 de 22.
RÉFÉRENCES OPERATIQUES AUX CLIENTS
Résultats en production


COMMENT C'EST FONCTIONNER
Une boucle fermée, de la donnée à la décision
Operational Insights couvre toutes les étapes entre un changement dans vos données et l’action que prend une application ou un agent à ce sujet.
- Ingestion
- Analyser
- Cluster
- Acte
Les changements sont transmis à Couchbase, à d'autres bases de données et au stockage en nuage dès qu'ils surviennent, sans avoir besoin d'un pipeline ETL à construire ou à surveiller.
Capacités d'analyse opérationnelle
Absence d'intégration ETL
Transférer des données depuis Couchbase, MongoDB, DynamoDB, PostgreSQL, MySQL, Oracle et SQL Server via Kafka et lire des fichiers depuis S3, GCS et Azure.
Interroger le JSON imbriqué directement avec SQL++, en associant les données opérationnelles en temps réel avec les sources historiques et externes dans une seule requête.
Capacités d'analyse opérationnelle
SQL sur JSON
Joins et agrégations sur un JSON imbriqué sans flattage. Dans le mode self-managed, ajoutez une logique personnalisée à l’aide de UDF Python et exécutez plusieurs étapes par requête.
Grouper les données par signification et par domaine grâce à un clustering sémantique et à une recherche vectorielle, puis les agréguer dans la même requête (gestion autonome).
Capacités d'analyse opérationnelle
Clustering sémantique et recherche vectorielle
CLUSTER BY groups enregistre les enregistrements par signification dans SQL++. Effectuez une recherche vectorielle exacte (KNN) ou une recherche approximative (ANN) sur un index VTREE (gestionné par le système).
Écrivez les résultats directement dans la base de données opérationnelle, afin que les applications et les agents agissent en conséquence lors de la prochaine lecture.
Capacités d'analyse opérationnelle
Réécriture en temps réel
Écrivez les résultats de toute requête SQL++ dans Couchbase Capella, Couchbase Server ou des magasins de fichiers en nuage. Pas de ETL inversé.
- Flux de données
- Indexation vectorielle
ARCHITECTURE
Comment fonctionne Operational Insights
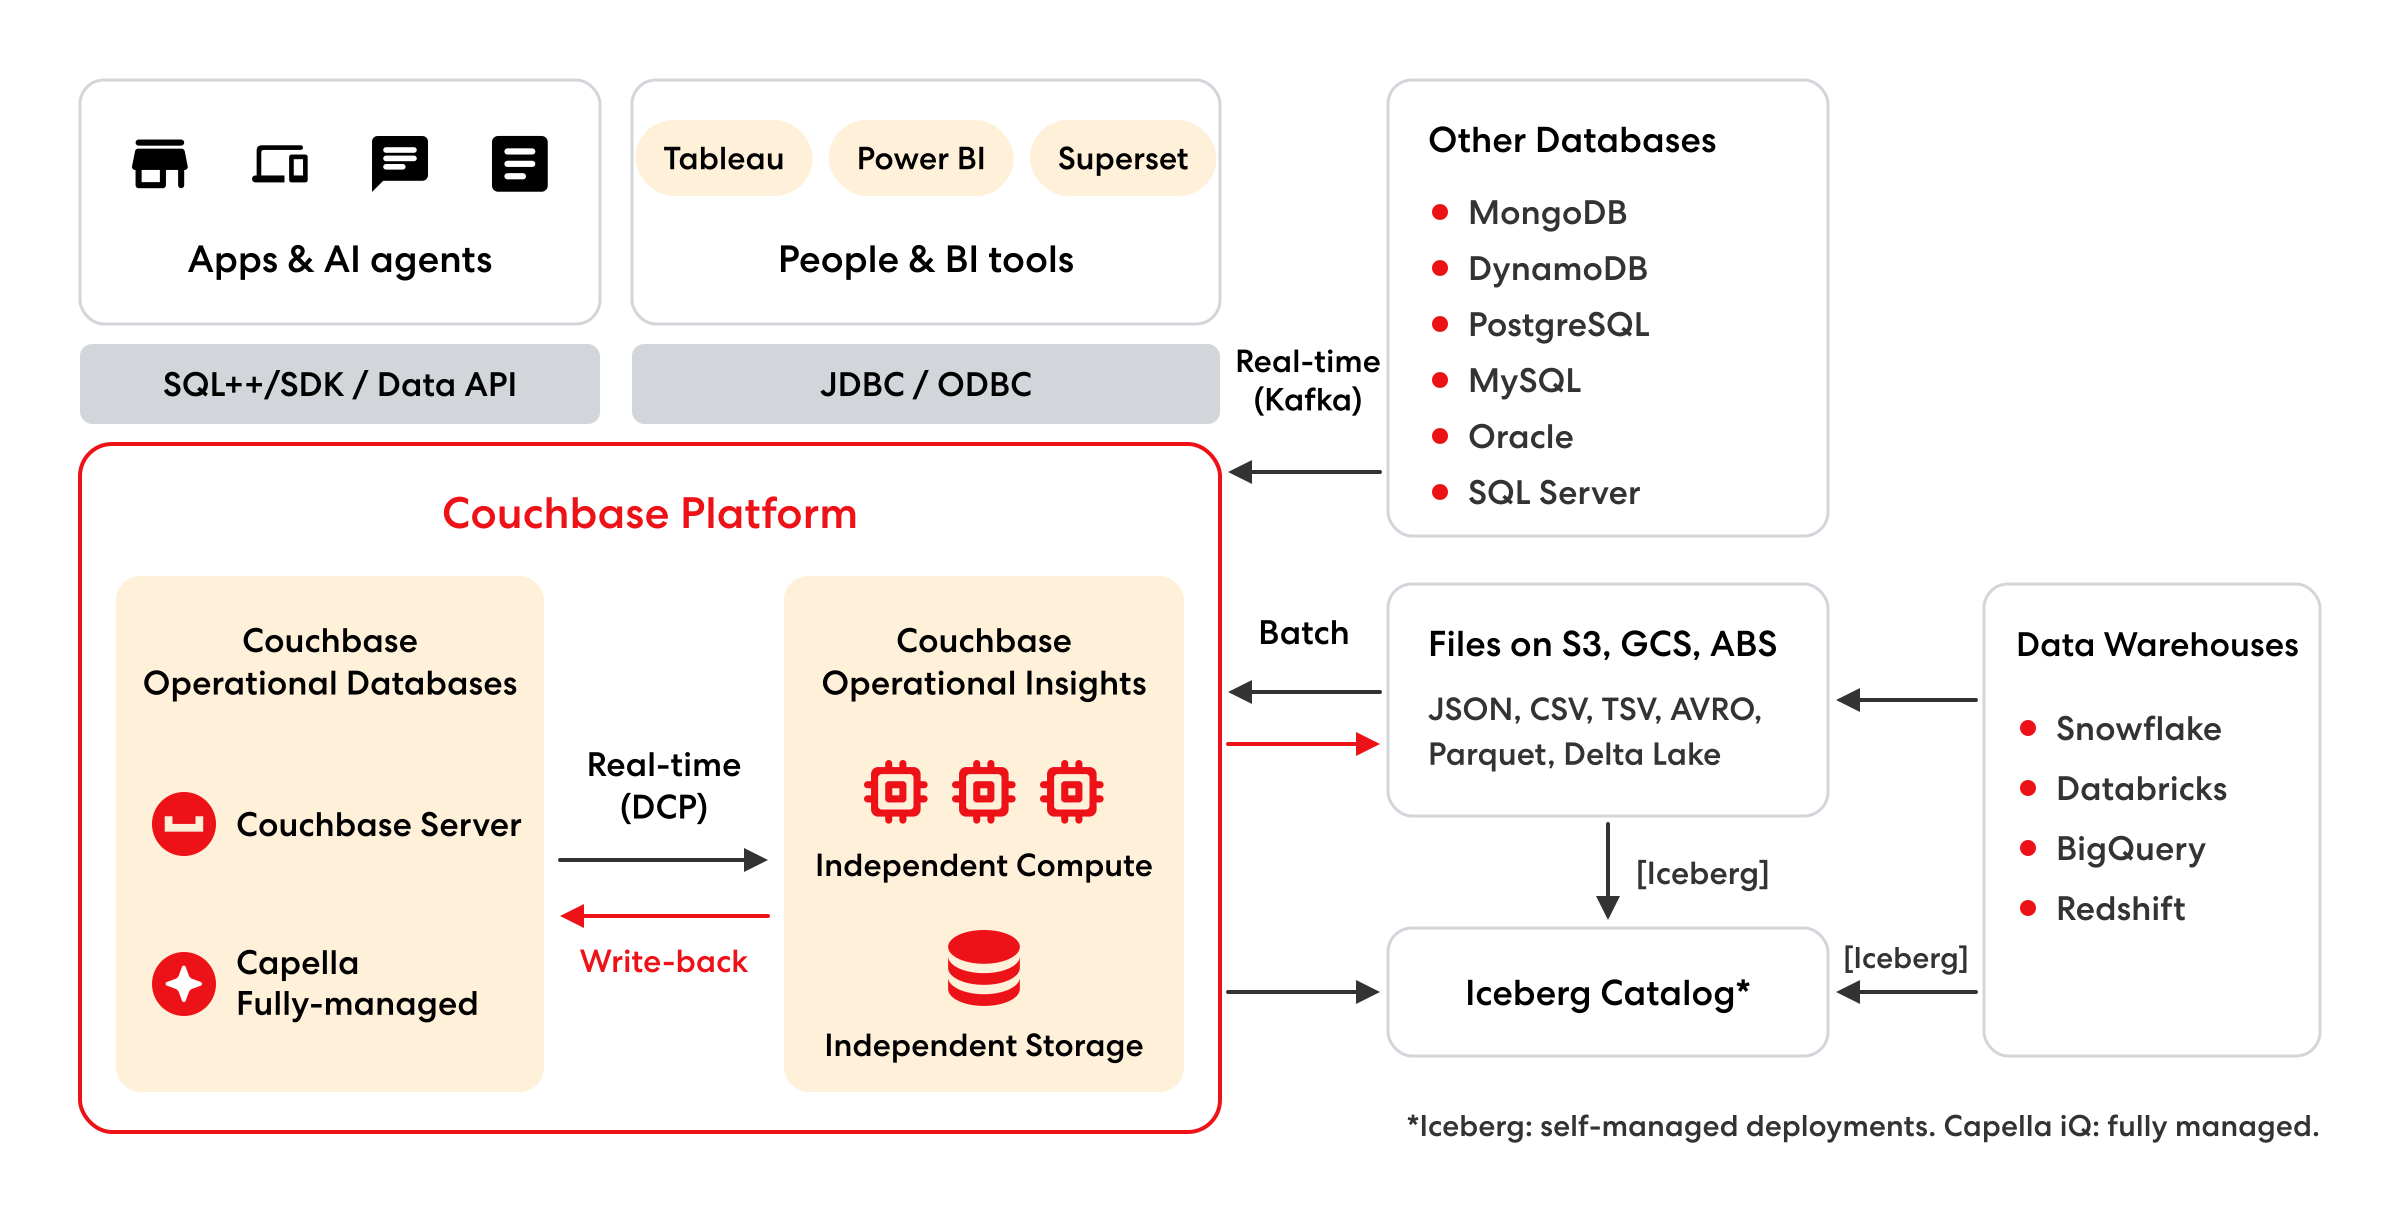
Absorption rapide
Des flux en temps réel provenant de Couchbase Capella et Couchbase Server, des flux Kafka provenant de MongoDB, DynamoDB, PostgreSQL, MySQL, Oracle et SQL Server, ainsi que des fichiers dans S3, GCS et Azure.
Vitesse et ampleur
L’archivage par colonnes, le traitement parallèle et les calculs qui s’étendent indépendamment de l’espace de stockage permettent d’analyser les données sans compromettre les performances des applications.
Analyse en temps réel
SQL++, recherche vectorielle et clustering sémantique pour les applications et les agents via des SDK et l’API Data, ainsi que Tableau, Power BI et Superset via JDBC et ODBC.
Retour d'écriture
Les résultats sont stockés dans Couchbase Capella, Couchbase Server ou dans des magasins de fichiers en nuage, prêts à être utilisés par les applications et les agents lors de la prochaine lecture.
RECHERCHE VECTORIELLE
Comment fonctionnent les requêtes de recherche vectorielles
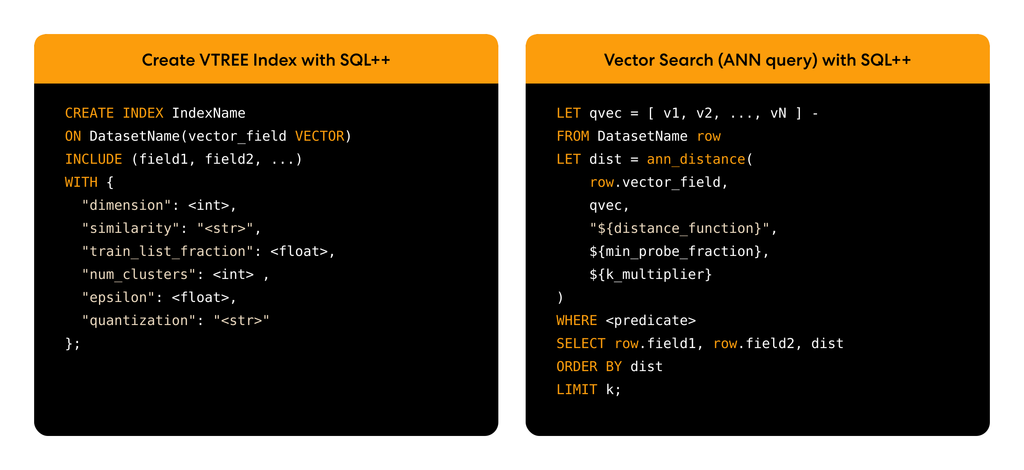
Stockage de vecteurs
Les embeddings sont intégrés dans les documents JSON à côté des données qu’ils décrivent, de sorte que les vecteurs et les enregistrements restent dans un même endroit.
Indice VTREE
Les groupes de vecteurs similaires sont regroupés en groupes de feuilles que la recherche peut sonder directement. La quantification SQ4 ou SQ8 optionnelle compresse les vecteurs stockés.
Recherche exacte (KNN)
Compare la requête avec chaque vecteur stocké. Précis, mais plus lent à mesure que les données augmentent.
Recherche approximative (ANN)
Utilise l’indice pour cibler d’abord les correspondances probables. Cela est beaucoup plus rapide à grande échelle grâce à des paramètres qui compensent le coût de la mémoire. Les mêmes vecteurs permettent un clustering sémantique.
Sous le capot
Conçue pour des questions constantes et simultanées
Les agents d'IA posent constamment des questions, souvent en même temps. L'agrégation basée sur les hachages calcule les nombres distincts en une seule passe. Le cache des plans de requête réutilise le meilleur plan lorsque la question se répète. Les statistiques d'optimisation échantillonnées omis les balayages complets de la table, de sorte que la collecte des statistiques s'adapte à vos données.
Un produit, deux façons de l’utiliser
TOTALEMENT GÉRÉ
Sur Couchbase Capella
Exécutez Run Operational Insights en tant que service sur AWS, Google Cloud ou Azure (dans certaines régions). Posez vos questions en langage simple avec Capella iQ, désactivez les clusters à la demande ou selon un calendrier précis et payez uniquement pour l’espace de stockage en hors-utilisation, et laissez Couchbase s’occuper de la sauvegarde, du monitoring et des alertes.
Autogestion
Où que vous l'exécutez
Déployez-le sur site ou dans votre propre compte AWS, Azure, Google Cloud ou OCI, sur x86 ou ARM avec un stockage d’objets compatible avec S3. Interrogez les tables Apache Iceberg directement à travers des catalogues REST ou envoyez des métadonnées prêtes pour Prometheus aux outils de monitoring que vous utilisez déjà.
FAQ concernant les Insights opérationnels (anciennement Analytics)
Obtenez des réponses rapides concernant l’analyse en temps réel, l’absence d’ETL, le retour d’informations, les agents IA et les options de déploiement.
Couchbase Operational Insights est une analyse en temps réel intégrée à la plateforme Couchbase. Il consulte des données opérationnelles en JSON en temps réel grâce à SQL++ et renvoie les résultats aux applications et aux agents d’IA pour leur utilisation.
Oui. En octobre 2026, Couchbase Analytics est devenu Couchbase Operational Insights. Capella Analytics et Enterprise Analytics sont désormais des solutions Operational Insights, entièrement gérées ou gérées par les utilisateurs.
Capella Analytics a été rebaptisée Capella Analytics en août 2025, et Capella Analytics est devenue Couchbase Operational Insights en octobre 2026. C’est le même service ; les vidéos, documents et articles du blog plus anciens qui portent la mention “ Columnar ” ou “ Analytics ” décrivent donc Operational Insights.
Non. Les données sont régulièrement mises à jour à partir de Couchbase, d’autres bases de données via Kafka et de la mémoire de stockage des objets dans le cloud. Elle est prête à être consultée au fur et à mesure de ses modifications, sans pipeline ETL ni schéma prédéfini.
Non. Un entrepôt rend compte de ce qui se passe dans l’ensemble de l’entreprise. Insights Operative analyse ce qui se passe actuellement et envoie ensuite une réponse à l’application. De nombreux équipes utilisent les deux, chacun dans son domaine de compétence.
Les résultats réécris dans la base de données opérationnelle deviennent un contexte réel accessible aux agents via le serveur Couchbase MCP. Le clustering sémantique et la recherche vectorielle sont exécutés dans SQL++.
Oui. Il peut être administré de manière autonome sur site ou dans votre propre cloud, ou entièrement géré par Couchbase Capella, avec le même moteur et SQL++. Apache Iceberg est uniquement administré de manière autonome ; Capella iQ n'est géré que de manière complète.
Continuez d'explorer
-
Consultez les Insights opérationnels en action
Voyez comment l’analyse en temps réel et le retour d’information permettent aux agents IA d’avoir une vue d’ensemble en temps réel.
-
Pourquoi les agents d'IA tombent en panne lors de la phase pilote
Apprenez pourquoi les agents ont besoin d’un contexte précis et contrôlé pour passer de la phase pilote à la phase de production.
-
Commencez par les documents
Installez Operational Insights, sous gestion ou autonome, et lancez votre première requête.