PERCHÉ NOSQL?
NoSQL spiegato: cos'è, come funziona e perché è importante
I database NoSQL offrono scalabilità, flessibilità e elevate prestazioni per le applicazioni moderne. Gestiscono i dati non strutturati, supportano l’escalation orizzontale e eliminano le complesse componenti ORM. Ideali per l’intelligenza artificiale, i big data e l’analisi in tempo reale, i NoSQL consentono agilità e sviluppi più rapidi.
Riassunto: Struttura NoSQL e concetti chiave
Per comprendere meglio il funzionamento dei database NoSQL, questa pagina tratta i seguenti argomenti:
- Cos'è un database NoSQL?
- Qual è la differenza tra SQL e NoSQL?
- Tipologie di database NoSQL
- Perché usare NoSQL?
- Tutorial su NoSQL
- Perché i database relazionali non sono sufficienti
- Conclusione
Cos'è un database NoSQL?
Un database NoSQL, acronimo di “not only SQL (Structured Query Language)”, è un database non relazionale progettato per gestire strutture di dati diverse e flessibili. La definizione di NoSQL si riferisce a database che supportano diversi modelli – tra cui documenti, grafici, valori chiave-valore, database a colonne larghe e database vettoriali – offrendo maggiore scalabilità e adattabilità rispetto ai tradizionali database SQL, che si basano su tabelle strutturate e schemi fissa.
Il significato di NoSQL è evoluto con i progressi delle CPU, della RAM, del cloud computing e delle interazioni con l’intelligenza artificiale, consentendo alle moderne basi di dati di gestire in modo efficiente grandi set di dati in tempo reale. scalatura orizzontale Inoltre, grazie alle prestazioni, i database NoSQL garantiscono una distribuzione dei dati senza interruzioni su più nodi, rendendoli la scelta preferita per l'intelligenza artificiale, i big data e le analisi in tempo reale, dove i database tradizionali spesso non riescono a tenere il passo.
SOMMARIO
Il termine NoSQL si riferisce a database che memorizzano i dati in formati flessibili utilizzando modelli come i documenti, i database chiave-valore e i database vettoriali. La loro scalabilità e le loro prestazioni li rendono ideali per le moderne applicazioni che richiedono accesso in tempo reale e gestiscono grandi volumi di lavoro dinamici.
Qual è la differenza tra SQL e NoSQL?
Database SQL e NoSQL differiscono nel modo in cui archiviano e interrogano i dati. I database SQL si basano su tabelle con colonne e righe per recuperare e scrivere dati strutturati, mentre i database NoSQL utilizzano modelli di dati flessibili più adatti ai dati non strutturati e semi-strutturati.
SQL, introdotta per la prima volta negli anni '70, viene ora utilizzata da sviluppatori e analisti di dati in tutto il mondo per trovare e riportare dati archiviati nei sistemi relazionali. I database SQL sono ideali per applicazioni che richiedono integrità dei dati e utilizzano relazioni strutturate e query standardizzate (ad esempio, software per la pianificazione delle risorse aziendali). Sebbene NoSQL Si tratta di un concetto che esiste già dagli anni '60; il termine è stato coniato all'inizio degli anni 2000, poiché divenne fondamentale per gli sviluppatori utilizzare database in grado di memorizzare e recuperare dati per applicazioni in tempo reale.
Vale la pena sottolineare che SQL si sta espandendo per supportare modelli di accesso NoSQL. Ad esempio, molte database relazionali ora supportano il JSON (JavaScript Object Notation) come tipo di dati. Alcune database hanno addirittura esteso SQL per permettere la consultazione diretta di strutture JSON, come Couchbase, che supporta SQL++ (SQL per JSON).
SOMMARIO
La differenza tra i database SQL e NoSQL risiede nella loro struttura e nelle loro applicazioni. I database SQL utilizzano tabelle, il che li rende ideali per le applicazioni che richiedono una struttura rigida e dati normalizzati. In contrasto, i database NoSQL utilizzano modelli flessibili, rendendoli più adatti alla gestione di dati non strutturati e semistrutturati, consentendo al contempo l'accesso in tempo reale.
Tipologie di database NoSQL
Questi sono i tipi più popolari di modelli di accesso alle database NoSQL:
- Store di valori chiave e valori I dati associati a un gruppo vengono archiviati in tabelle indipendenti, dove i record sono identificati da chiavi univoci per una facile ricerca. Hanno una struttura sufficiente a riprodurre i valori delle database relazionali, aggiungendo al contempo i vantaggi di prestazioni e accessibilità offerti dalla struttura di accesso ai dati NoSQL. I dati chiave-valore possono essere facilmente memorizzati in una cache, dove i dati più accessati vengono conservati in memoria per una lettura rapida. Le operazioni di scrittura, aggiornamento e nuove richieste di lettura vengono indirizzate programmaticamente verso lo storage persistente. I database chiave-valore danno priorità alle velocità di accesso atomiche rispetto alla coerenza, all’isolamento e alla durata della conservazione.
- Database di documenti In primo luogo, memorizzano le informazioni come documenti logici, inclusi i documenti JSON. Ad esempio, questi sistemi possono anche memorizzare documenti XML o oggetti binari. Grazie alla natura flessibile del formato e al grado di controllo che offrono agli sviluppatori, i database di documenti sono preferibili quando si creano applicazioni basate sui dati.
- Database a colonne larghe e a colonne Archivare i dati in Colonne invece che righe, che ottimizza le prestazioni delle query per i carichi di lavoro analitici e il trattamento di grandi volumi di dati. Come i database key-value, anche i database a colonne ampie presentano alcune strutture NoSQL di base, pur mantenendo la flessibilità, la gestione dei dati e le capacità di aggregazione.
- Basi dati di ricerca Consentire agli utenti di effettuare query su dati semistrutturati e non strutturati, come pagine web, documenti, mappe, documenti JSON e XML. Utilizzano indici invertiti specializzati per individuare parole chiave all’interno dei testi per trovare dati pertinenti, simile a “googlare” qualcosa online.
- Database grafici utilizzare strutture grafiche come nodi, bordi e proprietà per definire le relazioni tra gli elementi di dati memorizzati. I database grafici sono utili per identificare i modelli di relazione presenti non strutturato e semi-strutturato informazioni, creazione di reti sociali, componenti assemblati, strutture organizzative e ontologie. I database grafici sono ampiamente utilizzati nei motori di raccomandazione, nel riconoscimento dei modelli di frode, nelle funzioni di intelligenza artificiale predittiva e nel collegamento delle reti sociali.
- Database di serie temporali Consentire agli utenti di monitorare i cambiamenti dei dati nel tempo e rilevare anomalie nei grafici dei prezzi delle azioni, nei registri dei macchinari, nei monitor di stato e nei sistemi di allarme. Poiché i dati delle serie temporali cambiano rapidamente, questi database generano enormi quantità di informazioni, con il rischio di incorrere in problemi di scalabilità.
- Database vettoriali aiutare a migliorare l'accuratezza dei modelli di IA generativa fornendo suggerimenti (vectori) che aiutali a trovare le risposte “giuste” all'interno dei propri dati di training. I database vettoriali operano all'interno di processi di generazione arricchita con recupero (RAG) per memorizzare le incorporazioni vettoriali che aiutano a ridurre le allucinazioni dell'IA generativa e a mantenere il progresso del modello.
SOMMARIO
I modelli di accesso ai dati più comuni nel NoSQL includono i database chiave-valore, i database documentali, i database a larga colonna e a colonne, i database di ricerca, i database grafici, i database di serie temporali e i database vettoriali. Ogni tipo di NoSQL presenta caratteristiche uniche, come la scalabilità, la flessibilità dello schema e l'efficienza delle query. È necessario esplorare questi tipi di NoSQL in modo approfondito per decidere quale database NoSQL utilizzare.
Perché usare NoSQL?
Le aziende preferiscono i database NoSQL per la loro capacità di gestire grandi volumi di dati diversi e in costante crescita. Alcuni vantaggi specifici dei database NoSQL includono:
- Scalabilità: I database NoSQL si scalano orizzontalmente distribuendo i dati su più server, rendendoli ideali per carichi di lavoro di grandi dimensioni.
- Flessibilità: A differenza dei database relazionali, i NoSQL consentono lo storage dei dati senza schemi, facilitando la memorizzazione e la gestione dei dati non strutturati o semi-strutturati.
- Prestazioni elevate: Ottimizzate per le operazioni di lettura e scrittura rapide, le database NoSQL riducono la complessità delle query e migliorano i tempi di risposta per le applicazioni in tempo reale.
- Vari modelli di dati: Le basi di dati NoSQL favoriscono i modelli di dati chiave-valore, documenti, colonne larghe, ricerca e serie temporali, rendendoli ideali per molteplici utilizzi.
- Big data e elaborazione in tempo reale: Il NoSQL è progettato per gestire enormi quantità di dati, il che lo rende ideale per Analisi dei big data, IoT, caching e gestione delle sessioni.
- Cloud e computing distribuito: I database NoSQL funzionano bene negli ambienti cloud garantendo elevata disponibilità e tolleranza ai guasti nei sistemi distribuiti.
- Sviluppo e iterazione più semplici: Con NoSQL, gli sviluppatori possono sfruttare le competenze già acquisite nel campo dell'SQL e utilizzare un database che si integra con strumenti familiari., Ambienti di sviluppo integrati (IDE), e i framework.
Il database NoSQL multiuso di Couchbase è particolarmente adatto alle applicazioni di intelligenza artificiale poiché offre:
1. Elevata performance e bassa latenza
- Architettura a memoria di primo livello: Utilizza un design a memoria distribuita per le operazioni di lettura e scrittura rapide, riducendo così la latenza dell'inferenza dei modelli di intelligenza artificiale.
- Tempi di risposta inferiori ai millisecondi: Assicura l'accesso ai dati in tempo reale, che è fondamentale per casi d'uso come motori di raccomandazione, la rilevazione delle frodi e l'analisi predittiva.
2. Scalabilità e architettura distribuita
- Scalatura multidimensionale: È possibile scalare in orizzontale o in verticale per gestire enormi set di dati IA e volumi di lavoro in crescita.
- Riparazione dei dati in caso di replica del data center (XDCR): Supporta implementazioni di IA in più regioni e in più cloud con elevata disponibilità.
3. Archiviazione dei dati multimodale e flessibile
- Database NoSQL basato su JSON: Archivia dati non strutturati e semi-strutturati, essenziali per le applicazioni di intelligenza artificiale che elaborano dataset diversi.
- Supporto alla ricerca vettoriale: Aiuta gli sviluppatori a creare app tramite la ricerca vettoriale e si integra con Catena di Langhe e LlamaIndex.
4. Capacità di intelligenza artificiale e analisi integrate
- SQL per JSON (SQL++): Interrogazione simile a SQL con indagine, ricerca full-text e analisi per l’allenamento e l’inferenza dei modelli AI.
- Eventing e elaborazione dei flussi di dati: Abilita Analisi IA in tempo reale utilizzando funzioni integrate e un'architettura basata su eventi.
- Integrazione con framework di IA/ML: Funziona con TensorFlow, PyTorch e Apache Spark per l'allenamento e lo sviluppo di modelli AI.
5. Implementazione dell'IA su più cloud e edge
- Ambiente multicloud: È disponibile su Amazon Web Services (AWS), Microsoft Azure e Google Cloud, così gli sviluppatori possono sviluppare e implementare applicazioni IA nel cloud di loro scelta.
- Supporto per l'elaborazione su scala ridotta (edge computing): Ideale per applicazioni IA in tempo reale su dispositivi mobili e IoT, riducendo la dipendenza dal cloud e migliorando i tempi di risposta.
6. Sicurezza e conformità
- Sicurezza di livello enterprise: Offre la crittografia integrata, il controllo dell'accesso basato sui ruoli (RBAC) e la conformità alle normative come GDPR, HIPAA e SOC 2.
- Isolamento dei dati e governance: Supporta il monitoraggio della conformità e la rilevazione delle frodi basati sull'intelligenza artificiale.
7. Economicità dei costi
- Alta performance a costi inferiori: Riduce i costi dell'infrastruttura cloud gestendo in modo efficiente le risorse e minimizzando il trasferimento dei dati.
- Base dati multimodale: Consente agli sviluppatori di archiviare e interrogare più tipi di dati, riducendo la necessità di database aggiuntivi e risparmiando sui costi potenziali di integrazione, le tariffe di licenza e le spese per il cloud computing.
I casi d’uso specifici per le applicazioni di intelligenza artificiale con Couchbase includono:
- Raccomandazioni personalizzate: E-commerce e servizi di streaming
- Rilevamento delle frodi e analisi dei rischi: Banking e cybersecurity
- Chatbot e IA agentica: Assistenza clienti e assistenti virtuali
- IoT e edge AI: Dispositivi intelligenti e sistemi autonomi
SOMMARIO
Le aziende preferiscono i database NoSQL per la loro flessibilità, scalabilità e elevate prestazioni nel gestire grandi volumi di dati diversificati e in crescita. Inoltre, i database NoSQL utilizzano l’escalation orizzontale, distribuendo i dati su più server per mantenere le prestazioni quando i carichi di lavoro aumentano. Queste funzionalità li rendono adatti alle applicazioni di intelligenza artificiale, ai sistemi IoT, ai servizi di campo adattivi e alla cache e alla gestione delle sessioni.
Le aziende del Global 2000 stanno rapidamente adottando i database NoSQL per alimentare le loro applicazioni fondamentali:
-
"Abbiamo scoperto che la tecnologia di replica tra i data center per Couchbase era superiore, soprattutto per i carichi di lavoro di grandi dimensioni".
Claus Moldt, CIO, FICO<1ms
tempi di risposta

-
"Con meno della metà dei server, possiamo aumentare le prestazioni e ottenere un'architettura molto più scalabile".
Amir Ish-Shalom, Direttore senior delle operazioni, Viber15B
eventi di chiamata e messaggio/giorno

-
"Couchbase è un archivio dati distribuito altamente scalabile che svolge un ruolo fondamentale nei nostri sistemi di caching".
Michael Kehoe, Ingegnere senior per l'affidabilità del sito, LinkedIn10M+
query al secondo

-
"I box di classe enterprise costano un sacco di soldi. Possiamo scalare ed essere altamente disponibili con hardware di base".
Thomas Vidnovic, Architetto di soluzioni, Marriott International4K
transazioni al secondo
Tutorial su NoSQL
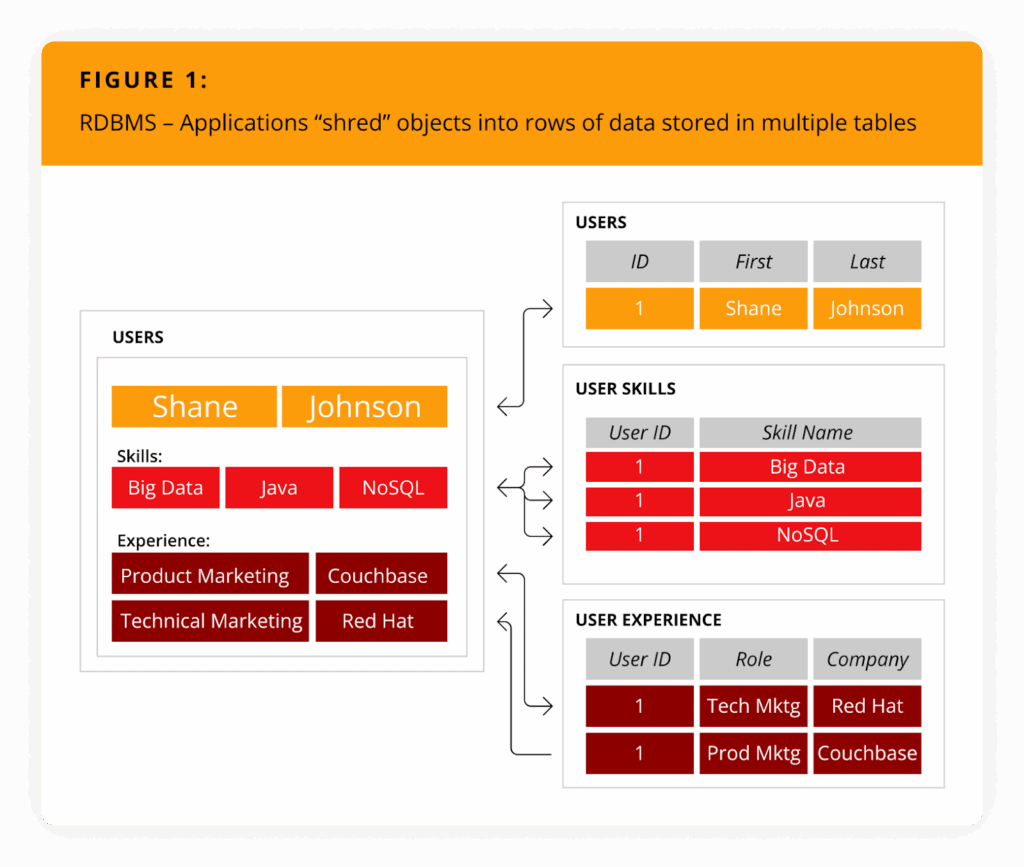
Come si confronta NoSQL con le database relazionali? Vediamolo più da vicino. Il seguente tutorial illustra un’applicazione NoSQL utilizzata per gestire curriculum. Interagisce con i curriculum come un oggetto (cioè l’oggetto utente), contiene un array per le competenze e dispone di una raccolta per le posizioni. Alternativamente, scrivere un curriculum in una database relazionale richiede che l’applicazione “riduca” (normalizzi) l’oggetto utente.
Per archiviare questo curriculum sarebbe necessario che l’applicazione inserisse sei righe in tre tabelle, come illustrato nella figura seguente: Figura 1.
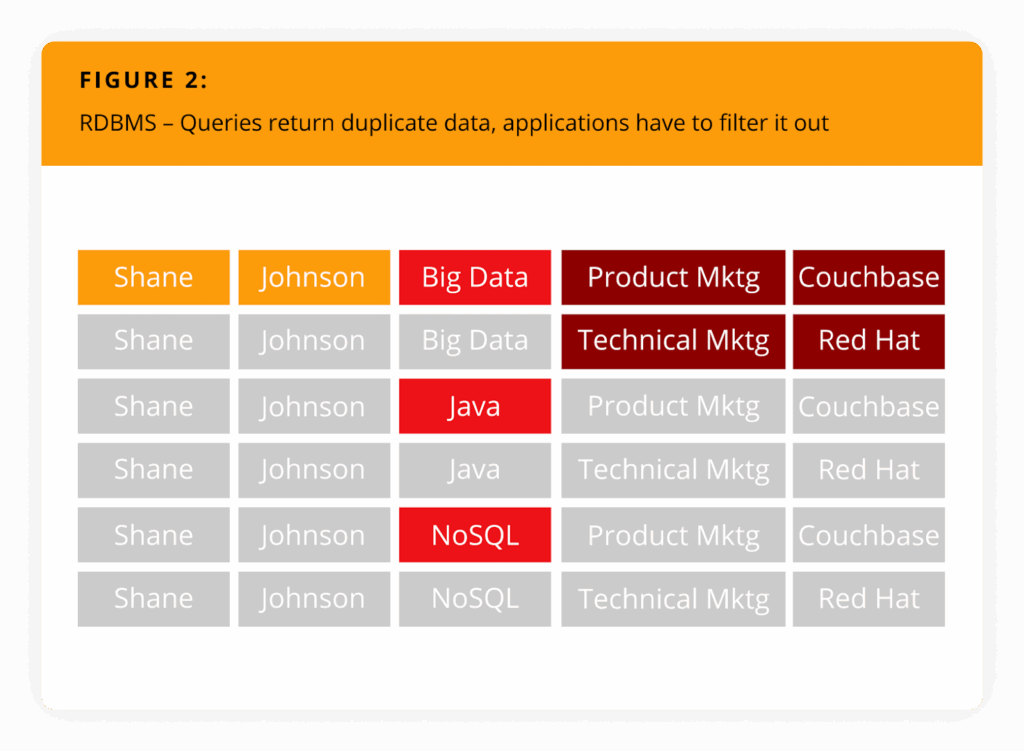
E, per leggere questo profilo, l'applicazione dovrebbe leggere sei righe provenienti da tre tabelle, come illustrato nell'immagine seguente: Figura 2.
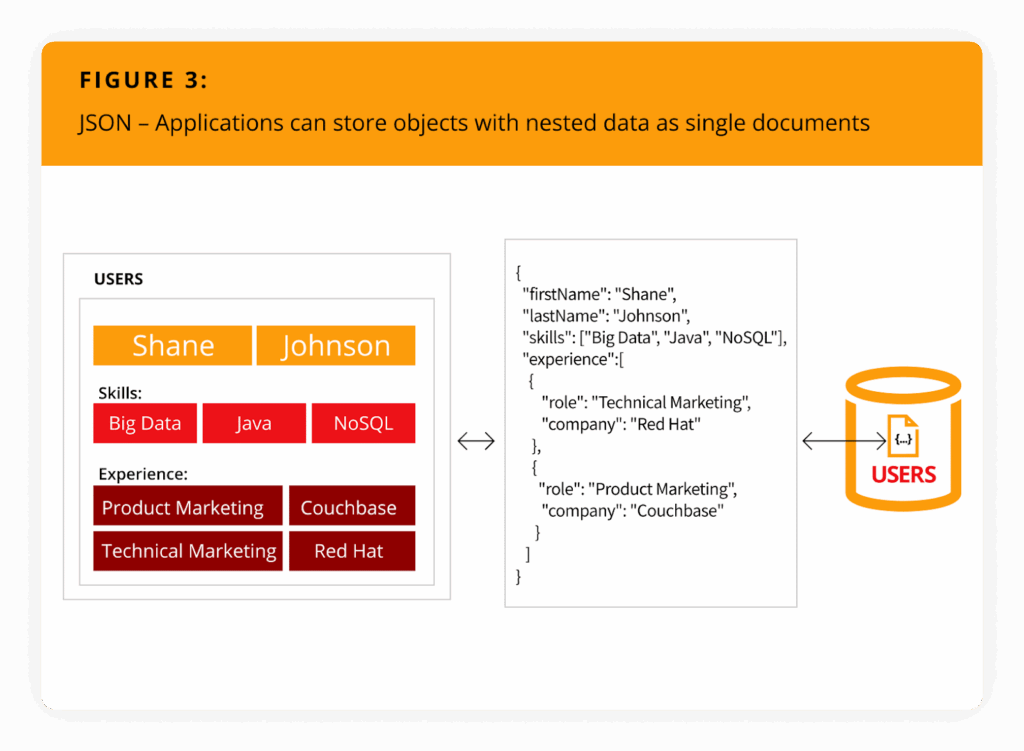
Il formato JSON non solo elimina il problema dell’impatto di compatibilità tra oggetti e relazionali, ma anche gli oneri dei framework per l’orm (Object-Relational Mapping). Inoltre semplifica lo sviluppo delle applicazioni poiché gli oggetti possono essere letti e scritti senza doverli normalizzare (cioè un singolo oggetto può essere letto o scritto come un singolo documento), come illustrato nella figura seguente: Figura 3.
E cosa dire di query e SQL?
Alcuni potrebbero sostenere che interrogare i database NoSQL sia più complicato, ma questa è una comune erronea idea. La flessibilità intrinseca dei database NoSQL orientati ai documenti consente loro di gestire dati strutturati e non strutturati in modo uguale, e nuovi strumenti consentono interrogazioni più rapide di quanto non sia mai stato possibile prima.
Couchbase supporta SQL++, che consente agli sviluppatori di sfruttare le potenzialità di SQL e la flessibilità di JSON. Non solo supporta le consuete istruzioni SELECT / FROM / WHERE, ma anche aggregazioni (GROUP BY), ordinamento (SORT BY), giunzioni (LEFT OUTER / INNER) e query su array e collezioni nidificati. Inoltre, le prestazioni delle query possono essere migliorate grazie agli indici composti, parziali e coprenti.
- SQL
- SQL++
SELECT RTRIM(p.FirstName) + ' ' + LTRIM(p.LastName) AS Nome, d.City
DALLA tabella AdventureWorks2025.Person.Person AS p
INNER JOIN AdventureWorks2025.HumanResources.Employee e ON p.BusinessEntityID = e.BusinessEntityID
INNER JOIN
(SELECT bea.BusinessEntityID, a.City
DALLA tabella AdventureWorks2025.Person.Address AS a
INNER JOIN AdventureWorks2025.Person.BusinessEntityAddress AS bea
ON a.AddressID = bea.AddressID) AS d
ON p.BusinessEntityID = d.BusinessEntityID
ORDINE PER P.LastName, P.FirstName;
SELECT RTRIM(p.FirstName) || ' ' || LTRIM(p.LastName) AS Nome, d.City
DALLA tabella AdventureWorks2025.Person.Person AS p
INNER JOIN AdventureWorks2025.HumanResources.Employee e ON p.BusinessEntityID = e.BusinessEntityID
INNER JOIN
(SELECT bea.BusinessEntityID, a.City
DALLA tabella AdventureWorks2025.Person.Address AS a
INNER JOIN AdventureWorks2025.Person.BusinessEntityAddress AS bea
ON a.AddressID = bea.AddressID) AS d
ON p.BusinessEntityID = d.BusinessEntityID
ORDINE PER P.LastName, P.FirstName;
SOMMARIO
I database NoSQL archiviano i dati in documenti JSON flessibili, eliminando la necessità di complessi strumenti di mapping oggetti-relazionali (ORM) e rendendo più facile la gestione di dati strutturati e non strutturati. Questo approccio semplifica lo sviluppo delle applicazioni, poiché gli oggetti vengono archiviati e recuperati come un unico documento anziché essere suddivisi in diverse tabelle. Couchbase migliora ulteriormente le funzionalità di query con SQL++, che supporta la sintassi SQL familiare.
Perché i database relazionali non sono sufficienti
I sistemi di gestione dei database relazionali sono nati nell’era dei mainframe e delle applicazioni aziendali – molto prima di Internet, del cloud, dei big data, dei dispositivi mobili, dell’intelligenza artificiale e delle imprese oggi massicciamente interattive. Questi database sono stati progettati per essere gestiti su un singolo server – più grande è il server, meglio è, e il loro design era destinato a ottimizzare l’utilizzo delle risorse scarse per lo storage, la memoria RAM e il processamento. L’unico modo per aumentare la capacità di questi database era aggiornare i server (processori, memoria e storage) per scalare. Nel corso degli anni, la maggior parte delle restrizioni di progettazione originali, tra cui la normalizzazione, la tipizzazione dei dati robusta e l’integrità relazionale, è stata semplificata o eliminata.
I sistemi di gestione dei database NoSQL sono nati in seguito alla crescita esponenziale di Internet e all'emergere delle applicazioni web. Google ha rilasciato Articolo di ricerca su Bigtable nel 2006, e Amazon ha rilasciato Articolo di ricerca di Dynamo Nel 2007 – questi documenti descrivevano in dettaglio come le due società avevano progettato le proprie basi di dati per soddisfare le esigenze in continua evoluzione delle aziende. In definitiva, le moderne basi di dati si sono concentrate su svilupparsi con agilità, rispondere alle esigenze in continua evoluzione, e eliminazione della trasformazione dei dati.
SOMMARIO
I database relazionali sono stati originariamente progettati per ambienti a singolo server al fine di ottimizzare le risorse limitate, ma con l’aumento delle esigenze di dati, hanno dovuto affrontare problemi di scalabilità. Spinti dalla crescita di Internet e delle applicazioni web, sono nati i database NoSQL per affrontare queste limitazioni, concentrandosi su agilità, scalabilità e riduzione delle complessità della trasformazione dei dati.
Conclusione
Perché i database NoSQL sono importanti? Mentre le aziende si orientano verso l’intelligenza artificiale, supportata da cloud, mobile, social media, machine learning e Tecnologie GenAI – Gli sviluppatori e i team di operazioni devono costruire e mantenere applicazioni web, mobile e IoT più velocemente e su una scala più ampia. La NoSQL flessibile e ad alte prestazioni è sempre più la tecnologia di database scelta da loro.
Migliaia di Impresa tra le 2000 più importanti al mondo Gli sviluppatori e milioni di sviluppatori che lavorano in piccole aziende e startup hanno adottato il NoSQL. Per molti, l'uso del NoSQL è iniziato con un cache, una dimostrazione di concetto o un'applicazione piccola, poi si è esteso a applicazioni target fondamentali per la missione aziendale prima di diventare il fondamento per tutta la realizzazione delle applicazioni.
Con i database NoSQL, le aziende possono svilupparsi con maggiore agilità, operare su qualsiasi scala e offrire le prestazioni e la disponibilità necessarie per soddisfare le esigenze delle aziende del settore dell’economia digitale.
Esplora le risorse relative ai database NoSQL
-
Whitepaper
Perché i database NoSQL? Una guida per gli sviluppatori
-
Pagina web
Comparazione tra database cloud NoSQL
-
Whitepaper
Perché i database NoSQL per le app basate sull'intelligenza artificiale?