RELEASE DE COUCHBASE
Des agents et des analyses plus intelligents, juste là où se trouvent vos données
L’agent Memory et le serveur MCP rejoignent les services de Data Plane IA gérés par Couchbase Capella, avec des modèles sans serveur et des embeddings privés. Et Couchbase Analytics devient désormais Operational Insights.
20+
Des outils MCP Server prêts à l’emploi, uniquement lisibles par défaut
94%
récapitulation sur la session unique LongMemEval-M
1
Question SQL pour le regroupement par signification sémantique et l'agrégation
La Couchbase que vous connaissez devient encore meilleure pour les agents
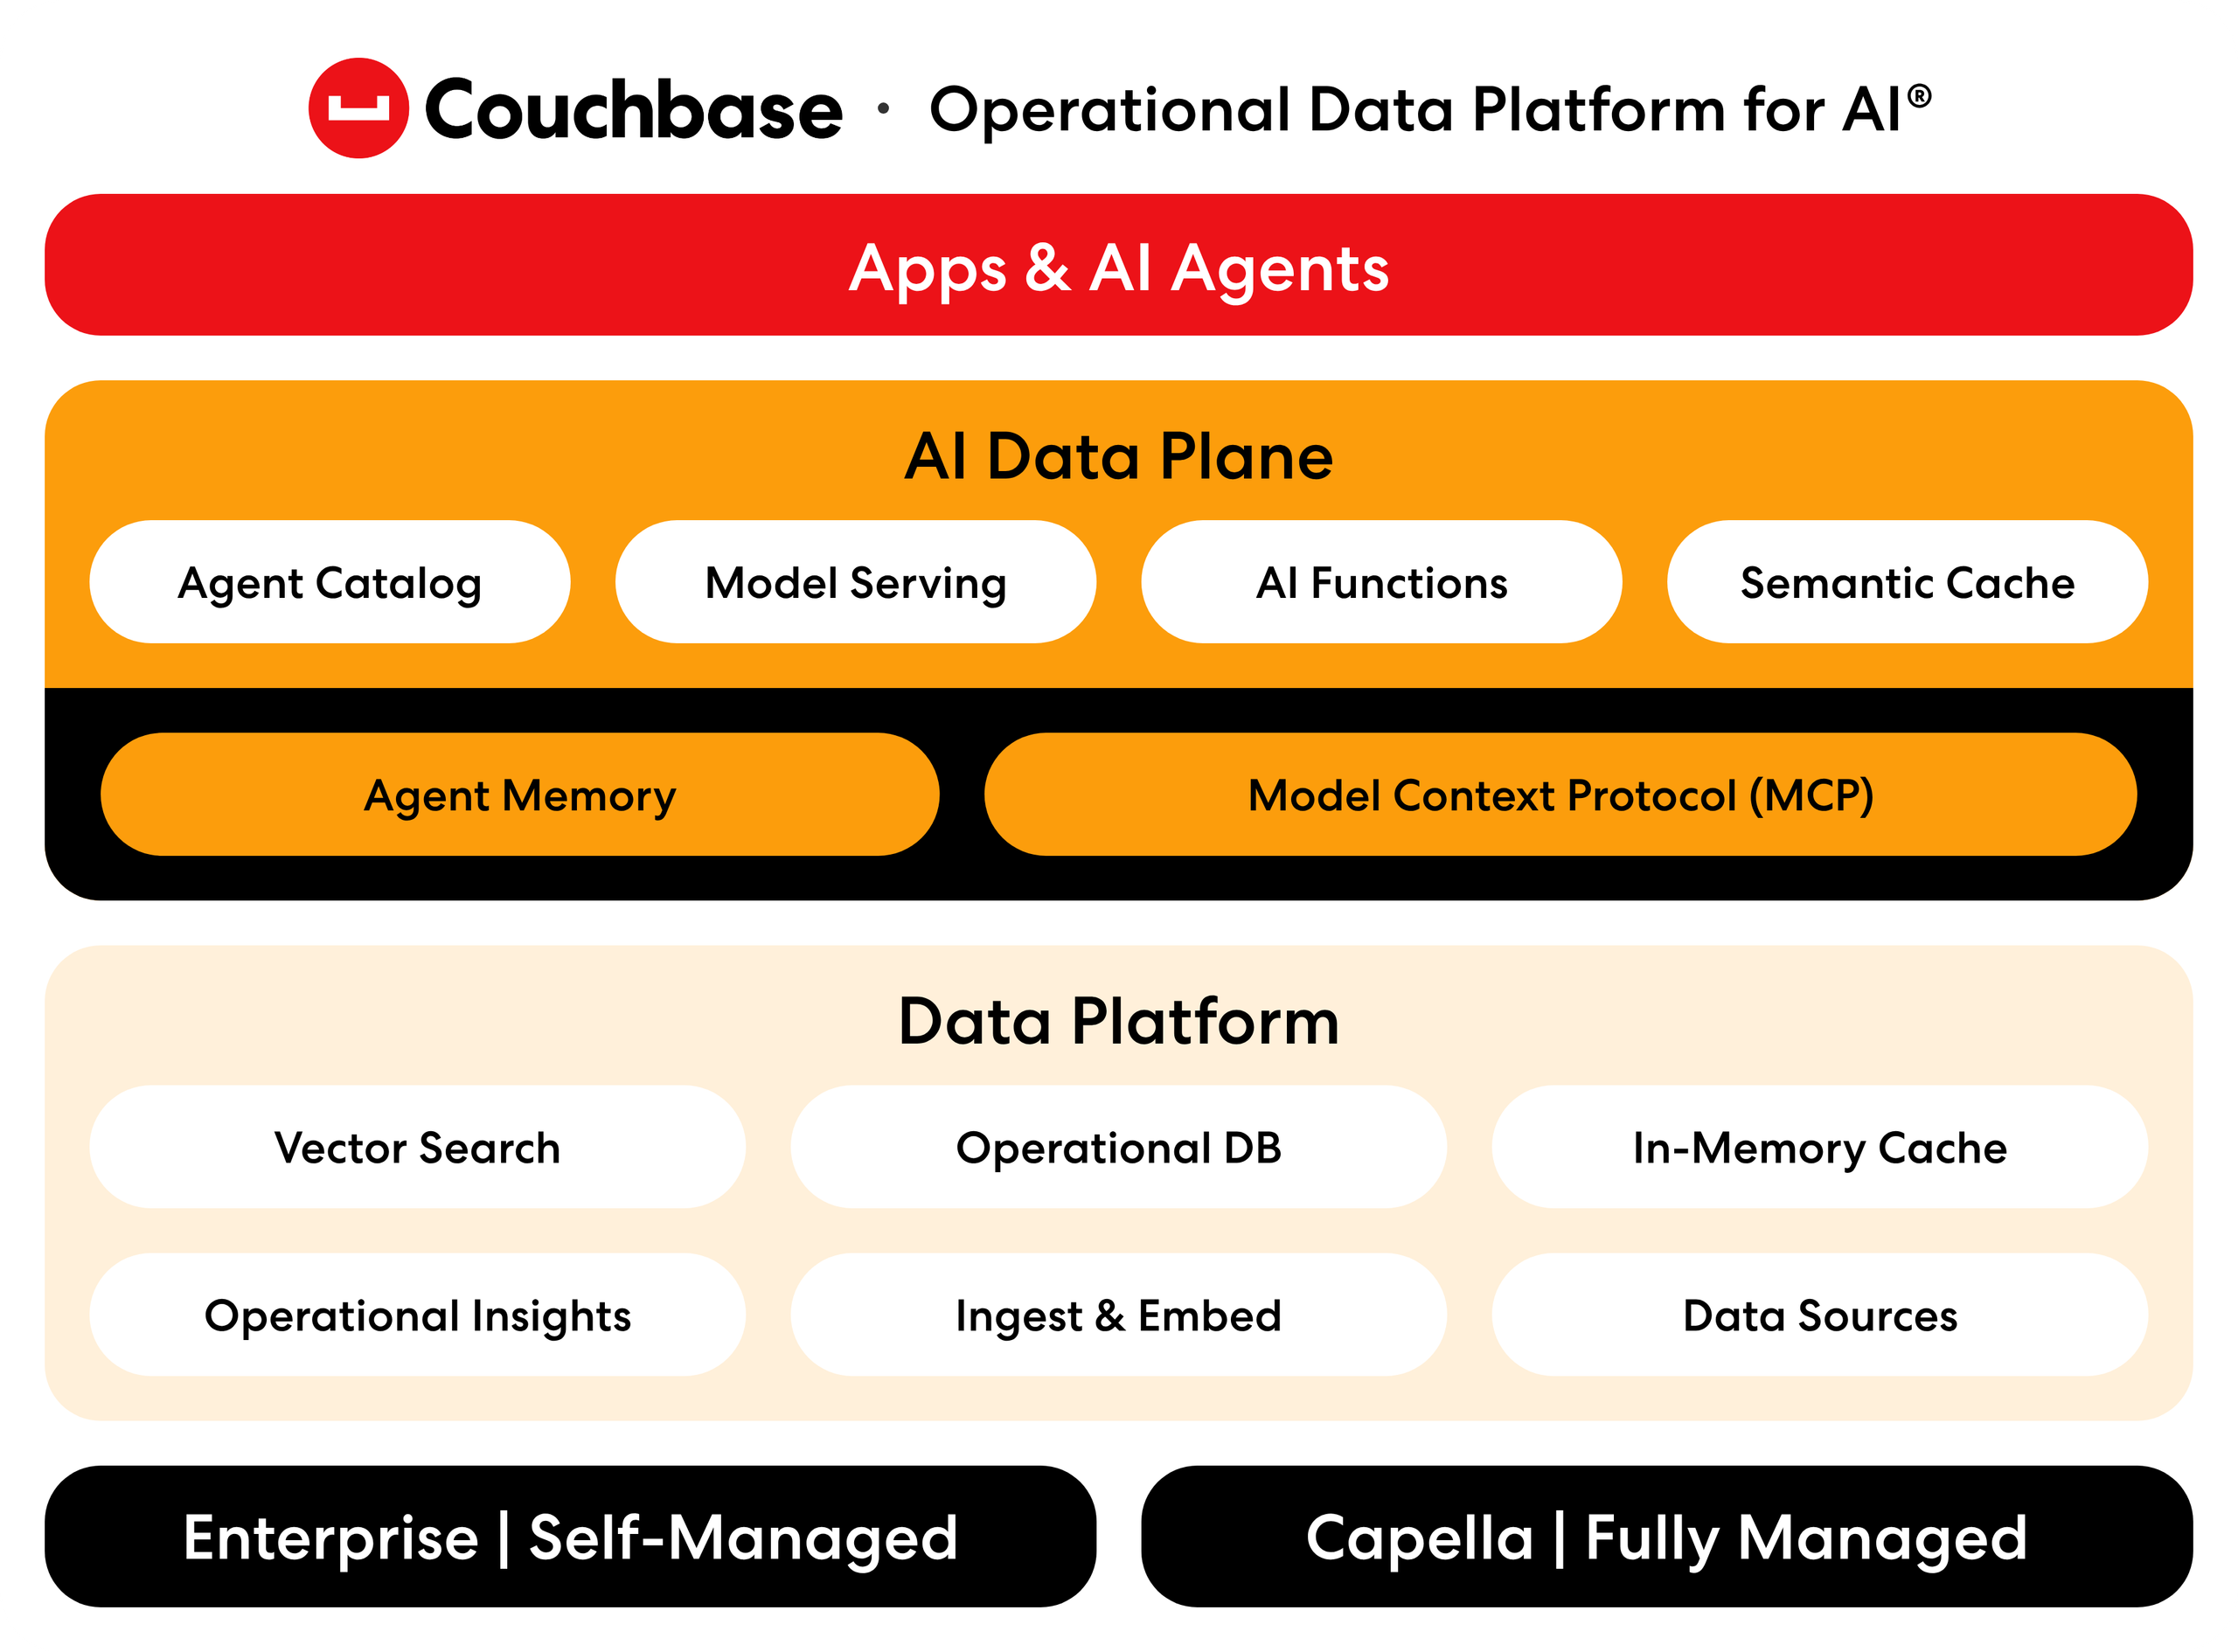
L'agent Memory et le serveur MCP sont désormais entièrement gérés dans Couchbase Capella, aux côtés de l'agent Catalog et du reste du plane d'IA. Couchbase Analytics a également reçu un nouveau nom : Operational Insights, qui propose de nouvelles fonctionnalités puissantes permettant de rechercher et de regrouper les données en fonction de leur signification sémantique dans le langage SQL.
Gestion complète
Couchbase installe, patche et met à jour manuellement l’agent Memory et le serveur MCP pour vous.
Les mêmes API, deux déploiements
Les agents Memory et MCP Server utilisent le même modèle et les mêmes API, que Capella les exécute ou que vous les exécutez vous-même.
Les données restent sécurisées dans votre périmètre
Les embeddings se déplacent via le réseau privé vers Amazon Bedrock, et vos données opérationnelles restent dans Couchbase.
Analytics, rebaptisé et amélioré
Operational Insights prend désormais en charge la recherche vectorielle, le clustering sémantique et les UDFs Python (gestion autonomes).
Nouveaux outils de gestion de données IA, conçus pour la production
Rationalisez le déploiement des agents IA de la phase pilote à la production grâce à la mémoire persistante des agents, à la fédération Apache Iceberg lakehouse et au support Rust. Et pour les appareils mobiles, à la synchronisation peer-to-peer via Bluetooth et au support React Native.
Mémoire de l'agent géré
Mémoire durable des agents, en tant que service Capella, avec une dégradation basée sur le TTL, une résolution des conflits et l'intégration d'OIDC/OAuth2.
Serveur MCP géré
Un serveur MCP isolé et sans partage dans votre environnement Capella, doté d’outils prêts à l’emploi et de paramètres par défaut non modifiables.
Modèles de frontière sans serveur
Claude, Llama 4, Nova, Mistral et Cohere de Amazon Bedrock. Paiement par token, sans limite de taille ou de réserve de GPU.
Vectorisation privée de Bedrock
Générez des embeddings à partir de votre propre compte Amazon Bedrock via AWS PrivateLink, hors de l’Internet public.
Couchbase Analytics est désormais Operational Insights
La même plateforme, un nouveau nom. Capella Analytics devient désormais Capella Operational Insights et Enterprise Analytics devient Enterprise Operational Insights. La dernière version ajoute la recherche vectorielle, le clustering sémantique et les UDF Python (lancés en premier pour les déploiements auto-gérés).
Recherche vectorielle dans SQL
Les déploiements auto-gérés permettent de rechercher par signification dans un langage SQL simple. Les vecteurs et un index VTREE permettent une recherche approximative rapide à l’échelle. Pas besoin d’une base de données vectorielle séparée.
Clustering sémantique
CLUSTER PAR groupes en fonction de leur signification, puis compte et agrège chaque groupe dans la même requête. Trouvez des thèmes dans les commentaires, les tickets ou les réclamations sans avoir à effectuer de marquage manuel (gestion autonome).
UDFs Python
Écrivez des fonctions personnalisées en Python et appelez-les à partir de SQL dans les déploiements auto-gérés. Exécutez vos propres modèles ML là où les données se trouvent, sans avoir à exporter les données vers un service séparé.
Des requêtes plus rapides et plus efficaces
Le cache des plans de requête évite la planification des requêtes répétées, l’agrégation basée sur des hachages compte les valeurs DISTINCT lors d’une seule passe de requête et les statistiques échantillonnées de l’optimiseur permettent d’éviter les scans complets de la table.
Interrogations multisteulement
Envoyez plusieurs commandes SQL++ dans une seule requête, afin que l'analyse en plusieurs étapes nécessite moins de code d'application.
Un produit, deux déploiements
Capella Operational Insights est entièrement géré dans le cloud. Enterprise Operational Insights fonctionne sur la même plateforme sur site ou dans votre propre cloud.
Une plateforme pour les données, la mémoire et les modèles
Votre historique opérationnel, la mémoire des agents, l’accès réglementé, les modèles et les analyses sont gérés sur une même base Couchbase, avec SQL++ pour les données opérationnelles et analytiques. Cela signifie moins de systèmes à synchroniser et un seul endroit pour définir les règles d’accès.
Un contexte qui se transmet
Les agents conservent des données durables, un contexte évolutif et une mémoire sémantique dans un même magasin JSON. Les utilisateurs ne se répètent plus et votre équipe ne doit plus synchroniser des systèmes de mémoire séparés.
Contrôle d’accès en un seul endroit
Le Couchbase MCP Server offre à chaque agent et outil une interface standard ouverte permettant d’accéder aux données Couchbase gérées, au lieu d’une intégration personnalisée par agent, susceptible de créer des conflits de permissions.
Moins de coûts pour exploiter l'IA
Un contexte adapté réduit les dépenses liées aux tokens par appel, tandis que le prix par token signifie qu’il n’y a pas de GPU inutilisés à payer.
Informez vos agents sur ce qu'ils peuvent utiliser
Écrivez les résultats de Operational Insights vers Couchbase, où les applications et les agents y agissent lors de la prochaine lecture du Data Plane d’IA.
Ce que disent les clients
-
“Couchbase était supérieur, surtout pour les charges de travail importantes.”
Claus Moldt, CIO, FICO<1ms
délais de réponse
24×365
temps de fonctionnement de l'application

Deux femmes d'affaires travaillant sur un ordinateur portable assises sur un canapé pendant la pause café dans un espace de travail moderne. -
“Les données de communication en temps réel et les requêtes à très forte intensité de transactions améliorent considérablement les performances et la stabilité de l’application Assistant AI.”
Andy Qiu, PDG, Jinmu8K
opérations par seconde
10ms
délais de réponse

-
“ À mesure que nous avons évolué vers des tâches nécessitant une intervention humaine, cette collaboration était une extension naturelle de notre partenariat. ”
Patrick Ferriter, VP de produit, Agora<.5
cible sec par transaction d'agent

Vous voulez en savoir plus ?
Blog : Qu’y a-t-il de nouveau dans la version Couchbase octobre 2026
Un tour d'horizon de tout ce qui sera généralisé à partir du 19 octobre, des services d'IA gérés aux nouveaux modèles et aux embeddings privés.
Vous apprendrez comment :
- La mémoire de l’agent géré et le serveur MCP fonctionnent sur Couchbase Capella, et les fonctionnalités restent les mêmes si vous gérez vous-même votre infrastructure.
- Les modèles de serveur-sans-frontière d'Amazon Bedrock fonctionnent, notamment la facturation par jeton dans les crédits Capella
- La vectorisation privée empêche le trafic d’être inséré sur l’Internet public
Vidéo : Présentation de Couchbase Operational Insights
Vos agents IA ne sont aussi bons que les données sur lesquelles ils s’appuient. Dans cette vidéo, vous verrez comment Operational Insights trouve des réponses dans vos données en temps réel, de sorte que les agents agissent en fonction de ce qui se passe maintenant, et non de la copie de hier.
Vous verrez comment Operational Insights :
- Pose des questions sur vos données JSON telles qu’elles sont, sans les effilocher ni créer d’pipeline préalablement
- Détecter des motifs plutôt que des totaux en regroupant les enregistrements selon leur signification, en parallèle des calculs habituels de comptage et de somme.
- Envoie les réponses directement vers vos applications et vos agents, afin qu'ils disposent toujours des informations les plus récentes