
Temos o prazer de anunciar o lançamento do Couchbase Lite 3.2 com suporte para busca vetorial. Este lançamento acontece na sequência de suporte a busca vetorial no Capella e Couchbase Server 7.6. Agora, com suporte a busca vetorial no Couchbase Lite, nós permitimos suporte de nuvem a borda para busca vetorial alimentando aplicações de IA na nuvem e na borda.
Nesta postagem do blog, discutirei os principais benefícios de apoiar a busca vetorial no edge, incluindo uma breve análise de casos de uso que se enquadram em suas aplicações Couchbase Lite.
O que é Pesquisa Vetorial?
Busca vetorial é uma técnica para recuperar semanticamente itens similares com base em incorporação de vetores representações dos itens em um espaço multidimensional. Métricas de distância são usadas para determinar a similaridade entre os itens. A Busca Vetorial é um componente essencial da IA generativa e aplicações de IA Preditiva.
Pilha Mobile do Couchbase
Se você é novo no Couchbase, aqui vai uma breve introdução ao Couchbase Mobile.
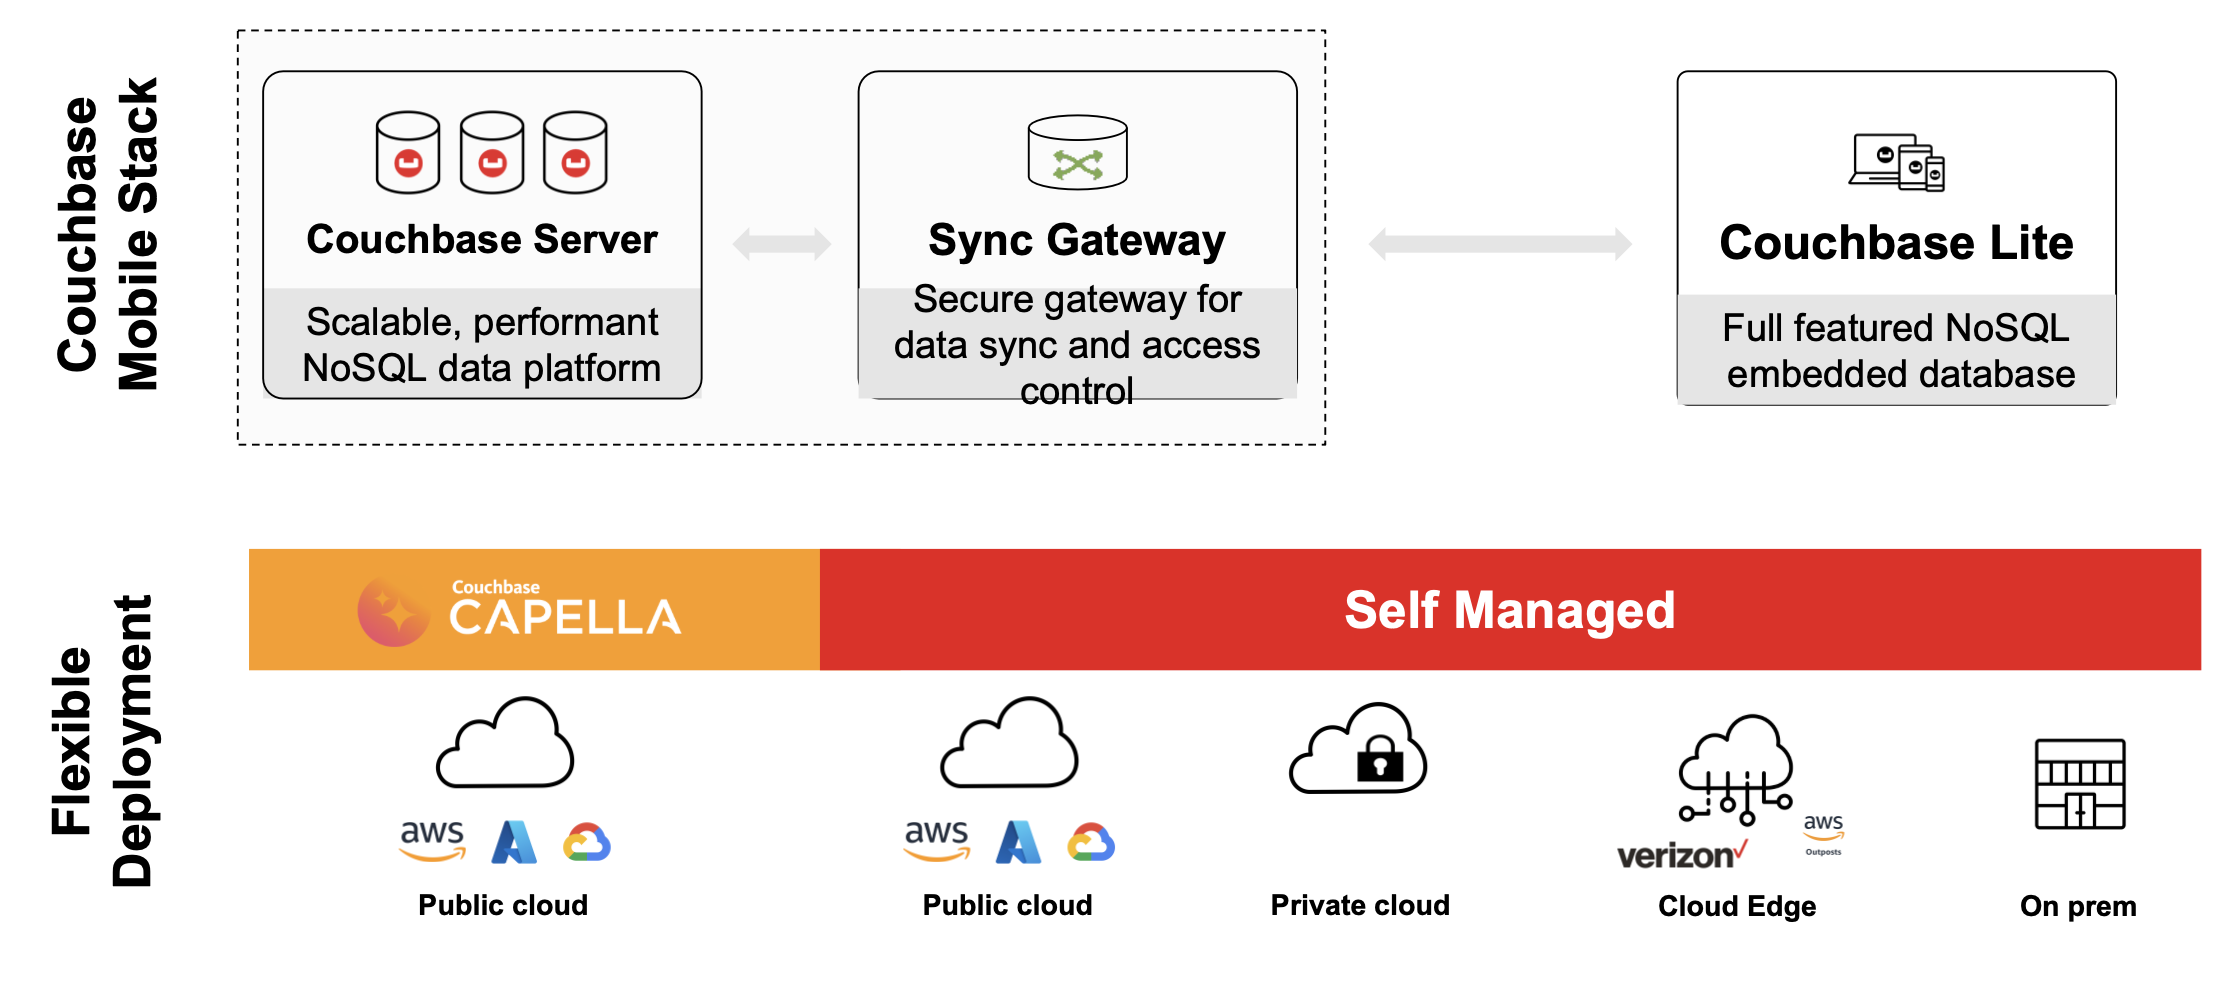
O Couchbase Mobile é um offline-first, plataforma de banco de dados de nuvem a borda. É composta pelo seguinte:
Banco de dados em nuvemDisponível como um Banco de Dados como Serviço (Database-as-a-Service) totalmente gerenciado e hospedado com Couchbase Capella, ou implantar e hospedar Couchbase Server por conta própria.
Banco de dados embutido Couchbase Lite é um banco de dados embarcado NoSQL completo para aplicativos móveis, de desktop e de IoT.
Sincronização de Dados: Um gateway seguro para sincronização de dados pela web, bem como sincronização ponto a ponto entre dispositivos. Oferecido como sincronização totalmente hospedada e gerenciada com Serviços de Aplicativo Capella, ou instalar e gerenciar Couchbase Sync Gateway você mesmo.
Confira o nosso documentação para mais informações.
Casos de Uso e Benefícios da Busca Vetorial
Embora os benefícios de busca vetorial são bem compreendidos, por que você iria querer busca vetorial na borda?
Busca Semântica em Modo Offline-First
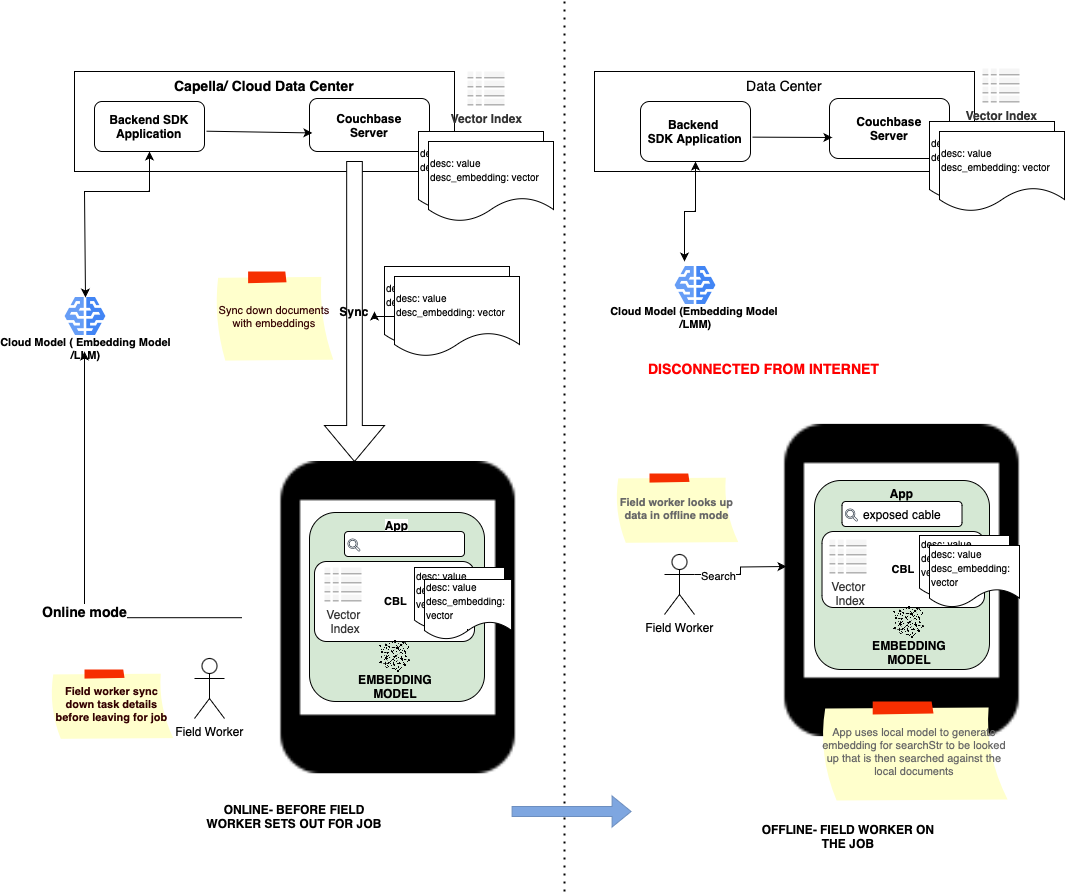
Aplicativos em que buscas simples baseadas em texto são insuficientes agora podem dar suporte a buscas semânticas em dados locais para recuperar dados contextualmente relevantes mesmo quando o dispositivo estiver no modo offline. Isso garante que os resultados da busca estejam sempre disponíveis.
Exemplo
Considere uma aplicação de campo clássica: trabalhadores de concessionárias em locais de reparo e áreas de desastre operam em áreas com conectividade à Internet ruim ou inexistente:
- As palavras, linha, cabo, fio são sinônimos para uma empresa de utilidade pública. Quando os trabalhadores de utilidade pública em campo pesquisam pela frase, linha, documentos com cabo, fio devem ser devolvidos também.
- Usando a busca de texto completo (FTS), a aplicação terá que manter uma lista de sinônimos que é difícil de criar, gerenciar e manter.
- A relevância também é importante. Portanto, uma consulta para: procedimentos de segurança para cabos de energia caídos deve focar em manuais relacionados a linhas de energia caídas, cabos elétricos, linhas de alta tensão, etc.
Aliviando as Preocupações com a Privacidade de Dados
Um dos principais casos de uso de um banco de dados de busca vetorial é a capacidade de recuperar dados contextualmente relevantes. Os resultados da busca são então incluídos como dados de contexto em consultas enviadas a um modelo de linguagem grande (LLM) para personalizar as respostas das consultas — esta é a base da Geração Aumentada por Recuperação (RAG)). Executar pesquisas em dados de natureza privada ou sensível pode levantar preocupações com a privacidade. Ao realizar pesquisas em um dispositivo local, podemos restringir as pesquisas apenas aos usuários que estão autenticados e autorizados a acessar os dados privados no dispositivo. Qualquer informação de identificação pessoal (PII) dos resultados da pesquisa vetorial pode ser redigida e, em seguida, aproveitada dentro da consulta RAG para um LLM.
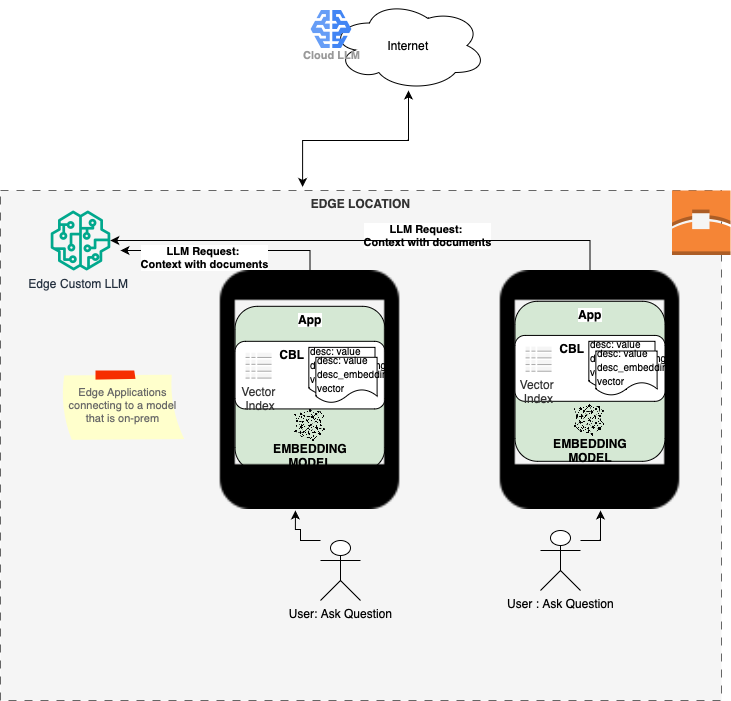
Além disso, se um LLM personalizado for implantado no local de borda, por exemplo, um hospital ou loja de varejo, quaisquer preocupações sobre o envio dos resultados de busca contextualmente relevantes pela Internet para um serviço de nuvem remoto são ainda mais mitigadas.
Exemplo
Considere o seguinte exemplo de um aplicativo de saúde:
- Um médico em um hospital está procurando opções de tratamento para um paciente se recuperando de uma cirurgia.
- Contexto relevante do paciente é recuperado do histórico médico e das preferências. O acesso a esses dados é autenticado e autorizado.
- O contexto do paciente é enviado junto com a consulta para um modelo de LLM de borda hospedado no hospital, que pode então gerar um plano de recuperação personalizado.
Custo por Consulta Reduzido
Quando você tem centenas de milhares de clientes conectados fazendo consultas a um LLM baseado em nuvem, a carga sobre o modelo em nuvem e os custos operacionais de execução do modelo baseado em nuvem podem ser consideravelmente altos. Ao executar consultas localmente no dispositivo, podemos economizar nos custos de transferência de dados e taxas de saída da nuvem, além de descentralizar os custos operacionais.
Exemplo
Considere o seguinte exemplo de um aplicativo assistente de atendimento ao cliente digital:
- Uma loja de varejo sincroniza um catálogo de produtos, preços específicos da loja e dados de promoções com os totens de autoatendimento (dispositivo de borda) na loja.
- Um usuário no totem busca um chapéu que combine com a jaqueta que está vestindo, capturada por uma câmera. Ele também se interessa por chapéus que estão em promoção.
- Em vez de os quiosques enviarem consultas de pesquisa para um servidor remoto, as pesquisas de similaridade são realizadas localmente, no próprio quiosque, no catálogo para encontrar itens semelhantes que estão em promoção.
- Como bônus, a imagem capturada pode ser descartada imediatamente do totem, aliviando preocupações com a privacidade.
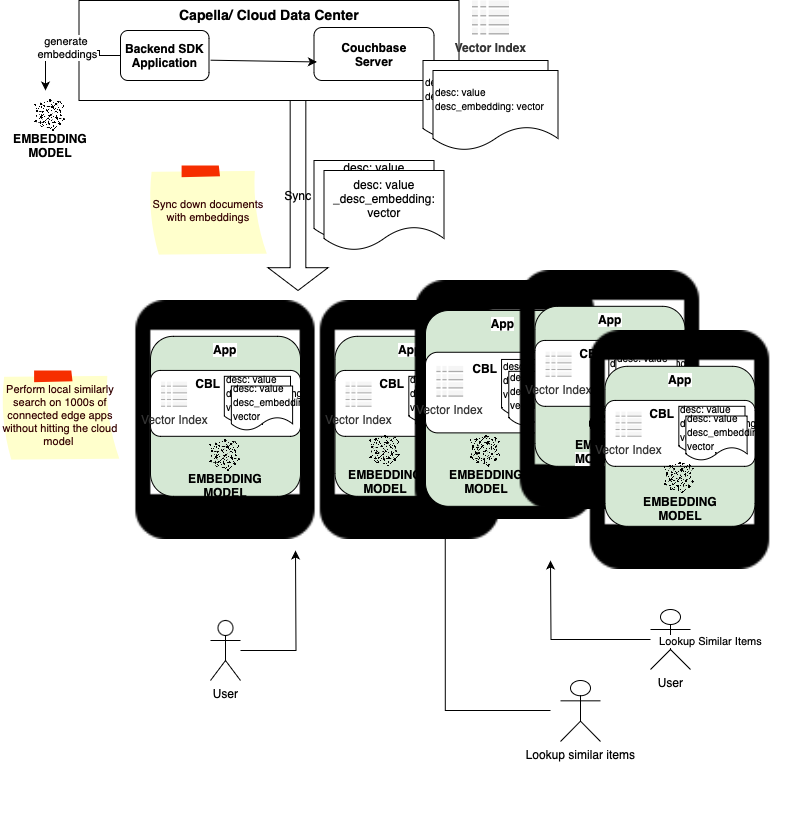
Buscas de Baixa Latência
Buscas executadas localmente em um conjunto de dados local usando um modelo embutido local eliminam a variabilidade da rede e serão consistentemente rápidas. Mesmo no caso em que o modelo não está embutido no dispositivo local, mas implantado em um local de borda (edge), o tempo de ida e volta (RTT) associado às consultas pode ser significativamente reduzido em comparação com buscas feitas pela Internet.
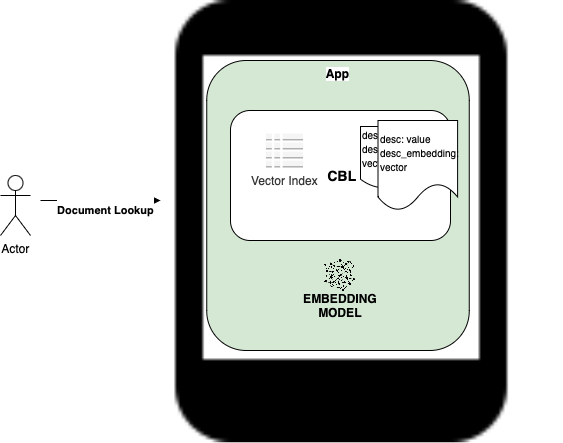
Exemplo
Revisando o aplicativo da loja de varejo:
- O catálogo de produtos, os documentos de preços específicos de lojas e de promoções que são sincronizados com os totens de atendimento ao cliente incluem embeddings vetoriais. Os embeddings vetoriais são gerados por modelos de embedding de LLM na nuvem.
- Os documentos sincronizados são então indexados localmente no quiosque.
- Um cliente no totem da loja procurando por um item específico faz uma busca comum por Tênis feminino Adidas tamanho 9 e também pode executar um encontrar itens relacionados função realizando uma busca semelhante entre o produto que foi recuperado usando uma busca regular e comparando-o com os documentos de produtos restantes. A busca é feita localmente e é rápida.
- Nesse caso, enquanto as incorporações vetoriais são geradas na nuvem, a busca por similaridade é feita localmente. De fato, nesta aplicação específica, não há necessidade nem mesmo de um modelo de incorporação no aplicativo do totem.
Suporte Unificado de Nuvem a Borda para Pesquisa de Similaridade de Vetores
Embora existam consultas mais adequadas para a nuvem, por motivos explicados anteriormente na postagem, há casos em que as consultas são mais adequadas para a borda. Ter a flexibilidade de executar consultas na nuvem, na borda ou em ambas permitirá que os desenvolvedores criem aplicativos que aproveitem o melhor dos dois mundos.
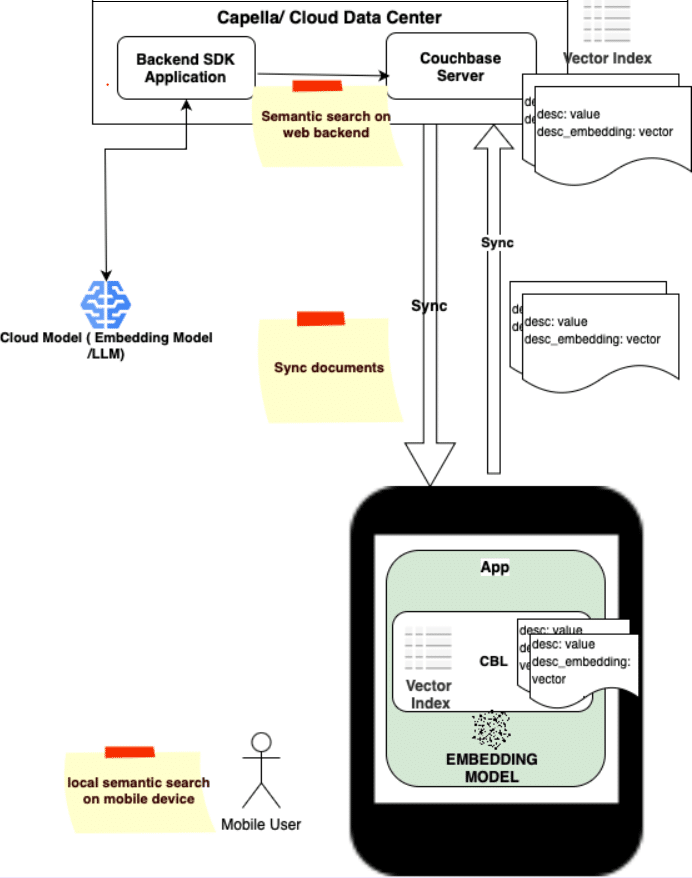
Exemplo
- Considere um aplicativo de mobile banking em que o histórico de transações específico do usuário dos últimos 6 meses é sincronizado e armazenado localmente no dispositivo
- Um usuário está procurando transações relacionadas a uma compra que ele fez há alguns meses. A busca é feita localmente, por isso é rápida e também está disponível offline.
- As transações relacionadas a todos os usuários são armazenadas nos servidores em nuvem, onde a busca semântica é utilizada por seu aplicativo de detecção de fraudes para detectar padrões de atividades fraudulentas.
Mostre-me o código!
Agora que você está entusiasmado com os benefícios da busca vetorial em sua aplicação de borda, vamos ver o que é necessário para implementá-la. É bastante simples e leva apenas algumas linhas de código para trazer o poder da busca semântica para a sua aplicação de borda. O exemplo abaixo está em Swift, mas confira a seção de recursos abaixo para trechos de código na linguagem de sua preferência.
Criando um Índice Vetorial
Neste exemplo, criamos um índice vetorial com os valores padrão. As aplicações têm a opção de personalizar ainda mais a configuração do índice vetorial com uma métrica de distância diferente, o tipo de codificação do índice e os parâmetros de treinamento do centróide:
|
1 2 3 4 5 6 |
// criar configuração de índice de vetor. No exemplo, a propriedade de documento “description” é indexada (pode ser qualquer expressão SQL++) variável configuração = Configuração do Índice de Vetores(expressão: “descrição”, dimensões: 158, centroides: 20) // criar índice vetorial com a configuração especificada tentar coleção.criarÍndice(comNome: “meuÍndice”, configuração: configuração) |
Realizando uma Busca por Similaridade
Neste exemplo, estou executando uma consulta SQL++ para recuperar os 10 principais documentos semelhantes com suas descrições correspondentes ao embedding de destino do termo de busca
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
// Recuperar o vetor de incorporação para searchPhrase do modelo de incorporação proteger deixar incorporação de busca = modelRef.obterIncorporação(para: termo de busca) senão { lança Erros.não encontrado } // Construir uma consulta SQL++ para retornar os 10 principais documentos do banco de dados com conteúdo semelhante à frase de pesquisa deixar SQL = “SELECT meta().id, description DE _ ORDER BY APPROX_VECTOR_DISTANCE(vector, $searchParam) LIMIT 10″ criar consulta deixar consulta = tentar db.createQuery(SQL) // define o vetor de incorporação associado ao parâmetro de busca deixar params = Parâmetros() params.definirValor(incorporação de busca, forName: “searchParam”) consulta.parâmetros = params // Executar consulta de busca vetorial tentar consulta.executar() |
Recursos
Aqui estão links diretos para alguns recursos úteis.
- Guias de instalação passo a passo
- Download do Couchbase Lite 3.2
- Downloads da Biblioteca de Extensões de Vetores do Couchbase Lite
- O suporte à pesquisa vetorial requer uma biblioteca de extensões separada, que precisa ser vinculada ao seu aplicativo, além do SDK principal do Couchbase Lite.
- Vídeo explicativo sobre a pesquisa vetorial do Couchbase Lite
- Aplicativo de exemplo para a busca vetorial do Couchbase Lite
Fique ligado para uma próxima postagem no blog sobre arquiteturas de referência para dar suporte à busca vetorial

Deixe um comentário
Você precisa fazer o login para publicar um comentário.