
Categoría: Mejores prácticas y tutoriales
-
What is Prompt Engineering? Techniques, Examples, and Tools
Prompt engineering is the practice of designing effective inputs to guide AI systems toward more accurate, useful, and context-aware outputs. It is increasingly applied in areas such as business automation, creative work, research, and…
-
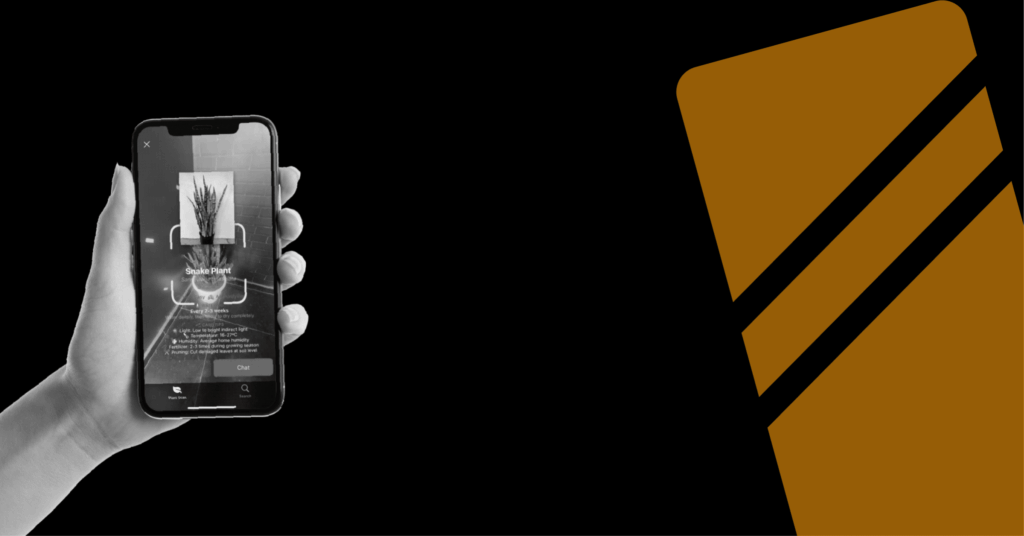
Cómo construí una aplicación RAG de plantas con búsqueda vectorial de Couchbase en iOS
¿Conoces esa sensación cuando ves una planta hermosa en la tienda pero no tienes idea de qué es o cómo cuidarla? Eso fue exactamente lo que me pasó la primavera pasada,…
-
Framework vs. Platform: Key Differences and When to Use Each
Frameworks offer a foundation for building software, helping developers implement custom logic while handling common tasks like routing and user interface (UI) design. They follow the inversion of control (IoC) principle, where the framework…
-
High Availability vs. Fault Tolerance: Key Differences
High availability and fault tolerance are both strategies for maintaining system operationality, but they differ in approach and complexity. High availability focuses on minimizing downtime through rapid recovery, while fault tolerance ensures uninterrupted operation…
-
Integración de Couchbase con Hyperledger Fabric: Un análisis técnico profundo
¿Qué es Couchbase? Couchbase es una base de datos de documentos NoSQL distribuida que ofrece una solución de gestión de datos flexible, de alto rendimiento y escalable. Combina las mejores características de las bases de datos de documentos con las de los almacenes de clave-valor, lo que la hace muy adecuada...
-
Vector Database vs. Graph Database: Differences & Similarities
What is a vector database? A vector database is a type of database designed to store, index, and search high-dimensional vector representations of data, typically generated by machine learning models. These vectors, also known…
-
¿Qué es el procesamiento de datos en tiempo real? Tipos, beneficios y limitaciones
¿Qué significan los datos en tiempo real? Los datos en tiempo real se refieren a información que se procesa y se pone a disposición con una latencia mínima, típicamente dentro de milisegundos o segundos de su creación. Permiten que los sistemas reaccionen a los eventos a medida que...
-
Optimización del TCO: Automatizar la hibernación de clústeres usando Terraform
La función de encendido y apagado de clústeres de Couchbase Capella permite a los usuarios pausar y reanudar sus clústeres sin problemas, sin eliminar permanentemente los datos, lo que ayuda a optimizar los gastos en la nube y a mejorar la eficiencia operativa. En este blog, exploraremos cómo esta...
-
Una guía completa sobre el aprendizaje federado
¿Qué es el aprendizaje federado? El aprendizaje federado es un enfoque de aprendizaje automático (ML) que permite que múltiples dispositivos o sistemas entrenen un modelo compartido de forma colaborativa sin intercambiar datos sin procesar. En lugar de enviar datos a un…
-
Similitud semántica con selectividad enfocada
¿Por qué la búsqueda semántica necesita selectividad? Hasta ahora, hemos visto una incrustación vectorial como una entidad completa e independiente, centrada enteramente en el significado que codifica. Si bien esto permite la búsqueda semántica, a menudo con...
-
Migrar del nivel gratuito de Capella a una cuenta de pago en 4 pasos
¿Qué es el nivel gratuito de Capella? Couchbase Capella ofrece un producto de nivel gratuito con un entorno perpetuo y sin costo para que los usuarios exploren y experimenten las capacidades de la plataforma de bases de datos NoSQL de Couchbase. Este nivel gratuito...
-
La importancia del preprocesamiento de datos en el aprendizaje automático (ML)
El preprocesamiento de datos es un paso vital en el aprendizaje automático que transforma datos crudos y desordenados en un formato limpio y estructurado para el entrenamiento de modelos. Implica limpiar, transformar, codificar y dividir los datos para mejorar el modelo...