
El procesamiento de datos es una etapa vital en el aprendizaje automático que transforma datos brutos y desorganizados en un formato limpio y estructurado para la formación del modelo. Involucra la limpieza, transformación, codificación y división de los datos con el fin de mejorar la precisión del modelo, prevenir la fuga de datos y garantizar la compatibilidad con los algoritmos. Aunque a menudo se confunde con la limpieza de datos, el procesamiento de datos abarca un conjunto más amplio de tareas fundamentales para los procesos de aprendizaje automático confiables. El uso de herramientas como Pandas, Scikit-learn y Apache Spark ayuda a agilizar este proceso, lo que lo hace escalable y eficaz a lo largo de diferentes tamaños y complejidades de proyectos.
¿Qué es la preprocesación de datos en el aprendizaje automático?
El procesamiento de datos en el aprendizaje automático se refiere a los pasos que se realizan para limpiar, organizar y transformar los datos en bruto en un formato que los algoritmos de aprendizaje automático puedan utilizar de forma efectiva. Los datos del mundo real suelen ser confusos debido a la presencia de valores faltantes, formatos inconsistentes, valores atípicos e características irrelevantes. Sin un adecuado procesamiento previo, incluso los modelos de aprendizaje automático más sofisticados pueden tener dificultades para encontrar patrones o pueden producir resultados engañosos.
Una preprocesamiento de datos eficaz no solo mejora la precisión y la eficiencia de los modelos ML, sino que también ayuda a descubrir insights más profundos ocultos en los datos. Establece la base de cualquier proyecto de ML exitoso al garantizar que los datos de entrada sean de alta calidad, consistentes y relevantes.
Preprocesamiento de datos vs. limpieza de datos
Si bien el procesamiento y la limpieza de datos se utilizan a menudo indistintamente, se refieren a etapas diferentes en el proceso de preparación de datos. La limpieza de datos es, de hecho, un subconjunto del proceso más amplio de procesamiento de datos. Entender las diferencias entre ambos es crucial para construir modelos de aprendizaje automático confiables, ya que cada uno desempeña una función única en la preparación de los datos. datos en bruto para análisis. La tabla siguiente explica sus objetivos específicos, funciones y importancia.
| Aspecto | Limpieza de datos | Preprocesamiento de datos |
| Alcance | Narrow – se enfoca en eliminar los problemas de datos | Amplio – incluye la limpieza, transformación y preparación de datos para el aprendizaje automático |
| Objetivo principal | Mejorar la calidad de los datos | Haga que los datos sean adecuados para la formación y evaluación de modelos |
| Tareas típicas | Eliminar duplicados y manejar valores faltantes | Limpieza, normalización, codificación, ingeniería de características y segmentación |
| ¿Involucra una transformación? | Raramente | Frecuentemente (por ejemplo, escalado, codificación, agregación) |
| Usado en | Tratamiento de datos y análisis inicial | Cargado completo de aprendizaje automático – desde los datos en bruto hasta un formato listo para el modelo |
| Herramientas utilizadas | Pandas, OpenRefine, Excel | Scikit-learn, Pandas, TensorFlow, NumPy |
| Ejemplo | Reemplazar los valores faltantes con el promedio | Reemplazar los valores faltantes y codificar de forma one-hot, junto con la normalización y el split entre el entrenamiento y la prueba |
¿Por qué la preprocesación de datos es importante en el aprendizaje automático?
La preprocesación eficaz de datos es un paso crucial en el proceso de aprendizaje automático. Garantiza que los datos introducidos en un modelo sean limpios, consistentes e informativos, lo que impacta directamente en su rendimiento y fiabilidad. A continuación se presentan algunas razones clave por las que la preprocesación de datos es importante en el aprendizaje automático:
- Mejora la precisión del modelo: Los datos limpios y bien estructurados permiten que los algoritmos aprendan patrones de forma más eficaz, lo que lleva a mejores predicciones y resultados.
- Reduce el ruido y las incoherencias: Eliminar datos irrelevantes o erróneos ayuda a evitar percepciones engañosas y confusión en el modelo.
- Manos que faltan o son incompletas: Las técnicas de preprocesamiento, como la imputación o la eliminación, garantizan que los desfasamientos en los datos no afecten al rendimiento del modelo.
- Asigura la compatibilidad de los datos: Muchos algoritmos de aprendizaje automático requieren datos en formatos específicos; pasos de preprocesamiento como Normalización o la codificación hace que los datos sean compatibles con estos requisitos.
- Previene la fuga de datos: La correcta división de los datos durante la preprocesación (en conjuntos de entrenamiento, validación y prueba) ayuda a evitar el sobreaprendizaje y garantiza una evaluación justa del modelo.
- Ahorra tiempo y recursos: Los datos limpios y organizados optimizan la formación de modelos, reducen los costos computacionales y acortan los ciclos de desarrollo.
Técnicas de preprocesamiento de datos
El procesamiento de datos implica diversas técnicas diseñadas para preparar los datos en bruto para su uso en modelos de aprendizaje automático. Cada técnica aborda desafíos específicos del conjunto de datos y contribuye a obtener entradas más limpias y confiables. A continuación se presentan algunas de las técnicas de procesamiento de datos más utilizadas:
- Limpieza de datos: Detecta y corrige los errores, elimina duplicados y gestiona los valores faltantes mediante estrategias como la imputación o la eliminación.
- Normalización y escalado: Ajusta los valores numéricos a una escala común sin distorsionar las diferencias en los rangos, lo que a menudo resulta esencial para algoritmos como el KNN o los modelos basados en el descenso gradiente.
- Codificación de variables categóricas: Converte los datos no numéricos (por ejemplo, etiquetas o categorías) a formatos numéricos mediante la codificación de un solo valor o la codificación de etiquetas.
- Detectación y eliminación de objetos anómalos: Identifica los puntos de datos que se desvían significativamente de los demás, lo que puede afectar negativamente el rendimiento del modelo si no se aborda.
- Reducción de la dimensionalidad: Reducen el número de características de entrada mientras preservan información importante, utilizando métodos como la análisis de componentes principales (PCA).
- División de datos: Divide el conjunto de datos en conjuntos de entrenamiento, validación y prueba para evaluar el modelo de forma efectiva y evitar el sobreaprendizaje.
Etapas de preprocesamiento de datos en el aprendizaje automático
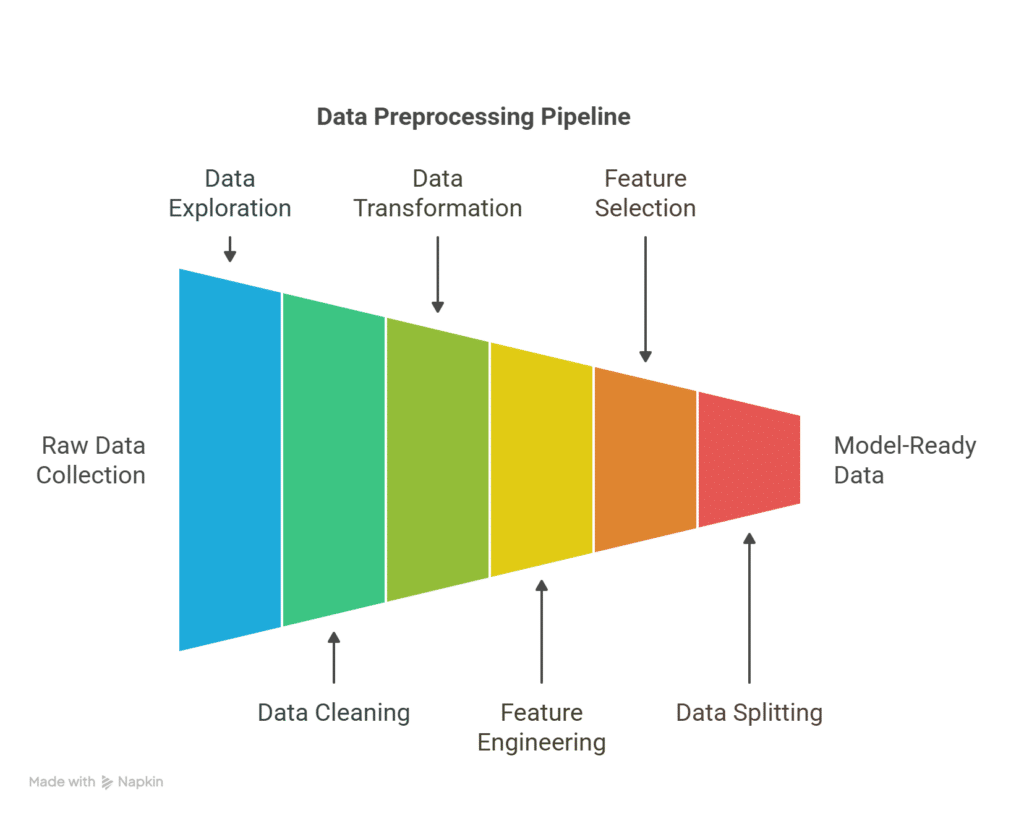
El procesamiento de datos es un proceso en múltiples etapas que prepara los datos en bruto para el aprendizaje automático. Cada paso contribuye a garantizar que el conjunto de datos sea preciso, consistente y optimizado para el rendimiento del modelo. A continuación se detalla paso a paso el proceso típico de procesamiento de datos:
Recopilación de datos
El proceso comienza con la recopilación de datos de fuentes relevantes, como bases de datos, API, Los sensores, los datos y los archivos recopilados influyen directamente en el éxito de las tareas posteriores.
Exploración de datos
Antes de realizar cambios, es esencial comprender el conjunto de datos mediante análisis exploratorio de datos (EDA). Este paso implica resumir las características de los datos, visualizar las distribuciones, detectar patrones e identificar anomalías o inconsistencias.
Limpieza de datos
Esta etapa aborda los valores faltantes, los registros duplicados, la formatación inconsistente y los valores atípicos. La limpieza garantiza que el conjunto de datos sea confiable y libre de ruido u errores que pudieran interferir con el entrenamiento del modelo.
Transformación de datos
En esta etapa, los datos se formatean para compatibilidad con el modelo. Este proceso incluye la normalización o el escalamiento de los valores numéricos, la codificación de variables categóricas y la transformación de distribuciones desparejas para mejorar el aprendizaje del modelo.
Ingeniería de características
Se crean nuevas características a partir de datos existentes para capturar mejor los patrones subyacentes. Este proceso puede incluir extraer variables basadas en el tiempo, combinar campos o aplicar conocimientos sobre el dominio para enriquecer el conjunto de datos.
Selección de características
No todas las características contribuyen de manera igual al rendimiento del modelo. Este paso implica seleccionar las variables más relevantes y eliminar las redundantes o irrelevantes, lo que ayuda a reducir el sobreaprofiliamiento y a mejorar la eficiencia.
División de datos
El conjunto de datos limpiado y diseñado se divide en conjuntos de entrenamiento, validación y prueba. De esta manera se garantiza que el modelo se evalúa con datos no vistos y se generaliza a escenarios del mundo real.
Revisión final
Antes de la modelación, una verificación final garantiza que todas las etapas de preprocesamiento se hayan aplicado correctamente. Esta etapa implica verificar las distribuciones, la calidad de las características y la división de los datos para evitar problemas como la fuga de datos o el desequilibrio.
Ejemplo de preprocesamiento de datos
Supongamos que está construyendo un modelo para predecir si un cliente abandonará un servicio de suscripción. Imaginemos que tiene un conjunto de datos de una compañía de telecomunicaciones con las siguientes columnas:
| ID del cliente | Edad | Género | Gastos mensuales | Tipo de contrato | Churn |
| 1 | 34 | Masculino | 70.5 | Mensual | Sí |
| 2 | NaN | Mujer | 85 | Un año | No |
| 3 | 45 | Mujer | NaN | Mensual | Sí |
| 4 | 29 | Masculino | 65.5 | Dos años | No |
Vamos a pasar por los pasos de preprocesamiento:
- Tratamiento de valores faltantes
- Complete la información faltante sobre la edad con la edad promedio (36).
- Complete los valores faltantes de los cargos mensuales con la media de la columna (73,5).
- Codificación de variables categóricas
- Género (Masculino/Femenino) y Tipo de contrato (Mensual, Anual, Bienal) son categóricos.
- Aplicar:
- Codificación de etiquetas para Género (Hombre = 0, Mujer = 1)
- Codificación de un solo bit Para el parámetro Contract_Type, se obtiene:
- Contrato_Mes_a_mes, Contrato_Un_año, Contrato_Dos_años
- Escalado de características
- Normalizar la edad y los cargos mensuales para que estén en la misma escala (esto es especialmente útil para modelos basados en distancias como el KNN).
- Codificación de destino
- Convertir Churn (sí/no) a binario:
- Sí = 1
- No = 0
- Conjunto de datos limpiado y preprocesado
| Edad | Género | Gastos mensuales | Mes del contrato | Contrato_Uno | Contrato_Dos | Churn |
| 34 | 0 | 70.5 | 1 | 0 | 0 | 1 |
| 36 | 1 | 85 | 0 | 1 | 0 | 0 |
| 45 | 1 | 73.5 | 1 | 0 | 0 | 1 |
| 29 | 0 | 65.5 | 0 | 0 | 1 | 0 |
Ahora el conjunto de datos es limpio, numérico y listo para la capacitación del modelo.
Herramientas de preprocesamiento de datos
La elección de las herramientas adecuadas para el procesamiento de datos puede influir en la eficacia del flujo de trabajo de aprendizaje automático. A continuación se presenta una lista de herramientas comunes, junto con sus fortalezas y limitaciones:
Pandas (Python)
Más indicado para:
- Gestión de datos estructurados (por ejemplo, CSV, Excel, tablas SQL)
- Limpieza, filtrado y transformación de datos
- Análisis exploratorio rápido de los datos
No es adecuado para:
- Processado distribuido a gran escala
- Flujos de trabajo ETL complejos o datos no estructurados (por ejemplo, imágenes, audio)
NumPy (Python)
Más indicado para:
- Operaciones numéricas y manipulación de matrices multidimensionales
- Calculos de matrices optimizados para rendimiento
No es adecuado para:
- Manipulación o limpieza de datos de alto nivel
- Trabajar directamente con conjuntos de datos etiquetados (Pandas es más adecuado)
Scikit-learn (Python)
Más indicado para:
- Escalado de características, codificación y selección
- División de datos (entrenamiento, prueba y validación)
- Integración con modelos y pipelines de ML
No es adecuado para:
- Tareas de aprendizaje profundo
- Manipulación de datos pesada (uso con Pandas)
OpenRefine
Más indicado para:
- Limpieza de datos desorganizados, no estructurados o inconsistentes
- Conciliar y transformar datos de diferentes fuentes
- Para personas que no son programadoras y necesitan una herramienta basada en la interfaz gráfica de usuario
No es adecuado para:
- Grandes conjuntos de datos
- Integración en flujos de trabajo automatizados de aprendizaje de máquinas
Apache Spark (con PySpark o Scala)
Más indicado para:
- Procesamiento de conjuntos de datos de gran tamaño en un entorno distribuido
- Preprocesamiento de datos en los pipelines de big data
- Integración con plataformas en la nube (AWS, Azure, GCP)
No es adecuado para:
- Conjuntos de datos pequeños a medianos (la inversión en recursos no puede justificarse).
- Manipulación de datos detallada e interactiva
Dataiku
Más indicado para:
- Flujos de trabajo de ML de principio a fin, que incluyen preprocesamiento, modelado y implementación
- Equipos con usuarios tanto técnicos como no técnicos
- Programación visual y automatización
No es adecuado para:
- Personalización profunda o control de datos de nivel bajo
- Proyectos personales ligeros o flujos de trabajo solo para el código
Validación de datos de TensorFlow (TFDV)
Más indicado para:
- Validación de los pipelines de datos en flujos de trabajo de ML en producción
- Detectar anomalías de esquema y desvíos de datos a escala
- Utilizar dentro del ecosistema TensorFlow Extended (TFX)
No es adecuado para:
- Limpieza de datos de uso general
- Utiliza fuera de los entornos TensorFlow o TFX
Las fortalezas y limitaciones de estas herramientas dependen en última instancia del tamaño de su proyecto, la complejidad y el entorno técnico. Combinar herramientas (por ejemplo, Pandas para la limpieza y Scikit-learn para el escalado de características) suele proporcionar los mejores resultados.
Puntos clave y recursos
La preprocesación de datos es crucial para el proceso de aprendizaje automático. Transforma datos brutos y desorganizados en un conjunto de datos estructurado y limpio, listo para la formación del modelo. Incluye tareas como el manejo de valores faltantes, la codificación de variables categóricas, el escalamiento de características y la creación de nuevas características, todas ellas contribuyen a mejorar la precisión y la fiabilidad del modelo. Saltar la preprocesación suele resultar en un rendimiento deficiente y resultados engañosos.
Herramientas como Pandas, Scikit-learn y TensorFlow simplifican el proceso, mientras que OpenRefine o Excel son útiles para tareas más ligeras o visuales.
Puede seguir aprendiendo sobre diferentes enfoques para preparar datos a través de los recursos que se indican a continuación:
- Una guía sobre la fragmentación de datos
- Preparación de conjuntos de datos para el ajuste fino de modelos de aprendizaje automático: una guía completa
- Una guía paso a paso para preparar los datos para la generación aumentada de recuperación (RAG)
- Procesamiento en serie – Conceptos
- ¿Qué es la Minería de Datos? Técnicas, herramientas y aplicaciones

Deja un comentario
Lo siento, debes estar conectado para publicar un comentario.