
O Serviço de Pesquisa de Texto Completo agora oferece melhor desempenho de busca e utilização de recursos em todo o seu cluster com a introdução de Escopos e Coleções no Couchbase 7.0.
Vamos dar um passo atrás: O Lançamento da versão 7.0 do Couchbase Server introduz o conceito de Escopos e Coleções que permitem criar namespaces para os dados dentro de um Couchbase Bucket. Em vez de todos JSON documentos precisando residir em um único namespace compartilhado, Escopos e Coleções fornecem a você uma capacidade integrada de agrupar documentos em vez de ter que adicionar atributos manuais como tipo a um documento.
Vamos explorar como você pode indexar e pesquisar os dados em seus Escopos e Coleções usando o Serviço de Pesquisa em Couchbase.
Como Indexar Dados para Busca em uma Única Coleção
A Serviço de Busca de Texto Completo (FTS) do Couchbase funciona exatamente da mesma forma que antes quando se trata de operar e definir novos índices em documentos residentes em um Bucket. Com Scopes e Collections, todos os documentos existentes (pré-7.0) em um Bucket são classificados no _default Escopo e _default Coleção. E os índices existentes continuam indexando novas mutações e todas as consultas funcionam normalmente.
Assim que a sua equipe adotar Escopos e Coleções, os usuários do banco de dados começarão a organizar documentos de multi-esquema em várias Coleções. É aqui que a Pesquisa de Texto Completo do Couchbase muda com a versão 7.0.
O Serviço de Pesquisa oferece suporte criações de índices em uma única Coleção de origem, bem como em várias Coleções de origem, desde que todas as Coleções pertençam a um solteiro Escopo.
Essencialmente, o índices de busca podem abranger várias Coleções, mas não vários Escopos.
Busca de Texto Completo com um CRM
Vamos nos aprofundar em mais detalhes com a ajuda de um exemplo.
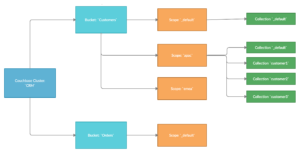
Considere um caso de uso de CRM em que os detalhes do seu cliente são capturados em um Clientes Carrinho e os detalhes do seu pedido em um Pedidos Balde.
Vamos supor que você tenha organizado vários clientes em diferentes Escopos com base nas regiões geográficas. Por exemplo, mapeando todos os clientes da região da Ásia-Pacífico para um Escopo específico chamado APAC e assim por diante.
O diagrama abaixo ilustra como você pode organizar seus Buckets, Scopes e Collections para o seu CRM.
Com Collections, a indexação e a busca de dados de uma única Collection de origem são o caso de uso mais comum e natural. Funciona de forma semelhante ao processo existente de criação de índices baseado em Bucket. A única diferença é que o usuário precisa especificar os detalhes do Scope e da Collection ao criar a definição do índice.
Se você estiver indexando o Scope e a Collection padrão dentro de um Bucket, então o etapas de criação de índice parecem exatamente iguais aos dias anteriores à Pré-Coleção.
Se você quiser indexar um Escopo e/ou Coleção(ões) não padrão, precisará marcar a caixa de seleção para “Use non-default Scope/Collection(s)” na interface web do Couchbase. Assim que concluir esta etapa, o processo de criação de índice solicitará que você insira os detalhes do Escopo e da Coleção de origem, conforme o diagrama abaixo.
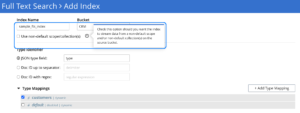
Assim que você marcar a caixa de seleção para habilitar Escopo/Coleção(ões) não padrão, você poderá escolher o Escopo de origem para os documentos (veja abaixo). Você pode notar que a lista suspensa de Escopos agora exibe todos os Escopos disponíveis dentro do seu Bucket escolhido (o CRM, em nosso exemplo).

Como mostrado na captura de tela acima, você pode selecionar o escopo ao qual a Coleção pertence na lista suspensa, conforme mostrado acima.
Especificando Mapeamentos de Tipos
Assim que você selecionar o Escopo, estará tudo pronto para especificar o tipo de documentos que deseja indexar.
A convenção é especificar o tipo de documentos sobre os mapeamentos de Tipo, e este mesmo padrão de definição de mapeamento de tipo continua aqui também. Ao adicionar um novo mapeamento de Tipo, o usuário recebe a opção de especificar a Coleção de origem, conforme mostrado abaixo.
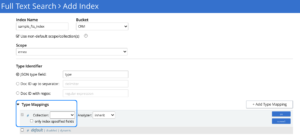
O usuário deve ser capaz de ver todas as Coleções disponíveis no Escopo mencionado (por exemplo, EMEA) como uma lista suspensa como a acima.
Indexando Todos os Tipos de Documentos em uma Determinada Coleção
Você pode indexar todos os tipo de documento em uma Coleção, selecionando o nome da Coleção na lista suspensa para o nome de mapeamento de tipo. Consulte a imagem abaixo para ver um exemplo.

Indexando Vários Tipos de Documentos em uma Coleção
Se a Coleção hospedar vários tipos de documentos, você poderá especificar qualquer quantidade de nomes de mapeamento do tipo de interesse seguidos pelo nome da Coleção, conforme mostrado abaixo.
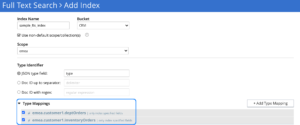
O exemplo acima indexaria tipos de documentos como pedidosDoDepto e pedidosDeEstoque da Coleção cliente1 sob o Escopo EMEA.
Notas de Escalabilidade
Como os dados do seu Bucket agora estão divididos em uma granularidade maior a partir de Escopos e Coleções, é mais provável que os documentos dentro de cada uma das suas Coleções tenham uma cardinalidade menor.
Dependendo das especificidades de suas Coleções, você pode não precisa usar as configurações de partição padrão de 6 por índice para alimentar um conjunto de dados menor.
O uso da contagem de partições adequada para uma determinada quantidade de dados ajuda a suportar:
- Melhor utilização de recursos em um nó
- Um número maior de índices em qualquer nó dado
- Melhor desempenho de busca
Como resultado, recomendamos que você explore a substituição da contagem de partições padrão para um inferior valor durante o dimensionamento do cluster.
Notas de RBAC
Agora você pode administrar controle de acesso baseado em função (RBAC) para índices de busca de texto completo no nível de Bucket, Scope (Escopo) ou Collection(s) (Coleção/Coleções).
Um usuário com pelo menos leitor de pesquisa as permissões no nível da Coleção de origem poderão acessar o índice de pesquisa de texto completo.
Como Indexar Dados para Busca em Múltiplas Coleções
Os índices de múltiplas coleções ajudam seus usuários a indexar e pesquisar em várias coleções dentro de um único escopo — tudo a partir de um único índice. Alguns casos de uso favoráveis a múltiplas coleções incluem:
- Os usuários dividiram os dados em várias Coleções, onde cada Coleção ou namespace pode ser uma conta de cliente, a marca de um produto, etc. (ou seja, dados homogêneos entre as Coleções).
- Os usuários têm muitas Collections relativamente pequenas em seu conjunto de dados devido ao particionamento lógico dos dados (ou seja, dados heterogêneos entre as Collections).
Em todos esses casos, talvez você precise criar inúmeros índices para habilitar a busca de texto completo em dados de várias Coleções. No entanto, é uma exigência trabalhosa ter que criar – e manter – um número tão grande de índices.
É aí que entram os índices de várias coleções.
Os índices de múltiplas coleções reduzem a sobrecarga ao simplesmente permitir que você crie um índice guarda-chuva que cobre muitas coleções. Essas coleções podem conter dados homogêneos ou dados heterogêneos.
Especificando Mapeamentos de Tipos
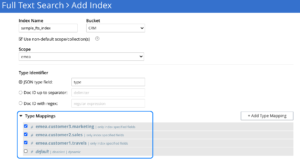
Na captura de tela abaixo, você pode ver a definição de mapeamentos de tipos para indexação de tipos de dados heterogêneos de diferentes coleções, como cliente1, cliente2 e cliente3. Você também pode usar tipos de dados semelhantes de várias Coleções, como customer1.travels e customer3.travels e afins.
Notas do Ciclo de Vida
Se alguma das Coleções de origem for excluída em um índice de Coleções múltiplas, o índice também será excluído(!).
Portanto, os índices multi-Collection são mais adequados para Collections com tempos de vida semelhantes.
Notas de RBAC
Sob a segurança RBAC do Couchbase, você deve ter leitor de pesquisa permissões para todas as Coleções de origem para acessar um índice de várias Coleções.
Como Pesquisar os Dados em uma Coleção Usando Pesquisa de Texto Completo
Índice de Coleção Única: Você pode pesquisar e recuperar dados de um índice de Coleção única da mesma forma que fazia antes com um índice baseado em Bucket.
Índice de Múltiplas Coleções: Você pode pesquisar em índices de várias Coleções usando as mesmas solicitações de pesquisa antigas. Como um índice de várias Coleções contém dados de várias Coleções de origem, é útil saber a Coleção de origem de seus resultados relevantes.
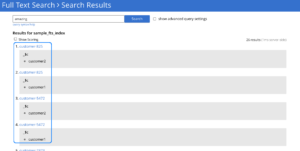
Com índices de múltiplas Coleções, cada resultado nos resultados de pesquisa contém informações sobre a Coleção à qual pertence. Este detalhe da Coleção de origem está disponível no Campos seção de cada resultado sob a chave _$c. Consulte a imagem abaixo para ver um exemplo.
Você também pode limitar suas solicitações de busca de texto completo apenas a Coleções específicas dentro do índice de várias Coleções. Esse foco acelera suas buscas em um índice grande.
Abaixo está um exemplo de solicitação de pesquisa de Coleção para Coleções cliente1 e cliente3.
|
1 2 3 4 5 6 7 8 9 |
{ “consulta”: { “match_phrase”: “ultrapassando o orçamento” }, “coleções”: [ “cliente1”, “cliente3” ] } |
Notas de Atualização
Você só pode aproveitar o suporte a Coleções para o Serviço de Pesquisa de Texto Completo (Full-Text Search) em um cluster do Couchbase 7.0 totalmente atualizado.
Você não pode ativar o suporte a Coleções para FTS em um cluster de versão mista.
Conclusão
Espero que você goste de usar o serviço de busca de texto completo do Couchbase com os novos recursos de Scopes e Collections introduzidos na versão 7.0.
Se você quiser saber mais sobre o Couchbase Server 7, confira as Novidades e/ou as notas de lançamento da versão 7.0.
Experimente a pesquisa de texto completo:
Experimente o Couchbase 7

Deixe um comentário
Você precisa fazer o login para publicar um comentário.