
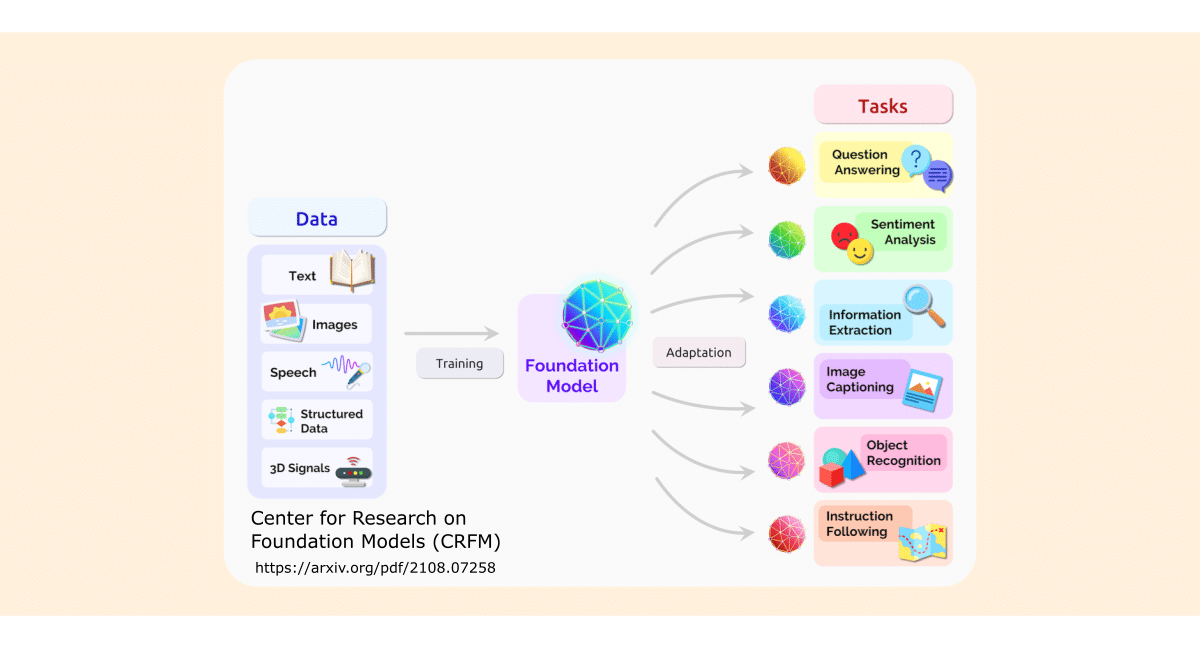
기초 모델이란 무엇인가요?
기초 모델은 방대한 양의 일반 데이터로 학습되어 광범위한 작업을 처리할 수 있는 강력한 인공지능(AI) 유형입니다. 다음과 같은 기초 모델들은 OpenAI의 GPT(생성형 사전 훈련된 트랜스포머) 시리즈 또는 구글의 BERT (Bidirectional Encoder Representations from Transformers)은 인터넷상의 다양한 소스에서 일반적인 언어 패턴과 지식을 포착하도록 설계되었습니다. 그런 다음 이러한 모델은 텍스트 분류, 요약, 번역, 질의응답 등의 작업을 수행하기 위해 더 작고 작업에 특화된 데이터셋으로 미세 조정될 수 있습니다. 이러한 미세 조정을 통해 새로운 AI 애플리케이션 개발이 더 빠르고 저렴해집니다.
파운데이션 모델, 그 내부 작동 방식, 학습 방법론, 그리고 실제 활용 사례에 대해 자세히 알아보려면 계속 읽어보세요.
파운데이션 모델은 어떻게 작동하나요?
GPT이나 BERT와 같은 트랜스포머 아키텍처 기반의 파운데이션 모델은 다양한 데이터셋에 대한 광범위한 사전 학습과 특정 태스크를 위한 미세 조정 과정을 거쳐 작동합니다. 이 모델들이 작동하는 방식은 다음과 같습니다.
사전 훈련
- 데이터 수집기반 모델은 책, 웹사이트, 기사 및 기타 텍스트 출처의 방대하고 다양한 데이터셋으로 학습됩니다. 이는 모델이 다양한 언어 패턴, 스타일, 정보를 학습하는 데 도움을 줍니다.
- 학습 목표사전 훈련 동안 모델은 일반적으로 텍스트의 다른 부분을 바탕으로 텍스트의 일부를 예측하도록 훈련됩니다. 예를 들어, GPT의 경우, 모델은 다음 단어를 예측합니다. 이전 단어들을 바탕으로 문장 안에서 예측하는 방식(자기회귀 학습으로 알려진 과정)입니다. 반면 BERT는 입력된 단어 중 일부가 무작위로 마스킹되는 마스크드 언어 모델 방식을 사용하며, 모델은 다른 마스킹되지 않은 단어들이 제공하는 문맥을 바탕으로 이 마스킹된 단어들을 예측하는 법을 학습합니다.
- 모델 아키텍처이 모델들에 사용된 트랜스포머 아키텍처는 자기 주의(셀프 어텐션) 메커니즘에 크게 의존합니다. 이를 통해 모델은 문장이나 문서 내의 다양한 단어들의 위치에 상관없이 그 중요성을 비교 형량할 수 있으며, 단어 간의 문맥과 관계를 효과적으로 이해할 수 있게 됩니다.
미세조정
- 작업별 데이터사전 학습 후, 모델은 더 작고 작업에 특화된 데이터셋으로 미세 조정될 수 있습니다. 예를 들어, 감성 분석 작업의 경우, 모델은 감성이 레이블된 텍스트 샘플 데이터셋으로 미세 조정됩니다.
- 모델 조정: 파인튜닝(미세조정) 과정에서는 특정 작업에서 더 나은 성능을 발휘하도록 전체 모델 또는 일부를 미세하게 조정합니다. 이 과정은 모델을 추가로 학습시키는 것을 포함하며, 이제는 감성 분류나 질문 답변과 같은 작업에 특화된 목적을 염두에 두고 진행됩니다.
- 전전문화이 단계는 사전 학습 과정에서 획득한 일반적인 능력을 특정 태스크나 도메인의 요구 사항과 미세한 특성에 맞게 조정하여, 동일한 태스크에 대해 모델을 처음부터 학습시키는 것에 비해 성능을 크게 향상시킵니다.
배포
- 사용을 위한 배포일단 미세조정되면, 파운데이션 모델은 가상 어시스턴트와 챗봇부터 자동 번역, 콘텐츠 생성 등을 위한 도구에 이르기까지 다양한 애플리케이션에 배포될 수 있습니다.
기초 모델(foundation model)을 마스터 셰프에 비유해 볼 수 있습니다. 이 모델은 어마어마한 양의 재료(데이터)를 집어삼키고 그것들이 어떻게 상호작용하는지(관계)를 학습합니다. 그런 다음, 이 지식을 바탕으로 맛있는 수프를 끓이는 것(텍스트 작성)부터 아름다운 케이크를 만드는 것(이미지 생성)에 이르기까지 다양한 요리(작업 수행)를 뚝딱 만들어낼 수 있습니다.
기초 모델의 유형과 예시
기초 모델은 아키텍처, 학습 목적, 응용 분야에서 매우 다양하며, 각각은 학습의 다양한 측면과 데이터와의 상호작용을 활용하도록 조정되어 있습니다. 아래는 다양한 유형의 기초 모델에 대한 상세한 탐색입니다.
자기회귀 모델
자기회귀 모델 GPT 시리즈(GPT-2, GPT-3, GPT-4)와 같은 엑스엘넷 모델이 이전의 모든 단어가 주어졌을 때 시퀀스의 다음 단어를 예측하는 학습 방식을 사용합니다. 이 학습 방법은 모델이 일관성 있고 문맥에 맞는 텍스트를 생성할 수 있게 해주며, 이는 창작 글쓰기, 챗봇, 개인화된 고객 서비스 상호작용에 특히 유용합니다.
오토인코딩 모델
오토인코딩 모델, BERT를 포함하여 로버타, 마스킹된 언어 모델링으로 알려진 기법을 사용하여 입력을 의도적으로 훼손함으로써 입력을 이해하고 재구성하도록 훈련되며, 이 기법에서는 훈련 중에 무작위 토큰이 모델로부터 숨겨집니다. 그런 다음 모델은 문맥만을 바탕으로 누락된 단어를 예측하는 법을 학습합니다. 이러한 능력 덕분에 모델은 언어 구조를 이해하는 데 매우 효과적이며, 텍스트 분류, 개체명 인식, 질의 응답과 같은 응용 분야에 매우 유용합니다.
인코더-디코더 모델
인코더-디코더 모델 ~와 같은 T5 (Text-to-Text Transfer Transformer)와 BART는 입력 텍스트를 출력 텍스트로 변환할 수 있는 다기능 도구입니다. 이 모델들은 입력 시퀀스를 잠재 공간으로 인코딩한 후 이를 출력 시퀀스로 디코딩하는 방식을 학습함으로써 요약, 번역, 텍스트 수정과 같은 복잡한 작업을 처리하는 데 특히 능숙합니다. 이들의 훈련에는 종종 다양한 텍스트 간 변환 작업이 포함되어 여러 도메인에 걸쳐 광범위한 적용 가능성을 제공합니다.
멀티모달 모델
멀티모달 모델 OpenAI의 CLIP이나 DALL-E처럼 텍스트와 이미지 등 서로 다른 데이터 유형에 걸쳐 있는 콘텐츠를 처리하고 생성하도록 설계되었습니다. 멀티모달 콘텐츠를 이해하고 생성함으로써, 이 모델들은 이미지 캡셔닝, 텍스트 기반 이미지 검색, 설명으로부터 이미지 생성 등 이미지와 텍스트 설명 간의 관계를 해석하는 작업에 매우 중요해집니다.
검색증강 모델
검색증강 모델, 와(과) 같은 레트로 (Retrieval-Enhanced Transformer)은 외부 지식 검색 프로세스를 통합하여 전통적인 언어 모델의 기능을 향상시킵니다. 이 접근 방식은 모델이 예측 단계에서 대규모 데이터베이스나 코퍼스에서 관련 정보를 가져올 수 있도록 하여, 더 유익하고 정확한 출력을 도출합니다. 이는 질문 답변 및 콘텐츠 검증과 같이 상세한 사실적 정확성과 깊이가 요구되는 응용 분야에서 특히 유익합니다.
시퀀스 투 시퀀스 모델
시퀀스 투 시퀀스(seq2seq) 모델 구글의 트랜스포머와 페이스북의 BART 같은 모델들은 입력 시퀀스를 긴밀하게 관련된 출력 시퀀스로 변환해야 하는 작업을 처리합니다. 이러한 모델들은 기계 번역과 문서 요약의 핵심으로, 전체 콘텐츠나 그 의미가 정확하게 포착되어 다른 형태로 전달되어야 합니다.
각 유형의 파운데이션 모델은 고유한 훈련 및 운영 설계 덕분에 특정 작업에 고유하게 적합합니다. 다음 섹션에서는 파운데이션 모델의 기능을 자세히 설명하기 위해 몇 가지 사용 사례를 살펴보겠습니다.
기반 모델의 사용 사례
기반 모델들은 적응성과 대규모 데이터셋으로부터 학습하는 능력을 통해 다양한 산업을 변화시키고 있습니다. 다음은 몇 가지 흥미로운 예시입니다:
- 자연어 처리파운데이션 모델은 많은 자연어 처리(NLP) 애플리케이션의 핵심 기반입니다. 이들은 기계 번역을 구동하여 언어 간 원활한 소통을 가능하게 합니다. 또한 텍스트의 감정적 어조를 파악하는 감성 분석이나, 더 자연스러운 인간과 컴퓨터 간 상호작용을 위한 챗봇 개발과 같은 작업에도 사용될 수 있습니다.
- 콘텐츠 제작기초 모델은 시와 대본부터 마케팅 문구에 이르기까지 다양한 창의적인 텍스트 형식을 생성할 수 있어 콘텐츠 제작자와 마케터에게 도움을 줍니다.
- 이미지 및 비디오 분석시각 분야에서 파운데이션 모델은 이미지 및 비디오 분석에 탁월합니다. 보안 카메라의 객체 감지, 의사를 돕는 의료 영상 분석, 영화 속 사실적인 특수 효과 생성 같은 작업에 사용될 수 있습니다.
- 과학적 발견: 이러한 모델들은 전통적인 방법으로는 놓칠 수 있는 패턴과 관계를 파악하기 위해 방대한 데이터셋을 분석함으로써 과학 Research를 가속화할 수 있습니다. 이러한 능력은 신약 개발, 재료과학, 또는 기후 변화 연구에 도움이 될 수 있습니다.
- 자동화 기초 모델은 문서 요약이나 데이터 입력과 같은 반복적인 작업을 자동화하여, 더 복잡한 작업을 위한 시간을 확보해 줄 수 있습니다.
이는 기초 모델의 사용 사례 중 몇 가지 예에 불과하며, 연구자들이 새로운 가능성을 탐구함에 따라 잠재적 응용 분야는 지속적으로 확장되고 있습니다. 이 모델들은 다양한 산업과 우리의 일상을 변화시킬 엄청난 잠재력을 가지고 있습니다.
파운데이션 모델을 훈련하는 방법
기반 모델을 훈련하는 것은 상당한 컴퓨팅 자원과 전문성이 필요한 복잡한 작업입니다. 주요 단계에 대한 간소화된 분석은 다음과 같습니다:
- 데이터 수집 및 준비기초는 데이터를 바탕으로 구축됩니다. 원하는 작업과 관련된 엄청난 양의 레이블이 없는 데이터가 수집됩니다. 이 데이터는 다음과 같은 텍스트일 수 있습니다. 대형 언어 모델 (LLM), 컴퓨터 비전 모델용 이미지, 또는 멀티모달 모델용 조합을 말합니다. 데이터의 품질과 일관성을 보장하기 위해 데이터를 정제하고 전처리하는 것이 매우 중요합니다.
- 모델 아키텍처 및 선택선택하는 파운데이션 모델의 유형은 데이터와 작업에 따라 다릅니다. 일단 선택되면, 대규모 데이터셋을 효과적으로 처리하기 위해 모델 아키텍처가 미세 조정됩니다.
- 자기지도 학습바로 여기가 마법이 일어나는 곳입니다. 레이블이 지정된 데이터를 사용하는 지도 학습과 달리, 파운데이션 모델은 자기 지도 학습 기법을 활용합니다. 모델 스스로 레이블이 없는 데이터로부터 태스크와 레이블을 생성합니다. 이는 텍스트 데이터의 시퀀스에서 다음 단어를 예측하거나 이미지의 누락된 부분을 식별하는 것과 같은 작업을 포함합니다.
- 훈련 및 최적화: 모델은 GPU나 TPU와 같은 강력한 컴퓨팅 자원을 사용하여 준비된 데이터로 학습됩니다. 모델 크기와 데이터셋의 복잡성에 따라 이 학습 과정은 며칠 또는 몇 주가 걸릴 수 있습니다. 다음과 같은 기술들은 경사 하강법 모델의 성능을 최적화하는 데 사용됩니다.
- 평가 및 개선훈련 후, 모델의 성능은 벤치마크 데이터셋이나 특정 태스크에서 평가됩니다. 결과가 이상적이지 않은 경우, 모델은 조정됨으로써 추가로 개선될 수 있습니다. 하이퍼파라미터 품질 향상을 위해 데이터 준비 단계로 다시 돌아가는 것조차 말합니다.
기초 모델의 훈련은 진행 중인 과정이라는 점에 주목하는 것이 중요합니다. 연구원들은 모델의 성능과 성숙도를 향상시키기 위해 데이터 처리, 모델 아키텍처, 그리고 자기 지도 학습 태스크를 위한 새로운 기법을 끊임없이 탐구하고 있습니다.
파운데이션 모델의 이점
파운데이션 모델은 상당한 이점을 제공하여 다양한 분야에서 널리 채택되고 사용되는 데 기여하고 있습니다. 주요 장점을 더 자세히 살펴보면 다음과 같습니다:
- 다재다능함과 적응력전통적이고 협소하게 초점 맞춰진 AI 모델과 달리, 파운데이션 모델은 다목적성을 지니고 있습니다. 이들은 도메인 내(텍스트, 이미지 등)의 광범위한 작업에 맞춰 미세 조정될 수 있으며, 멀티모달 모델의 경우 도메인을 넘나들며 조정될 수도 있습니다. 이러한 유연성은 특정 작업마다 처음부터 새로운 모델을 구축하는 것에 비해 시간과 자원을 절약해 줍니다.
- 효율성과 비용 효과성사전 훈련된 파운데이션 모델은 개발자에게 탄탄한 시작점을 제공합니다. 특정 작업에 맞게 이를 미세 조정하는 것은 처음부터 완전히 새로운 모델을 학습시키는 것보다 대개 더 빠르고 컴퓨팅 비용이 적게 듭니다. 이러한 효율성은 비용 절감과 더 빠른 개발 주기로 이어집니다.
- 성능 향상기반 모델은 대규모 데이터셋에 대한 방대한 학습 덕분에 다양한 작업에서 기존 모델을 능가하는 경우가 많습니다. 기계 번역, 이미지 인식, 텍스트 요약 작업에서 더 높은 정확도를 달성할 수 있습니다.
- AI의 민주화사전 훈련된 파운데이션 모델의 가용성은 AI 개발의 진입 장벽을 낮춰줍니다. 대규모 컴퓨팅 자원에 접근할 수 없는 소규모 기업이나 연구자들도 이러한 모델을 활용하여 혁신적인 AI 애플리케이션을 만들 수 있습니다.
- 과학적 발견의 가속화기반 모델은 방대한 과학 데이터를 분석하여 전통적인 방법으로는 놓칠 수 있는 숨겨진 패턴과 관계를 찾아낼 수 있습니다. 이러한 능력은 신약 개발, 재료 과학, 기후 변화 연구와 같은 분야에서 과학적 진보를 크게 가속화할 수 있습니다.
Foundation Model Challenges
Foundation models, despite their remarkable capabilities, come with their own set of challenges that researchers are actively working to address. Here are some key areas of concern:
- Data Bias and Fairness: Foundation models inherit biases present in the data they’re trained on. This can lead to discriminatory or unfair outputs. Mitigating bias requires careful data selection, curation, and development of fairer training algorithms.
- Explainability and Interpretability: Understanding how foundation models arrive at their outputs can be difficult. This lack of transparency makes identifying and addressing potential errors or biases challenging. Research is ongoing to develop methods for making these models more interpretable.
- Computational Resources: Training and running foundation models requires significant computational power and resources like GPUs or TPUs. This can limit accessibility for smaller companies or researchers without access to such infrastructure.
- Security and Privacy Concerns: The vast amount of data used to train foundation models raises security and privacy concerns. Malicious actors could exploit vulnerabilities in the training data or the models themselves. Ensuring robust security measures and responsible data handling practices are crucial.
- Environmental Impact: Training these models can consume a significant amount of energy. Developing more energy-efficient training methods and using renewable energy sources are important considerations for the sustainable deployment of foundation models.
주요 내용
Foundation models represent a significant leap forward in AI capabilities. Their versatility, efficiency, and ability to learn from huge amounts of data are paving the way for a new generation of intelligent applications that will transform various industries and our daily lives.
To keep learning more about topics related to artificial intelligence (AI), explore the resources below:

댓글 남기기
댓글을 달기 위해서는 로그인해야합니다.