As aplicações modernas são implementadas como um conjunto de um grande número de microserviços. Cada um desses microserviços pode funcionar independentemente de muitos outros microserviços. Essas aplicações esperam que os bancos de dados subjacentes suportem multitenancy. O Couchbase Server 7.0 introduziu Escopos e Coleções para suportar a multitenência e facilitar a modelagem de dados para aplicações contemporâneas. Os scopes e as collections proporcionam aos usuários uma separação lógica dos dados dentro de um bucket.
Cada microserviço de uma aplicação agora pode criar independentemente os Índices Globais Secundários necessários para esse microserviço. Nas versões anteriores do Couchbase Server, apenas um pedido de criação de índice era permitido no cluster. Para fortalecer o suporte à multitenancy, no Couchbase Server 7.0, o fluxo de trabalho de criação de índice foi melhorado para permitir várias solicitações simultâneas de criação de índice. Neste blog, vamos discutir: como a experiência de usuário ao criar vários índices simultaneamente foi aprimorada.
Fluxo de trabalho melhorado para criação de índices
Vamos primeiro entender o fluxo de trabalho de criação de índices em um cluster do Couchbase. Criando índices isso ocorre em duas fases (1) criação do índice de metadados e (2) construção do índice. Na primeira fase, o serviço de índice do Couchbase determina a melhor localização possível para o novo índice, com a ajuda do planeador de índice, e os metadados do índice são mantidos. Na segunda fase, os nós-host identificados na primeira fase iniciarão um fluxo com o serviço de dados para a “construção do índice”. Os usuários podem especificar o defer_build flag durante a criação do índice para executar apenas a primeira fase e a segunda fase pode ser ativada posteriormente usando o construir índice comando.
Nas seções seguintes, o significado de criação de índice é limitado apenas à primeira fase.
Para alcançar a melhor colocação possível no índice, apenas uma instância do planejador de índice deve ser executada ao mesmo tempo. Portanto, o serviço de indexação – que executa versões mais antigas do servidor Couchbase – rejeita todas as novas solicitações de criação de índice recebidas se houver uma solicitação em andamento de criação de índice. 
Este comportamento foi melhorado no Couchbase Server 7.0, onde o serviço de indexação aceita todas as solicitações de criação de index, mesmo que a criação de index já esteja em curso. O serviço de indexação aguarda a solicitação de criação do índice, processa as solicitações aguardadas em segundo plano e somente após a criação do índice é que a resposta é retornada ao autor da solicitação.

Por favor, note que a criação do índice era um pedido de bloqueio antes do Couchbase Server 7.0 e continua sendo bloqueado nas novas versões também.
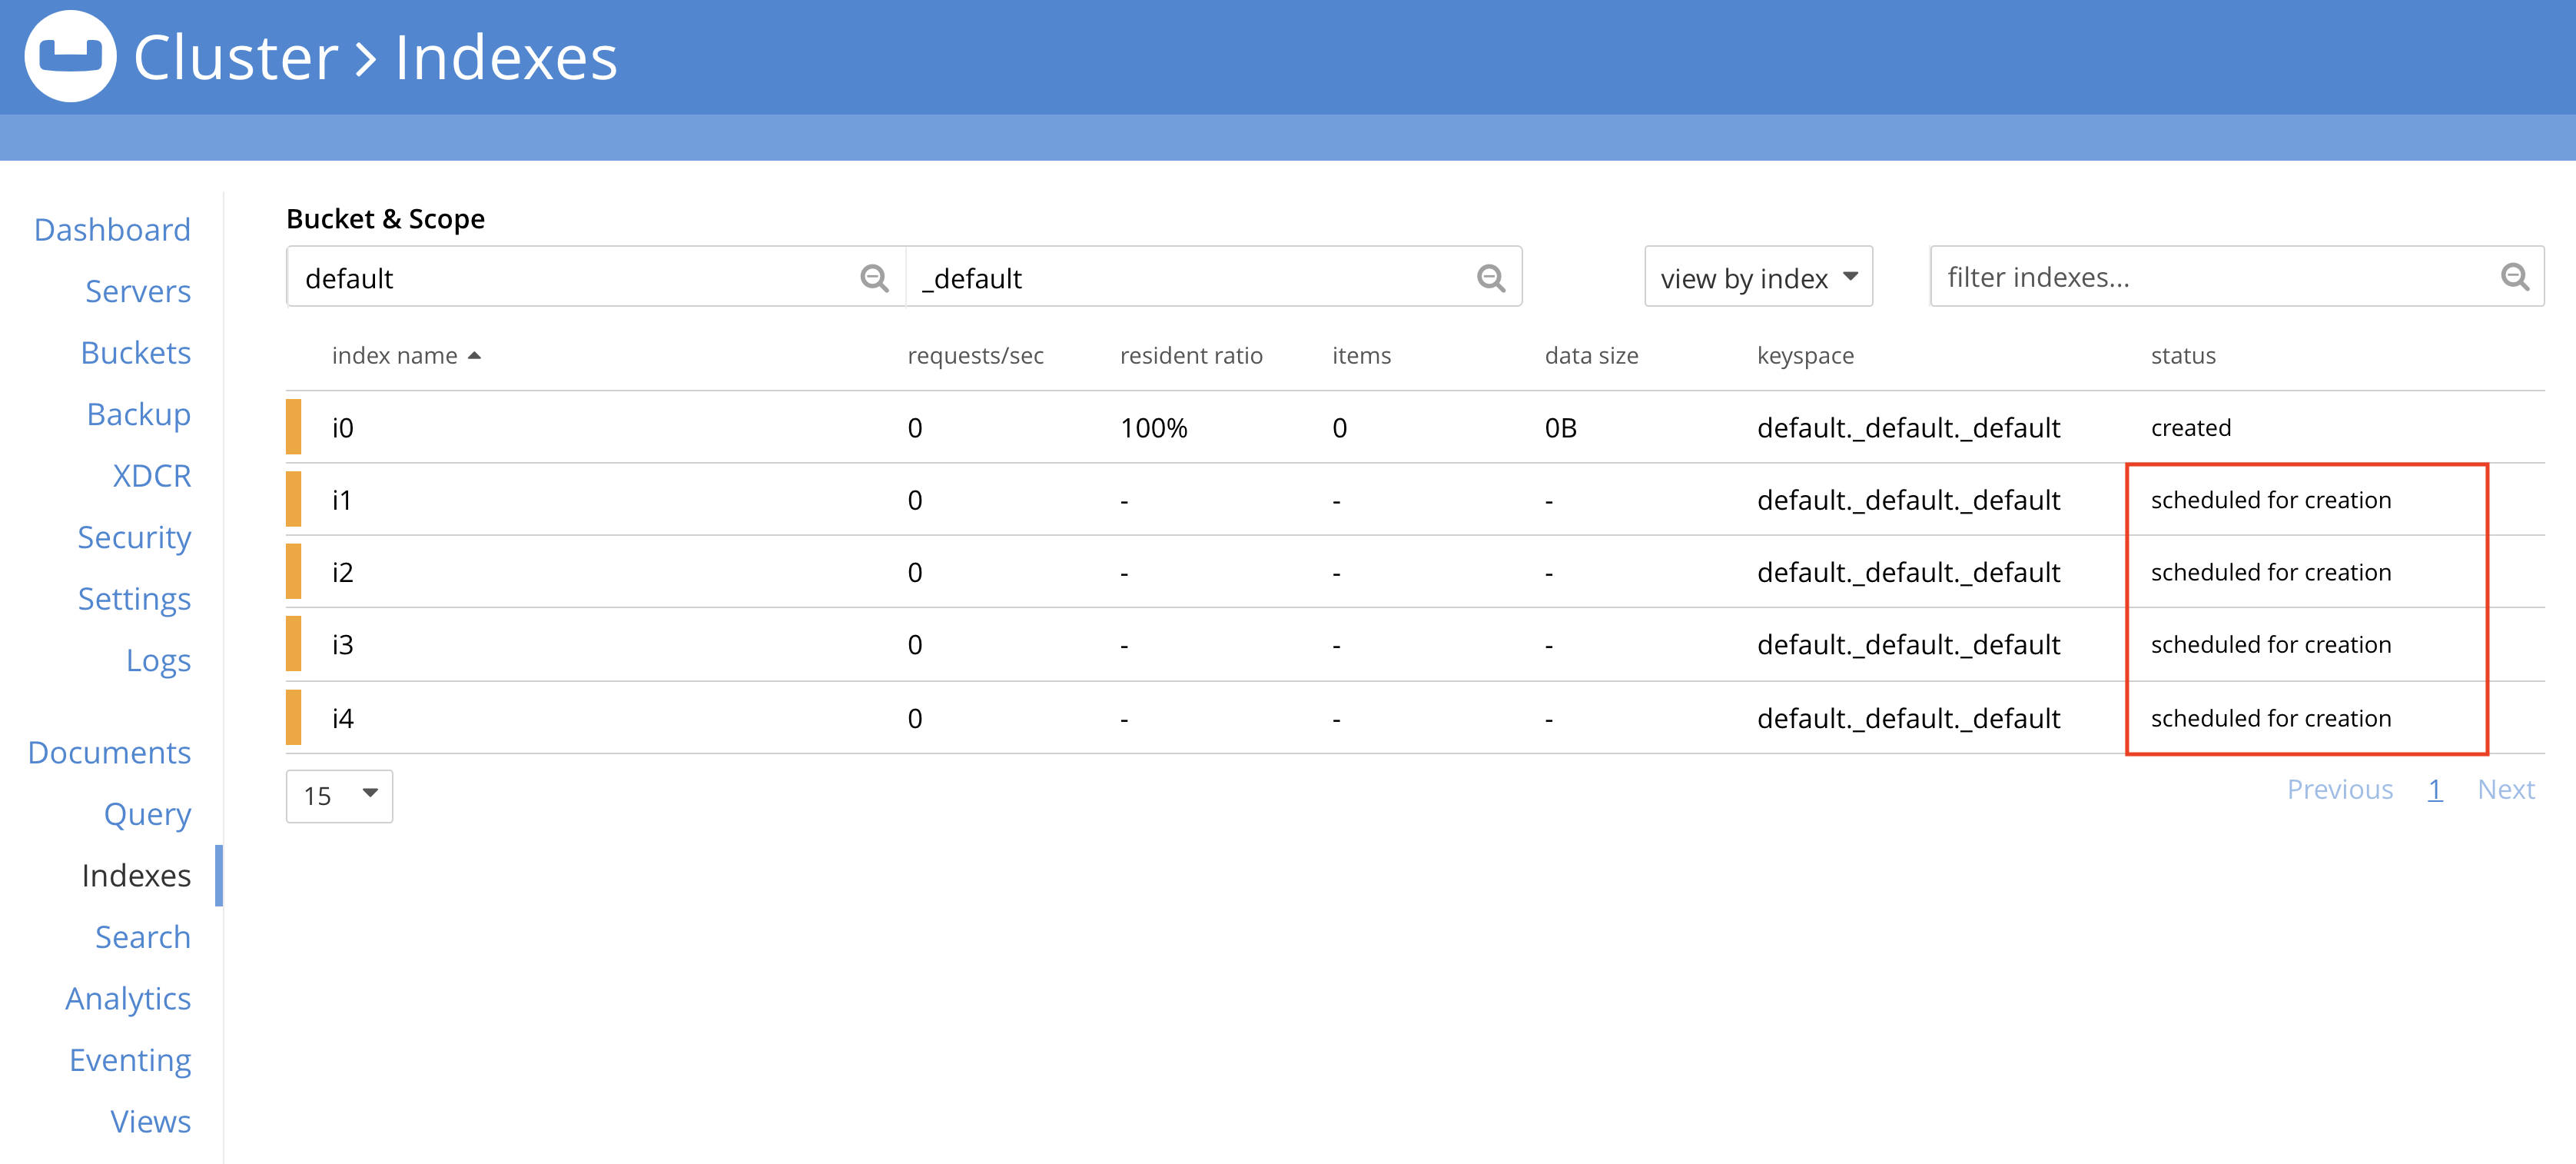
Os usuários podem monitorar os índices que estão em fila para criação em segundo plano através da interface web, conforme mostrado na imagem abaixo. Note que o índice status é planejado para criação.
Os usuários também podem monitorar o status do índice de forma programática usando o N1QL, conforme mostrado na imagem abaixo.

Experiência de usuário melhorada
Nas versões anteriores, os usuários tinham que reiniciar a criação do índice quando outro índice já estava sendo criado. Se a criação do índice estiver acontecendo por meio de um programa, este precisa de um mecanismo de replanejamento. Com o Couchbase Server 7.0, o programa do usuário não precisa depender do mecanismo de replanejamento ao criar um índice, pois o serviço de índice executará os replanejamentos necessários em segundo plano. Note que o serviço de índice não apenas realiza “replanejamentos simples”. Ele prioriza internamente as solicitações com base no tempo de registro do pedido, de forma a que a convergência das solicitações de criação de índices seja mais rápida e muito mais confiável.
O serviço de indexação serializa as criações de índices no cluster com a ajuda de um mecanismo de bloqueio distribuído globalmente. Portanto, para a criação de um índice, todos os nós do serviço de indexação precisam chegar a um consenso antes de permitir a criação do índice.
Agora, vamos analisar o seguinte cenário/exemplo para entender como a convergência é melhorada com a participação do serviço de índice.
Digamos que duas aplicações (ou microserviços) estão tentando criar índices simultaneamente. As duas aplicações podem se conectar a dois diferentes nós de serviço de consulta para a criação de índices. O nó de serviço de consulta executa um cliente de serviço de consulta que é responsável por obter a chave de bloqueio globalmente distribuída e determinar a colocação do índice ao executar o planejador de índice.
Cronologia da criação do índice na versão pré-7.0 do Couchbase
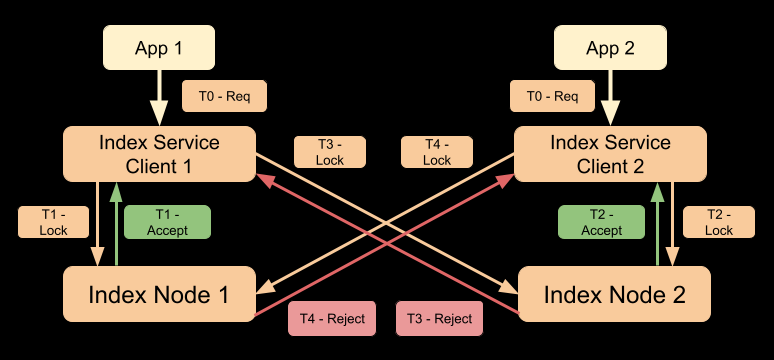
Vamos considerar uma possível linha temporal dos eventos que ocorrem no cluster (com a versão do Couchbase Server < 7.0), conforme mostrado no diagrama abaixo.
Cronologia:
T0: Ambas as aplicações iniciam simultaneamente os pedidos de criação de índices e os pedidos são recebidos pelos clientes do serviço de indexação.
T1: O cliente do serviço de indexação 1 envia o Bloqueio pedido de indexação do nó 1. Índice do nó 1 aceita O pedido.
T2: O cliente do serviço de indexação 2 envia o Bloqueio pedido de indexação do nó 2. Índice do nó 2 aceita O pedido.
T3: O cliente do serviço de indexação 1 envia o Bloqueio pedido de indexação do nó 2. Índice do nó 2 rejeita a solicitação, uma vez que já aceitou a solicitação do cliente 2.
T4: O cliente do serviço de indexação 2 envia o Bloqueio pedido de indexação do nó 1. Índice do nó 1 rejeita a solicitação, já tendo aceitado a solicitação do cliente 1.
Note que neste exemplo, na versão do Couchbase Server < 7.0, ambas as solicitações serão rejeitadas pelo Couchbase e os scripts do usuário precisarão tentar novamente. Se os scripts do usuário tentarem novamente imediatamente ou após algum período de retração determinístico, a próxima tentativa ainda pode levar a um cenário/cronograma semelhante e ambas as solicitações ainda podem ser rejeitadas na próxima tentativa.
Criando filas de indexação com o Couchbase 7.0
Com o Couchbase Server 7.0, o comportamento melhorado e uma linha temporal semelhante ao nosso exemplo são apresentados no diagrama abaixo. Note-se que a responsabilidade de criar um índice é assumida pelos criadores de índices em segundo plano, enquanto o thread da aplicação do usuário ainda aguarda a conclusão da criação do índice. O thread do usuário receberá uma resposta apenas quando o índice for criado.

Cronologia:
T0: Duas threads de criação de índices de segundo plano iniciam a criação simultânea do índice e os pedidos são recebidos pelos clientes do serviço de indexação.
T1: O cliente do serviço de indexação 1 envia o Bloqueio requerimento (com prioridade P1) para indexar o nó 1. Indexar o nó 1 aceita O pedido.
T2: O cliente do serviço de indexação 2 envia o Bloqueio requerimento (com prioridade P2) para indexar o nó 2. Índice do nó 2 aceita O pedido.
T3: O cliente do serviço de indexação 1 envia o Bloqueio requisição (com prioridade P1) para indexar o nó 2. Índice do nó 2 aceita a solicitação possui prioridade superior à solicitação previamente aceita.
T4: O cliente do serviço de indexação 2 envia o Bloqueio requer (com prioridade P2) indexar o nó 1. Indexar o nó 1 rejeita a solicitação, já tendo sido aceita com prioridade superior pelo cliente 2.
Note que o mecanismo de bloqueio distribuído utiliza um protocolo de commit em duas fases de modo que o pedido previamente aceito (com prioridade P2) no nó de índice 2 falhará durante a fase de commit e será retornado pela ferramenta de criação de índices em segundo plano.
Além disso, observe que as prioridades das solicitações são baseadas nos timestamps das solicitações gerados com granularidade de nanosegundos. Isso elimina a maioria da conflagração de bloqueios distribuídos. No entanto, existe a possibilidade de dois pedidos terem exatamente os mesmos timestamps de solicitação. Para lidar com esse caso, o serviço de índice utiliza um backoff aleatório para reduzir ainda mais a conflagração de bloqueios distribuídos.

Deixe um comentário
Você precisa fazer o login para publicar um comentário.