

소개
대다수의 사용자가 알고 계시듯, 카우치베이스(Couchbase)는 데이터의 상태가 특정 기준이나 보장 사항을 충족하도록 사용자에게 다양한 일관성 및 내결함성 옵션을 제공하는 데이터베이스입니다. 사용자는 특정 장애 시나리오 및 클러스터 운영 환경에서도 데이터의 영속성, 일관성, 무결성이 유지되도록 다양한 수준의 복제(replication), 지속성(persistence), 레플리카(replicas), 서버 그룹 등을 지정할 수 있습니다. 다가오는 6.5.0 버전에서는 새롭게 강화된 내구성 등급은 장애 발생 시 사용자에게 훨씬 더 많은 안전성과 보장을 제공합니다. 보장은 그 증명만큼만 유효하다는 것을 잘 알고 있으므로, 카우치베이스(Couchbase)에서 데이터베이스 내구성을 테스트하기 위해 업계 표준인 제프스펜(Jepsen)을 어떻게 사용하는지 자세히 살펴보겠습니다.
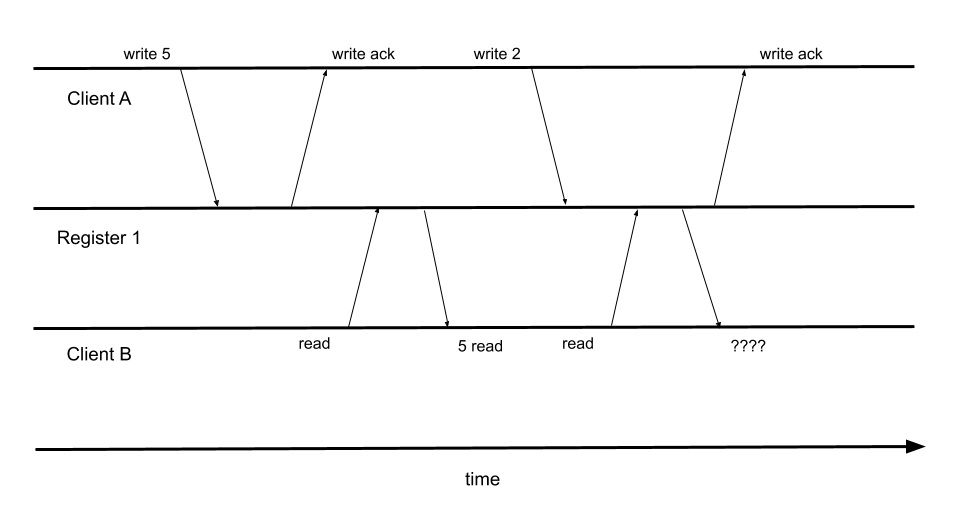
Jepsen 프레임워크는 네트워크 파티션, 프로세스 종료, 디스크 속도 저하 등과 같은 모종의 카오스를 동시 주입하면서 클러스터에 클라이언트 작업을 발생시키는 방식으로 작동합니다. 그런 다음 Jepsen은 내장되거나 사용자 정의된 작업 기록 체커를 사용하여 작업 기록을 분석합니다. 가장 주목할 만하게도, Jepsen은 다음을 제공합니다. 선형적 일관성 체커. Couchbase는 6.5.0의 새로 향상된 내구성 수준을 통해 다음과 같이 주장합니다. 순차 일관성. 그러나 선형화 가능 일관성은 순차적 일관성을 내포한다[1]. 따라서 선형화 가능 일관성 검사기를 통과한다는 것은 연산 히스토리가 실제로 순차적으로 일관됨을 의미한다. 그러나 선형화 가능 일관성 검사에 실패한다고 해서 연산 히스토리가 순차적으로 일관되지 않음을 의미하는 것은 아니다. 요약하자면, 연산이 선형화 가능 일관성 검사기를 통과할 때, 우리는 Couchbase가 순차적으로 일관된다고 가정할 수 있다. 연산이 선형화 가능 일관성 검사기를 통과하지 못하더라도 Couchbase는 여전히 순차적으로 일관될 수 있지만, 이를 확인하려면 추가적인 조사가 필요하다.
제პსენ(Jepsen)을 활용한 우리의 목표는 Java SDK 클라이언트와 서버 측 KV 엔진이 상호 협력하여 다음을 수행하는지 다양한 각도에서 테스트하는 것입니다: 1.) 확인된 쓰기 데이터를 절대 유실하지 않는 것; 그리고 2.) 클러스터 작업과 장애가 시스템에 적용되는 동안 최소한 순차적 일관성 모델을 제공하는 것.
건축
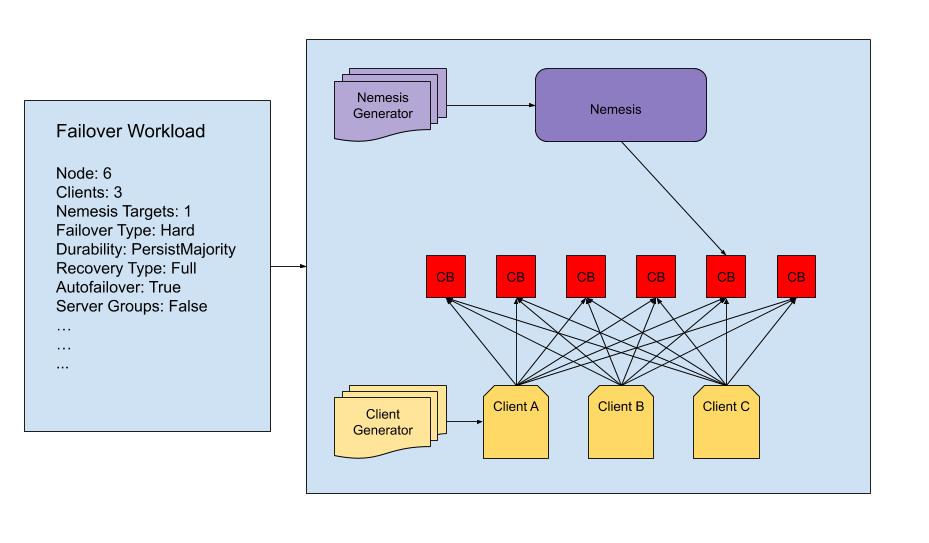
Jepsen은 데이터베이스, 클라이언트, 체커, 네메시스, 제너레이터 및 워크로드라는 추상화에 대한 인터페이스를 제공합니다. Jepsen 테스트를 생성하려면 이 모든 것을 Couchbase용으로 특별히 구현해야 했습니다. 각 테스트는 이러한 추상화들과 추가 매개변수들의 조합입니다.
데이터베이스
우리는 Couchbase 클러스터를 위한 설정, 해제, 로그 수집 로직을 구현했습니다. 이 로직은 커스텀 버킷 설정, 서버 그룹, 자동 페일오버에 대한 지원을 포함합니다. 가능한 모든 버킷 및 클러스터 설정에 대한 완전한 지원은, 가능한 클러스터의 수가 모든 순열의 테스트를 불가능하게 만들기 때문에 큰 의미가 없습니다. 하지만 우리는 가장 중요한 모든 클러스터 구성과 옵션에 대한 지원을 구축했습니다.
클라이언트
우리는 “register” 클라이언트와 “set” 클라이언트라는 두 가지 서로 다른 클라이언트를 구현했습니다. register 클라이언트는 카우치베이스 버킷의 독립된 키에 대해 값을 쓰고, 읽고, 비교 후 교환(compare-and-swap) 작업을 수행합니다. set 클라이언트는 버킷에서 문서를 추가하고 삭제하는 작업만 수행합니다. 버킷을 집합으로, 문서를 그 집합의 구성원으로 생각할 수 있습니다. 우리는 문서를 업데이트하지 않기 때문에 선형화 가능성 체커 대신 커스텀 set 체커와 함께 이 클라이언트를 사용합니다. set 클라이언트와 set 체커를 사용하는 테스트는 모두 버킷에 문서를 추가하는 단계와 버킷에서 문서를 삭제하는 단계를 엮는 방식으로 작동합니다.
두 클라이언트 모두 생성자 프로세스로부터 연산을 받습니다. (이에 대해서는 나중에 자세히 설명합니다.)
클라이언트 오류를 처리할 때는 각별한 주의가 필요하다. 예를 들어, DurabilityImpossibleException과 RequestTimeoutException은 Jepsen에서 다르게 처리되어야 한다. 전자의 경우 작업이 실패했음을 알 수 있지만, 후자의 경우 작업이 성공했을 수도 있다. 작업의 실패 여부를 구분할 수 없는 경우, Jepsen의 선형성 검사기는 작업이 실패했다고 가정하고 한 번, 성공했다고 가정하고 또 한 번 검사를 실행합니다. 이로 인해 모호한 작업 각각에 대해 검사 시간이 대략 두 배로 늘어나게 됩니다. 따라서 우리는 이러한 잠재적인 작업 결과의 수를 제한하는 테스트 시나리오를 원합니다. 두 가지 가능한 히스토리 중 적어도 하나가 선형화 가능하면 선형성 검사기는 통과합니다.
체커
우리 테스트를 위해 선형성 검사기, 집합 검사기, 그리고 무결성 검사기라는 세 가지 검사기 중에서 선택할 수 있습니다. 선형성 검사기는 Jepsen에 기본적으로 포함되어 있으며 버킷 내 독립적인 키들의 일관성을 검사하는 데 사용됩니다. 우리는 집합 클라이언트를 사용하는 테스트가 버킷에 올바른 문서 집합을 가지고 있는지 확인하기 위해 집합 검사기를 구현했습니다. 마지막으로, 테스트 자체가 오류 없이 클러스터 상태 변경 시퀀스를 거쳤는지 확인하는 무결성 검사기를 구현했습니다. 예를 들어, 테스트에는 실패해서는 안 되는 재밸런싱 과정이 포함될 수 있습니다. 이 경우, 실패한 테스트를 집합 검사기나 선형성 검사기를 통과하지 못한 테스트로 정의하고 있기 때문에, 무결성 검사기는 이 테스트를 “실패” 대신 “알 수 없음”으로 표시합니다. 무결성 검사기는 또한 적어도 일부 작업은 성공했음을 보장합니다.
네메시스
전통적으로 Jepsen에서 네메시스는 제네레이터 프로세스로부터 연산을 전달받은 후 그에 따라 시스템에 대항하여 동작을 수행하는 프로세스입니다. 예를 들어, 내장된 파티션 네메시스는 두 노드 간의 네트워크를 분할하고 복구하는 차단(block) 및 복구(restore) 연산을 받을 수 있습니다. 대부분의 내장 네메시스는 매우 기본적인 시나리오에는 충분하지만, 우리는 예를 들어 임의의 서버 그룹에서 임의의 디스크 속도를 늦추고, 동일한 서버의 memcached 프로세스를 강제 종료한 후 최종적으로 디스크를 복구하는 것과 같은 추가적인 시나리오들을 테스트하고자 했습니다.
우리가 원하는 시나리오를 테스트하기 위해, 초기 상태로부터의 상태 변화를 통해 Couchbase 클러스터를 모델링하는 단일 Couchbase 네메시스(nemesis)를 만들었습니다. 우리는 노드들과 그들의 네트워크, 서버, 디스크, 클러스터 상태에 대한 맵을 유지합니다. 연산이 발생할 때마다 시스템의 변화를 반영하여 상태가 업데이트됩니다. 네메시스에 전달되는 연산들은 노드 타겟팅 옵션, 연산, 그리고 연산 매개변수를 지정합니다. 노드 타겟팅 옵션은 예를 들어 임의의 서버 그룹에 있는 모든 정상 노드들 중에서 크기가 2인 임의의 노드 하위 집합을 타겟으로 삼도록 네메시스에 지시합니다. 이것이 바로 우리가 노드 상태를 추적하는 주된 이유이며, 이는 네메시스가 조치를 취하는 방식에 더 큰 유연성을 부여합니다.
우리의 네메시스는 다음과 같은 작업들을 지원합니다: 장애 조치(그레이스풀 및 하드), 복구(전체 및 델타), 사용자 정의 네트워크 분할, 네트워크 복구, 자동 장애 조치 대기, 노드 집합 내 리밸런싱, 노드 집합 제외 리밸런싱, 두 노드 집합 간 스왑 리밸런싱, 리밸런싱 실패 유발, 노드 집합의 프로세스(memcached, babysitter, ns_server) 종료, 노드 집합의 동일 프로세스 재시작, dcp 클라이언트 속도 저하, dcp 클라이언트 초기화, 컴팩션 트리거, 노드 집합의 디스크 장애 유발, 노드 집합의 디스크 속도 저하, 노드 집합의 디스크 복구. 우리는 향후 더 많은 네메시스 작업을 지원할 계획입니다.
발전기
Another key piece of a Jepsen test are the generators for client and nemesis operations. These generators will create a finite or infinite sequence of operations. Each test will have its own nemesis generator, but most likely shares a common client generator. A nemesis generator, for instance, might be a sequence of partition, sleep, and restore, repeated infinitely. A client generator will specify a random, infinite sequence of client operation, as well as the associated parameters such as durability level, the document key, the new value to write or cas, etc. When a test starts, the client generator feeds client operations to the client and the nemesis generator feeds operations to the nemesis. The test will continue until either the nemesis generator has completed a specified number of operations, a time limit is reached, or an error is thrown.
업무량
Jepsen 워크로드는 서버 그룹 및 자동 장애 조치 활성화와 같은 입력 매개변수를 기반으로 네메시스 및 클라이언트 생성기 로직을 수정하여, 이전의 모든 컴포넌트를 추가 매개변수와 함께 단일 테스트로 묶어주는 맵일 뿐입니다.
도전 과제
이 테스트들을 구축할 때 우리가 직면한 주요 과제는 두 가지가 있으며, 둘 다 리소스가 부족한 상황에서 비롯됩니다. 1.) 클러스터 설정 순열의 높은 수; 2.) 선형성 검사기를 실행하는 데 필요한 시간.
Couchbase는 복잡하고 고도로 커스터마이징이 가능한 데이터 플랫폼이기 때문에 조정해야 할 설정이 수백 가지에 이릅니다. 일부 설정은 이진 방식(예: 자동 장애 조치 활성화)인 반면, 다른 설정은 연속적입니다(KV용 RAM 할당량). 이로 인해 테스트해야 할 초기 클러스터 상태의 가 조합 수가 극도로 많아집니다. 그런 다음, 네메시스(nemesis) 작업을 구성할 수 있는 거의 무한한 방법과 결합하여, 완전하게 커버하기에는 너무 큰 테스트 공간이 만들어집니다.
선형성 검사기는 매우 유용하고 훌륭한 연구의 산물이지만 몇 가지 한계가 있습니다. 검사기가 히스토리를 분석하는 데 걸리는 시간은 연산의 수에 따라 기하급수적으로 증가합니다. 게다가 모호한 연산 역시 기하급수적인 성장을 유발합니다. 따라서 문제가 발생합니다. 우리는 테스트 기간 동안 클라이언트를 최대한 강하게 밀어붙이고 싶지만, 클라이언트를 너무 강하게 밀어붙이면 검사기의 메모리가 부족해져 히스토리 분석에 실패할 수 있습니다. 이는 또한 테스트가 가능한 한 빨리 실행되기를 원하지만, 이로 인해 버그를 찾을 수 있는 범위가 줄어들게 된다는 것을 의미합니다.
해결책
이러한 어려움들을 해결하기 위해, 우리는 다음과 같은 조치를 취하기로 결정했습니다: 고객에게 가장 중요한 테스트 매개변수의 하위 집합에 집중하고, 테스트를 가능한 한 짧게 유지하며, 테스트를 최대한 자주 실행하는 것입니다. 버킷 복제, 모든 새로운 향상된 내구성 수준, 자동 장애 조치 등 일반적인 매개변수만 테스트함으로써, 내구성 보장을 증명하기 위한 견고한 기반이 될 관리 가능한 테스트 세트에 집중할 수 있습니다.
우리는 우선 핵심 KV 구성에 집중했으며, 새로운 기능이 추가되거나 고객의 요청이 있을 경우 새로운 서비스와 구성(쿼리, 인덱스, xdcr 등)을 추가할 계획입니다. 다음으로, 대기 시간을 줄이고, 작업 상태를 폴링하며, 작업 수를 제한하고, 미리 로드된 문서를 없애는 방식으로 Nemesis가 최대한 빠르게 작동하도록 튜닝했습니다. 테스트 시작 시 버킷을 비워두면 테스트 중 이후의 재균형 조정 속도가 빨라집니다. 하지만 버킷에 대량의 데이터가 있고 버킷당 RAM 용량이 상대적으로 적은 시나리오도 테스트해야 합니다. 현재 준비 중인 이러한 고밀도 데이터 시나리오의 실행에는 훨씬 더 많은 시간이 소요될 것입니다. 리밸런싱 작업이 선형화 가능성 검사기의 메모리 부족을 유발하지 않을 만큼 충분히 빠르게 수행될 수 있도록 초기 데이터 로드 크기를 조정해야 합니다. 또한, 클라이언트 작업의 속도 제한으로 인해 테스트를 여러 번 실행해야 합니다. 클라이언트 작업 속도가 느릴수록 두 작업이 겹치거나 버그가 발생할 가능성이 낮은 시점에 작업이 수행될 확률은 낮아지지만, 테스트를 여러 번 실행하면 겹치는 작업의 총 횟수를 늘려 버그를 발견할 가능성을 높일 수 있습니다.
테스트를 가능한 한 자주 실행하기 위해 우리는 테스트 스위트 계층 구조를 만들었습니다. 우리의 스위트는 스모크(sanity), 일간(daily), 주간(weekly), 전체(full)의 네 가지 범주로 나뉩니다. 스모크 테스트 스위트는 새로운 커밋이 들어온 후에 실행해야 하는 소수의 테스트 하위 집합으로 구성되어 있으며, 완료하는 데 1시간 미만이 걸립니다. 더 큰 규모의 일간 스위트는 실행하는 데 12시간을 넘지 않아야 하며, 주간 스위트는 이틀 이내에 완료되어야 합니다. 전체 테스트 스위트는 모든 테스트의 목록이며 완료하는 데 대략 일주일이 걸립니다. 스위트를 만들기 위해 우리는 커버리지를 최대로 유지하면서 유사한 테스트를 제거하는 방식으로 전체 테스트 스위트를 축소했습니다. 현재 우리의 전체 스위트는 612개, 주간은 396개, 일간은 227개, 스모크는 6개의 테스트를 가지고 있습니다. 우리는 또한 이전 릴리스(4.6.x, 5.0.x, 5.5.x, 6.0.x)의 버그들이 제품에 더 이상 존재하지 않는지 확인하는 데 사용하는 버그 전용 스위트도 가지고 있습니다. 이러한 유형의 버그의 예는 다음과 같습니다 MB-29369 그리고 MB-29480.
결과
우리의 헵센(Jepsen) 테스트는 카우치베이스(Couchbase) 내의 여러 버그를 성공적으로 찾아냈습니다. 이 버그들은 일반 제품 버그, 그리고 데이터 내구성 및 일관성 버그의 두 가지 범주로 나뉩니다. 내구성 및 일관성 버그는 우리가 헵센 테스트를 시작한 이유이므로, 일반 제품 버그를 잡아내는 완전한 기능 회귀 테스트 스위트를 갖추고 있는 우리에게는 이 버그들이 더 중요하다고 간주됩니다. 우리가 발견한 내구성 및 일관성 버그의 몇 가지 예시는 다음과 같습니다. MB-35135, MB-35060, 그리고 MB-35053.
초기 Jepsen 작업과 이를 통해 발견한 버그들은 다양한 장애 시나리오와 클러스터 작업 전반에서 데이터를 안전하게 보호하는 Couchbase의 능력에 대한 우리의 확신을 높여주었습니다. 그러나 Jepsen이 수백 번의 실행 후에야 잠재적으로 버그를 잡아낼 수도 있으므로, 지속적인 테스트가 필요합니다. 우리는 더 많은 시나리오에 대한 지원을 구축하는 동시에 매일 그리고 매주 Jepsen 테스트를 계속해서 실행할 것입니다. Jepsen은 데이터 일관성 및 내구성 보장을 갖춘 시스템을 구축할 때 없어서는 안 될 도구이며, 우리는 이를 계속 활용하고 그 역량을 확장해 나갈 것입니다.
링크:
[1] https://courses.csail.mit.edu/6.852/01/papers/p91-attiya.pdf
[3] https://jepsen.io/consistency/models/linearizable
[4] https://jepsen.io/consistency/models/sequential
[5] https://github.com/jepsen-io/jepsen
추가 리소스
다운로드
문서
블로그
블로그: Couchbase Server 6.5 GA 출시 – 새로운 기능 및 개선 사항

댓글 남기기
댓글을 달기 위해서는 로그인해야합니다.