개발자인 우리에게 데이터 스프로울(데이터 무분별한 확산)이라는 용어는 TCO, ROI 등과 같은 비즈니스 용어처럼 들릴 수 있습니다. 이러한 모든 용어들은 분석가와 관리자의 영역을 넘어, 개발자들에게도 실질적인 의미가 있습니다. 그래서 오늘 저는 개발자들에게 데이터 스프로울이 가지는 현실과 그것이 우리의 작업에 미치는 영향에 대해 이야기하고자 합니다.
데이터 스프롤은 우리가 방대한 양의 데이터를 여러 서로 다른 데이터 저장소에 분산 저장하고 있으며, 게다가 개발자인 우리들은 그 데이터 저장소들이 서로 상호작용하도록 만들어야 한다는 말로 요약할 수 있습니다. 그리고 물론, 많을수록 다익선이죠 😬?
보통 이는 다음 분야에서 더 높은 재정적 비용과 관련이 있습니다:
- 인프라
- 라이선스
- 통합
- 훈련
- 가동 중
- 지원 비용
여러 개의 인터페이스를 가진 분리된 플랫폼은 다음과 같은 이유로 골치 아픈 문제를 야기합니다.
- 독립적인 배포 및 관리
- 다른 데이터 모델 및 프로그래밍 인터페이스
- 여러 제품 간의 통합
- 다양한 공급업체의 지원 티켓
그리고 우리는 다음의 이유로 더 많은 시간, 노력, 비용을 들여야 합니다:
- 라이선스 및 계약
- 개발자 및 운영자 교육
- 지원
- 데이터베이스용 API 또는 커넥터 구축
- 인프라 구매
이렇게 보면 다소 암울하지만, 이는 많은 기업들에게 일상적인 과제입니다. 그리고 이는 서로 다른 데이터 워크로드뿐만 아니라 클라우드 애플리케이션에도 마찬가지로 적용됩니다.
구체적인 예를 살펴보겠습니다. 저는 문서 데이터베이스의 CRUD, 캐싱 스토어의 캐시, 그리고 전문 검색 엔진의 검색을 사용하는 애플리케이션을 만들었습니다.GitHub 소스)
이 스키마를 보면, 보이는 모든 화살표를 개발자가 생각하고 코딩해야 하는 서로 다른 시스템 간의 상호작용 하나로 기본적으로 셀 수 있습니다.
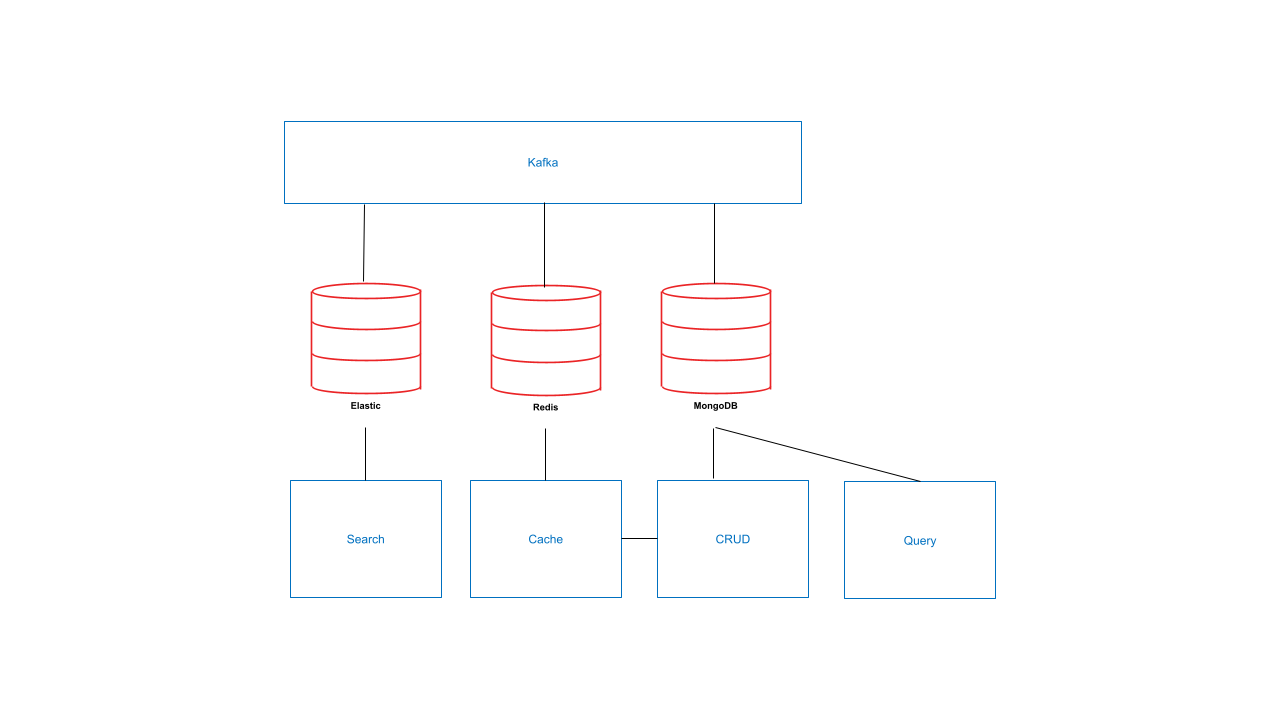
여기 우리는 이벤트 스트리밍을 사용하여 캐시와 검색 데이터베이스를 자동으로 동기화하고 있습니다. 이는 학습하고 관리해야 할 8개의 상호작용과 4개의 데이터 저장소를 의미합니다. 모든 저장소가 스트리밍 서비스에 연결되어 있고 올바른 업데이트를 받도록 해야 하므로, 스트리밍 서비스, 검색, 캐시 및 데이터 저장소를 관리해야 합니다. 또한 캐시를 CRUD 서비스와 통합해야 합니다(이상적으로는 다른 서비스와도 통합해야 하지만 단순하게 유지합시다). 요컨대, 해야 할 일이 아주 많습니다.
우리는 스트리밍 서비스를 없애고 다른 서비스들을 수동으로 업데이트하도록 함으로써 그러한 상호작용을 제한할 수 있습니다. 이것은 라이선스, 운영해야 할 것, 배워야 할 것, 통합해야 할 것을 각각 하나씩 줄여줍니다. 여전히 이상적이지는 않지만 다음과 같을 수 있습니다:
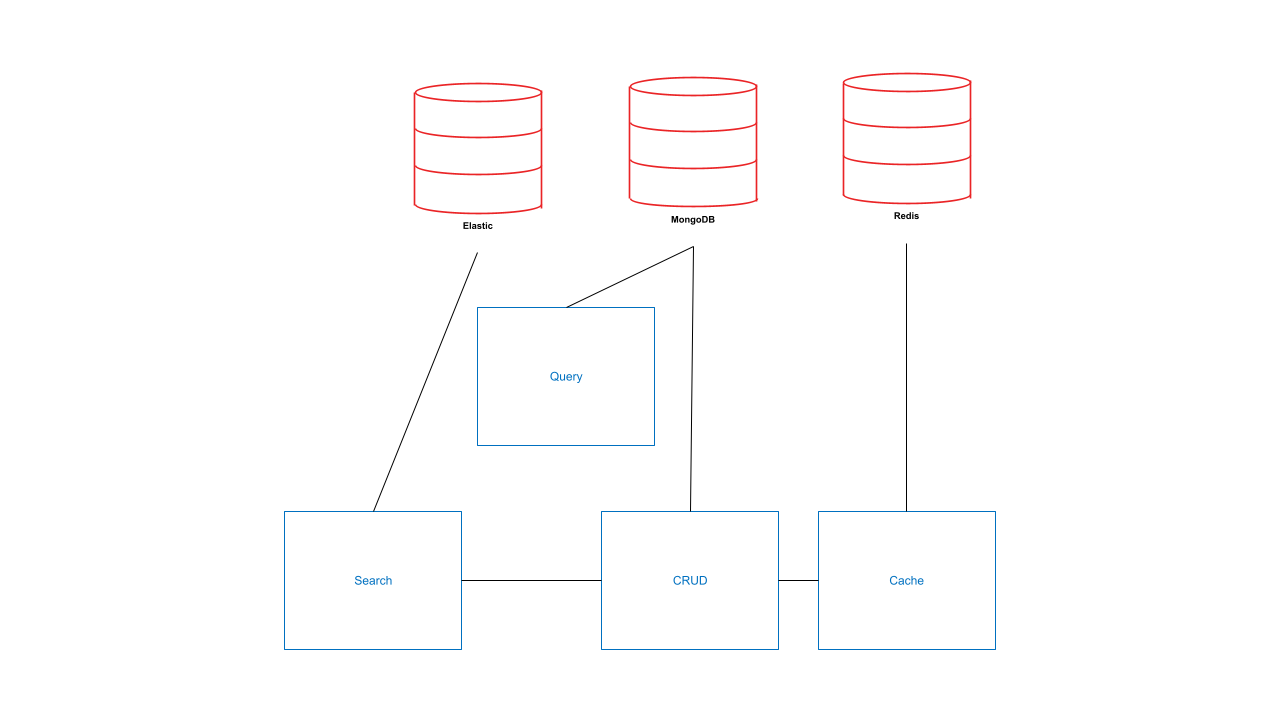
조금 더 단순해서 8개와 4개 대신 상호작용이 6개, 데이터 저장소가 3개뿐입니다. 하지만 여전히 상호작용이 많고 스트리밍 통합의 일부는 수동으로 해야 합니다. 반면에 이전에는 기존 서비스 간의 기존 커넥터를 학습하여 사용할 수 있었습니다. 이를 위해 작성된 Java/Spring Boot 예제 코드를 간단히 살펴보겠습니다.
개발자가 데이터 저장소로 할 수 있는 일을 나타내는 4가지 인터페이스가 있습니다. CRUD, 캐시, 쿼리, 그리고 검색입니다.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 |
공공의 인터페이스 CRUD { 저장된파일문서 읽다(문자열 아이디); 무효 만들다(문자열 아이디, 저장된파일문서 의사); 무효 업데이트(문자열 아이디, 저장된파일문서 의사); 무효 업서트(문자열 아이디, 저장된파일문서 의사); 무효 삭제(문자열 아이디); } 공공의 인터페이스 캐시 { 무효 캐시에 기록(저장된파일문서 의사); 저장된파일문서 캐시에서읽기(문자열 아이디); 무효 터치(문자열 아이디); 무효 퇴거시키다(문자열 아이디); } 공공의 인터페이스 질문 { 목록<지도<문자열, 물체>> 질의(문자열 whereClause); 목록<지도<문자열, 물체>> 모두찾기(); } 공공의 인터페이스 검색 { 목록<지도<문자열, 물체>> 검색(문자열 기간); 무효 색인(저장된파일문서 의사); 무효 삭제(문자열 아이디); } |
이 게시물에서 모든 코드를 보여드리지는 않고, 흥미로운 부분 몇 가지만 보여드리겠습니다.
우리는 CRUD 서비스가 검색(Search) 및 캐시(Cache) 서비스와 연결되어 있는 구성에 와 있습니다. 단순화된 버전으로 이것이 어떻게 보일지 살펴봅시다. 캐시와 검색 서비스가 필수적이므로 우리는 이를 가져와야(import) 합니다. 그로부터 모든 메서드가 영향을 받습니다. 읽기(Read)는 먼저 캐시를 조회하여 객체가 캐시에서 마지막으로 발견된 시간을 업데이트하거나, 데이터베이스에서 가져와 캐시에 삽입해야 합니다. 그런 다음 생성(Create), 수정(Update), 삭제(Delete) 메서드는 새로 생성, 수정 또는 삭제된 데이터를 캐시나 검색 데이터스토어 인덱스에 전파해야 하므로 모두 캐시와 검색에 영향을 미칩니다.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 |
@Service 공공의 클래스 몽고크루드 구현한다 CRUD { 사적인 몽고컬렉션<StoredFileDocument> 컬렉션; 사적인 캐시 캐시; 사적인 검색 검색; 공공의 몽고크루드(몽고컬렉션<StoredFileDocument> 컬렉션, 캐시 캐시, 검색 검색) { 이것.컬렉션 = 컬렉션; 이것.캐시 = 캐시; 이것.검색 = 검색; } @Override 공공의 저장된파일문서 읽다(문자열 아이디) { 저장된파일문서 의사 = 캐시.캐시에서읽기(아이디); 만약 (의사 == null) { 시스템.밖으로.println(아이디); 의사 = 컬렉션.찾다(동등(“fileId”, 아이디)).첫 번째(); 캐시.캐시에 기록(의사); } 그 외 { 캐시.터치(아이디); } 반환 의사; } @Override 공공의 무효 만들다(문자열 아이디, 저장된파일문서 의사) { 의사.setFileId(아이디); 컬렉션.삽입하다(의사); 캐시.캐시에 기록(의사); 검색.색인(의사); } @Override 공공의 무효 업데이트(문자열 아이디, 저장된파일문서 의사) { 컬렉션.findOneAndReplace(동등(“fileId”, 아이디), 의사); 캐시.터치(아이디); 검색.색인(의사); } @Override 공공의 무효 업서트(문자열 아이디, 저장된파일문서 의사) { FindOneAndReplaceOptions 옵션 = 새로운 FindOneAndReplaceOptions().업서트(참인); 컬렉션.findOneAndReplace(동등(“fileId”, 아이디), 의사, 옵션); 캐시.터치(아이디); 검색.색인(의사); } @Override 공공의 무효 삭제(문자열 아이디) { 컬렉션.하나삭제(동등(“fileId”, 아이디)); 캐시.퇴거시키다(아이디); 검색.삭제(아이디); } } |
카우치베이스를 사용하면 대략 이런 형태에 더 가까워질 것입니다:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 |
@Service 프로필(“카우치베이스”) 공공의 클래스 카우치베이스CRUD 구현한다 CRUD { 사적인 수집 컬렉션; 공공의 카우치베이스CRUD(수집 컬렉션) { 이것.컬렉션 = 컬렉션; } @Override 공공의 저장된파일문서 읽다(문자열 아이디) { 결과가져오기 응답 = 컬렉션.얻다(아이디); 반환 응답.내용로서(저장된파일문서.클래스); } @Override 공공의 무효 만들다(문자열 아이디, 저장된파일문서 의사) { 뮤테이션 결과 응답 = 컬렉션.삽입하다(아이디, 의사); } @Override 공공의 무효 업데이트(문자열 아이디, 저장된파일문서 의사) { 뮤테이션 결과 응답 = 컬렉션.교체하다(아이디, 의사); } @Override 공공의 무효 업서트(문자열 아이디, 저장된파일문서 의사) { 뮤테이션 결과 응답 = 컬렉션.업서트(아이디, 의사); } @Override 공공의 무효 삭제(문자열 아이디) { 뮤테이션 결과 응답 = 컬렉션.제거(아이디); } } |
캐시 및 검색 서비스에 대한 의존성이 필요 없는 이유는 Couchbase가 이미 캐시와 검색 엔진을 통합하고 있기 때문입니다. Cache 인터페이스를 구현할 필요가 없으며, 검색 인터페이스의 delete 및 index 메서드를 구현할 필요도 없습니다. 모든 것이 자동화되어 통합되어 있습니다.
제가 그 점을 누군가에게 설명할 때면 보통, 모든 작업을 수행할 수 있으려면 상충 관계(trade-offs)를 감수해야 하므로 상황이 얼마나 안 좋을지에 대한 대화가 이어집니다. 모든 데이터 플랫폼은—멀티 모델이든, 멀티 워크로드든, 어떤 방식으로 부르든 간에—모두 동등하게 만들어지지 않았으며, 적어도 동일한 아키텍처를 염두에 두고 만들어진 것은 아닙니다.
카우치베이스는 내부 스트리밍 서비스를 통해 모두 통합되어 있으면서 각각 다른 워크로드를 담당하는 여러 개의 서로 다른 데이터베이스로 볼 수 있습니다. 이러한 방식으로 카우치베이스의 모든 부분은 자동으로 최신 상태로 유지되며, 각 부분은 고유한 데이터 워크로드에 특화될 수 있습니다. 결국 3개의 상호작용과 1개의 데이터 저장소를 얻게 됩니다.
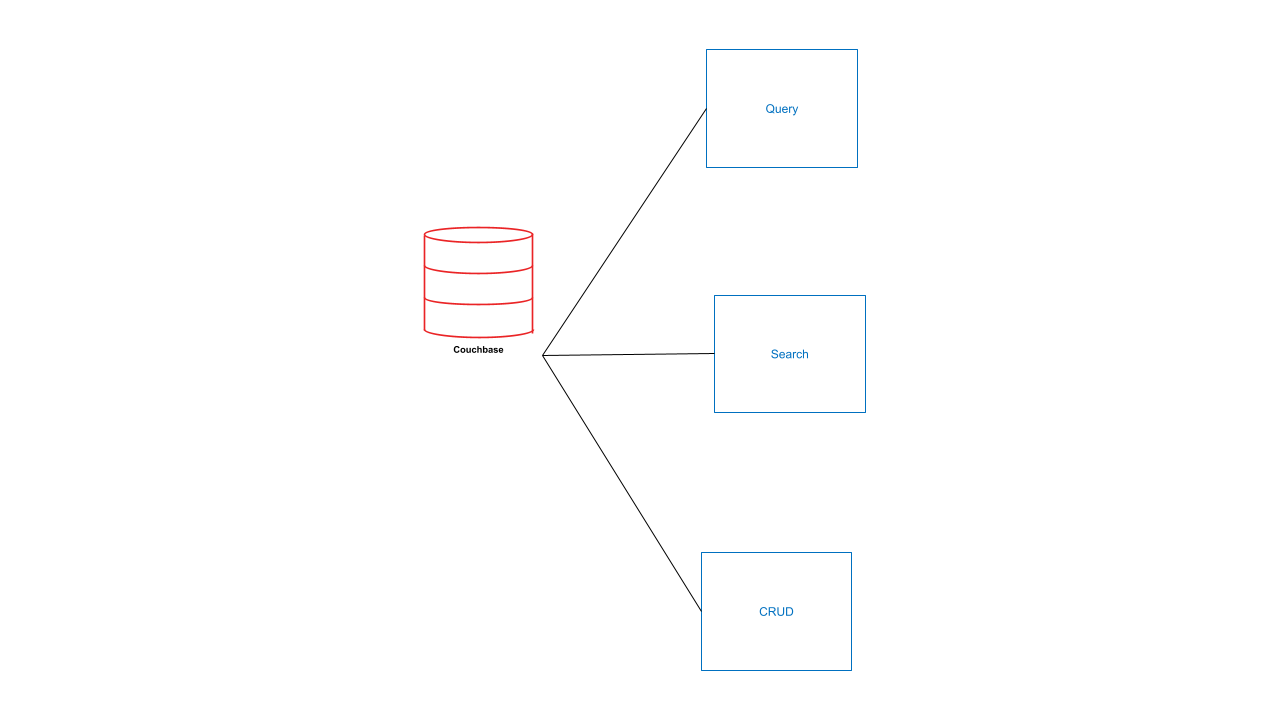
이제 이것만으로도 꽤 좋지만, 저희에게는 한 가지가 더 있습니다. 저희의 서비스들은 쿼리 언어인 SQL++에 통합되어 있습니다. 예를 들어보겠습니다. 다양한 권한이 부여된 문서 트리를 보유하고 있는 CMS가 있다고 가정해 봅시다. 이러한 권한은 하위 문서에 상속될 수 있으며, 여러분은 특정 권한을 가진 연결된 사용자로 검색을 실행하고자 합니다. 만약 외부 검색 엔진을 사용하고 있다면, 보통 다음과 같은 일이 발생합니다:
- 검색 엔진에 검색어를 실행합니다
- 반환된 문서의 모든 내용이 색인화되어 있지 않으므로 해당 문서들의 식별자를 수집하세요.
- 전체 문서를 가져오기 위해 쿼리를 실행하세요
- Query 서비스가 JOIN을 지원하지 않는 경우, 상속된 권한을 가져오기 위한 다른 쿼리를 실행하고 문서들을 필터링하세요.
상황을 더 복잡하게 (그리고 어쩌면 더 현실적으로) 만들고 싶다면 각 단계에 커스텀 캐싱 로직을 추가할 수도 있습니다. 하지만 지금도 충분히 복잡합니다.
카우치베이스는 모든 것을 한 번에 처리할 수 있습니다. 단 하나의 SQL++ 쿼리로 검색하고, 원하는 필드를 선택하며, 권한을 분류하기 위해 다른 문서와 JOIN할 수 있습니다. 그것이 전부입니다. 카우치베이스는 잘 통합된 데이터 플랫폼이므로, 그 쿼리 언어를 통해 모든 기능을 활용할 수 있습니다. 관심이 있으시다면, 자세한 내용은 다음 게시물에서 다루게 될 수도 있습니다.
마무리하다
자, 오늘 무엇을 배웠나요? 잘 설계된 데이터 플랫폼을 사용하면 시간, 비용, 노력, 그리고 머릿결이 아픈 일들을 엄청나게 아낄 수 있습니다. 왜냐하면 결국 신경 써야 할 일도 줄어들고, 작성해야 할 코드가 줄어들며, 이는 곧 유지보수해야 할 코드가 줄어들고 프로덕션 배포 속도가 빨라진다는 것을 의미하기 때문입니다. 다행히도, 라이선스, 교육, 컴플라이언스 등 관리자, 분석가, 여러분의 상사, 그리고 그 상사의 상사까지 신경 쓰는 모든 부분도 단순화하고 비용을 절감해 줍니다!
- RedMonk과의 대담 시청하기: 데이터 스프로울(Data Sprawl)이란 무엇이며, 플랫폼을 활용해 이를 관리(Wrangle)하는 방법
- 제 코드를 확인해 보세요 데이터 확산 예시
- 방법에 대해 자세히 알아보기 카우치베이스 서비스 개발을 원활하고 단순하게 만들도록 설계되었습니다.
- 한 번 사용해 보세요 카우치베이스 카펠라 DBaaS 시험해 보다

댓글 남기기
댓글을 달기 위해서는 로그인해야합니다.