생성형 AI 작업은 대부분의 조직에서 진행 중이지만, 데이터 기반은 고르지 않습니다. Couchbase는 제품, 엔지니어링, 데이터, AI 분야의 전문가 619명을 대상으로 UserEvidence에 의뢰하여 독립적인 시장 조사를 진행했으며, 이는 특히 개발자 생산성, 데이터 분석, 챗봇 분야에서 강한 자신감과 증가하는 활동을 보여줍니다. 동시에 많은 팀들이 단일 모델에 의존하고 통합된 멀티 모델 데이터베이스가 부족한 반면, 환각 현상(hallucination)과 데이터 프라이버시에 대한 우려는 여전히 널리 퍼져 있습니다. 기업들이 생성형 AI를 어떻게 채택하고 있는지, RAG 및 데이터 파이프라인에서 병목 현상이 어디서 발생하는지, 그리고 현대적인 NoSQL 데이터 레이어가 팀이 파일럿에서 프로덕션으로 전환하는 데 어떻게 도움을 줄 수 있는지 데이터를 통해 확인해 보세요.
 AI 도입과 데이터 기반
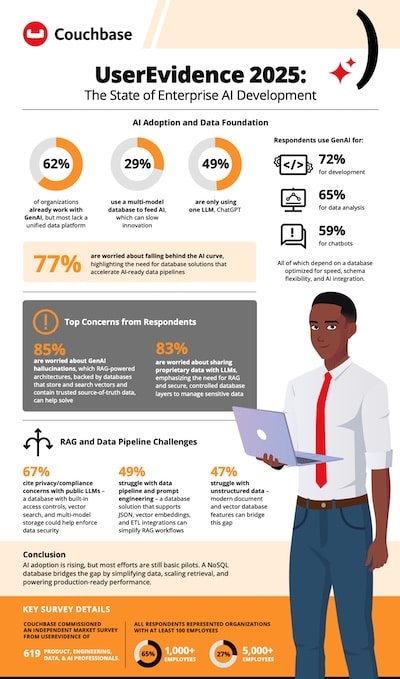
설문조사 대상 조직의 62%가 이미 생성형 AI를 도입하여 작업하고 있지만, 대부분 통합 데이터 플랫폼이 부족한 실정입니다. AI에 데이터를 공급하기 위해 멀티 모델 데이터베이스를 사용한다고 답한 비율은 29%에 불과하며, 이는 프로젝트가 확장됨에 따라 혁신을 늦출 수 있습니다. 단편화된 스택은 오류 추적, 민감 정보 거버넌스, 지연 시간 기대치 충족을 더욱 어렵게 만듭니다.
모델 사용은 초기 단계이자 집중되어 있으며, 응답자의 49%가 단 하나의 LLM, 주로 ChatGPT만 사용하고 있습니다. 한편, 77%는 AI 트렌드에 뒤처질까 우려하고 있으며, 이는 AI를 위한 더 빠르고 반복 가능하며 안전한 데이터 파이프라인의 필요성을 강조합니다. 현재 사용은 실용적이고 데이터 집약적이며, 72%는 개발에, 65%는 데이터 분석에, 59%는 챗봇에 사용되고 있습니다. 이 모든 워크로드는 속도, 스키마 유연성, AI 통합에 최적화된 데이터베이스에 의존합니다.
통합되고 개발자 친화적인 데이터 레이어가 없다면, 팀들이 유망한 파일럿 단계에서 지속 가능한 프로덕션 급 경험으로 나아가는 데 어려움을 겪을 수밖에 없어 보입니다.
응답자들이 꼽은 주요 우려 사항
응답자들의 주된 관심사는 신뢰에 집중되어 있습니다. 85%는 생성형 AI의 환각 현상에 대해 우려하고 있으며, 83%는 LLM과 독점 데이터를 공유하는 것을 걱정합니다. 이 두 가지 문제를 모두 해결하려면 신뢰할 수 있는 원본 데이터를 가까이에 유지하면서 벡터를 저장하고 검색할 수 있는 데이터베이스의 지원을 받는 RAG 아키텍처가 필요하며, 이를 통해 답변의 기반이 탄탄하고 신뢰할 수 있게 됩니다. 또한, 유용한 검색을 여전히 가능하게 하면서도 접근 규칙을 시행하고 유출을 방지하는 안전하고 통제된 데이터 레이어가 요구됩니다. 요하자면, 신뢰는 고객 대면 AI의 관문이며, 명확한 거버넌스를 갖춘 기반 검색은 나중에 추가하는 것이 아니라 처음부터 설계되어야 합니다.
RAG 및 데이터 파이프라인 과제
응답자들은 핵심 데이터 책무와 직접적으로 연관되는 몇 가지 과제를 지적했습니다. 67%는 공공 LLM과 관련된 프라이버시 및 규정 준수 문제를 언급하며, 보안 정책을 시행하기 위해 내장된 접근 제어, 벡터 검색, 멀티 모델 스토리지를 갖춘 데이터베이스의 필요성을 강조했습니다. 49%는 데이터 파이프라인과 프롬프트 엔지니어링으로 인해 어려움을 겪고 있으며, 이는 JSON, 네이티브 vector embeddings, ETL 통합을 지원하는 플랫폼을 통해 깨지기 쉬운 접착 코드(glue code)를 줄임으로써 단순화할 수 있습니다. 47%는 비정형 데이터 관리의 어려움을 보고했으며, PDF, 텍스트, 메타데이터를 함께 처리하는 문서 및 벡터 기능은 이러한 격차를 줄이고 검색을 안정적으로 만들 수 있습니다.
이상적인 모습은 RAG 데이터 생명주기에 대한 체계적인 접근 방식입니다. 우선순위가 높은 소스를 통합하고, 청킹과 메타데이터를 표준화하며, 벡터를 원본 데이터와 함께 배치하고, 접근 제어를 시행하십시오. 엔드투엔드로 지연 시간을 측정하고, 조치가 취해지기 전에 응답을 검증하는 단계를 추가하여 정확성과 신뢰성을 측정 가능하게 만드십시오.
종합하기: NoSQL 데이터베이스가 도움이 되는 부분
현대적인 NoSQL 플랫폼은 JSON 우선 모델을 통해 정형, 반정형, 비정형 데이터를 통합하고, 단일 진실 공급원(source of truth) 옆에 벡터를 저장 및 쿼리하며, 지역 간 실시간 검색을 제공할 수 있습니다. 이는 RAG의 복잡성을 줄이고, 거버넌스를 강화하며, 사용자 대면 AI가 요구하는 1초 미만의 성능을 지원합니다.
결론
AI에 대한 신뢰는 높지만 성숙도는 초기 단계입니다. 대부분의 업무는 복잡한 에이전트나 엔터프라이즈 애플리케이션보다는 코파일럿, 챗봇, 단일 모델 테스트 같은 파일럿 수준에 머물러 있습니다. 이러한 야망과 현실 사이의 격차는 낮은 신뢰도와 맞물려 있으며, NoSQL 데이터베이스가 데이터를 단순화하고, RAG 검색을 확장하며, 프로덕션 성능을 제공함으로써 조직이 실험에서 실제 성과로 나아갈 수 있도록 도울 수 있는 부분입니다. 전체 조사 결과는 다음에서 확인하세요. 엔터프라이즈 AI 개발 현황: 구현 인사이트 및 아키텍처의 현실.
자세히 알아보기 고객들이 카우치베이스를 활용하는 방법 상시 가동되는 모바일 애플리케이션을 빠르고 합리적인 비용으로 구축할 수 있습니다. 또한 지금 무료로 Capella App Services에 가입하세요.
댓글 남기기
댓글을 달기 위해서는 로그인해야합니다.