

Couchbase Capella ha lanzado un Vista previa privada de los servicios de IA¡Echa un vistazo! este blog para obtener una descripción general de cómo estos servicios simplifican el proceso de creación de aplicaciones de IA escalables y nativas de la nube y agentes de IA.
En este blog, exploraremos el Servicio de modelo – una función en Capella que le permite implementar modelos de lenguaje privados y modelos de incrustación de forma segura y a escala. Este servicio permite que la inferencia se ejecute cerca de sus datos para mejorar el rendimiento y el cumplimiento.
¿Por qué usar Capella Model Service?
Muchas empresas enfrentan desafíos de seguridad y cumplimiento al desarrollar agentes de inteligencia artificial. Debido a regulaciones como Protección del RGPD y de la IPI, las empresas a menudo no pueden usar modelos de lenguaje abiertos ni almacenar datos fuera de su red interna. Esto limita su capacidad de explorar soluciones impulsadas por inteligencia artificial.
El Servicio de modelo Capella esto lo aborda simplificando las complejidades operativas de implementar un modelo de lenguaje privado dentro de la misma red interna que el clúster del cliente.
Esto garantiza:
- Datos utilizados para la inferencia nunca sale del límite de la red virtual del clúster operativo
- Inferencia de baja latencia debido a la mínima sobrecarga de red
- Cumplimiento con políticas de seguridad de datos empresariales
Características principales del Servicio del Modelo Capella
- Despliegue seguro de modelos – Ejecutar modelos en un entorno seguro y aislado
- Compatibilidad con API y SDK compatibles con OpenAI – Invoque fácilmente modelos alojados en Capella con bibliotecas y marcos compatibles con OpenAI como Langchain
- Mejoras de rendimiento – Incluye almacenamiento en caché y procesamiento por lotes de ofertas de valor agregado para mayor eficiencia
- Herramientas de moderación – Ofrece capacidades de moderación de contenido y filtrado de palabras clave
Primeros pasos: implementar y usar un modelo en Capella
Pasemos por un tutorial sencillo para desplegar un modelo en Capella y usarlo para tareas básicas de IA.
Lo que aprenderás:
- Despliegue de un modelo de lenguaje en Capella
- Usando el modelo para finalizaciones de chat
- Explorando características de valor agregado
Prerrequisitos
Antes de comenzar, asegúrese de tener:
- Inscrito en la versión preliminar privada y servicios de IA habilitados para su organización. ¡Regístrate aquí!
- Rol de propietario de la organización permisos para administrar modelos de lenguaje
- Un clúster operativo multi-AZ (recomendado para un mejor rendimiento)
- Cubetas de muestra para aprovechar funciones de valor agregado como el almacenamiento en caché y el procesamiento por lotes
Paso 1: Implementación del modelo de lenguaje
Objetivo de aprendizaje: Aprender a implementar un modelo de lenguaje privado en Capella y configurar ajustes clave.
Navegar a Servicios de IA en la página de inicio de Capella y haz clic en Servicio de modelo para continuar.

Seleccionar configuración del modelo
- Elija un clúster operativo para su modelo
- Definir cálculo de dimensiones y seleccione un modelo fundamental
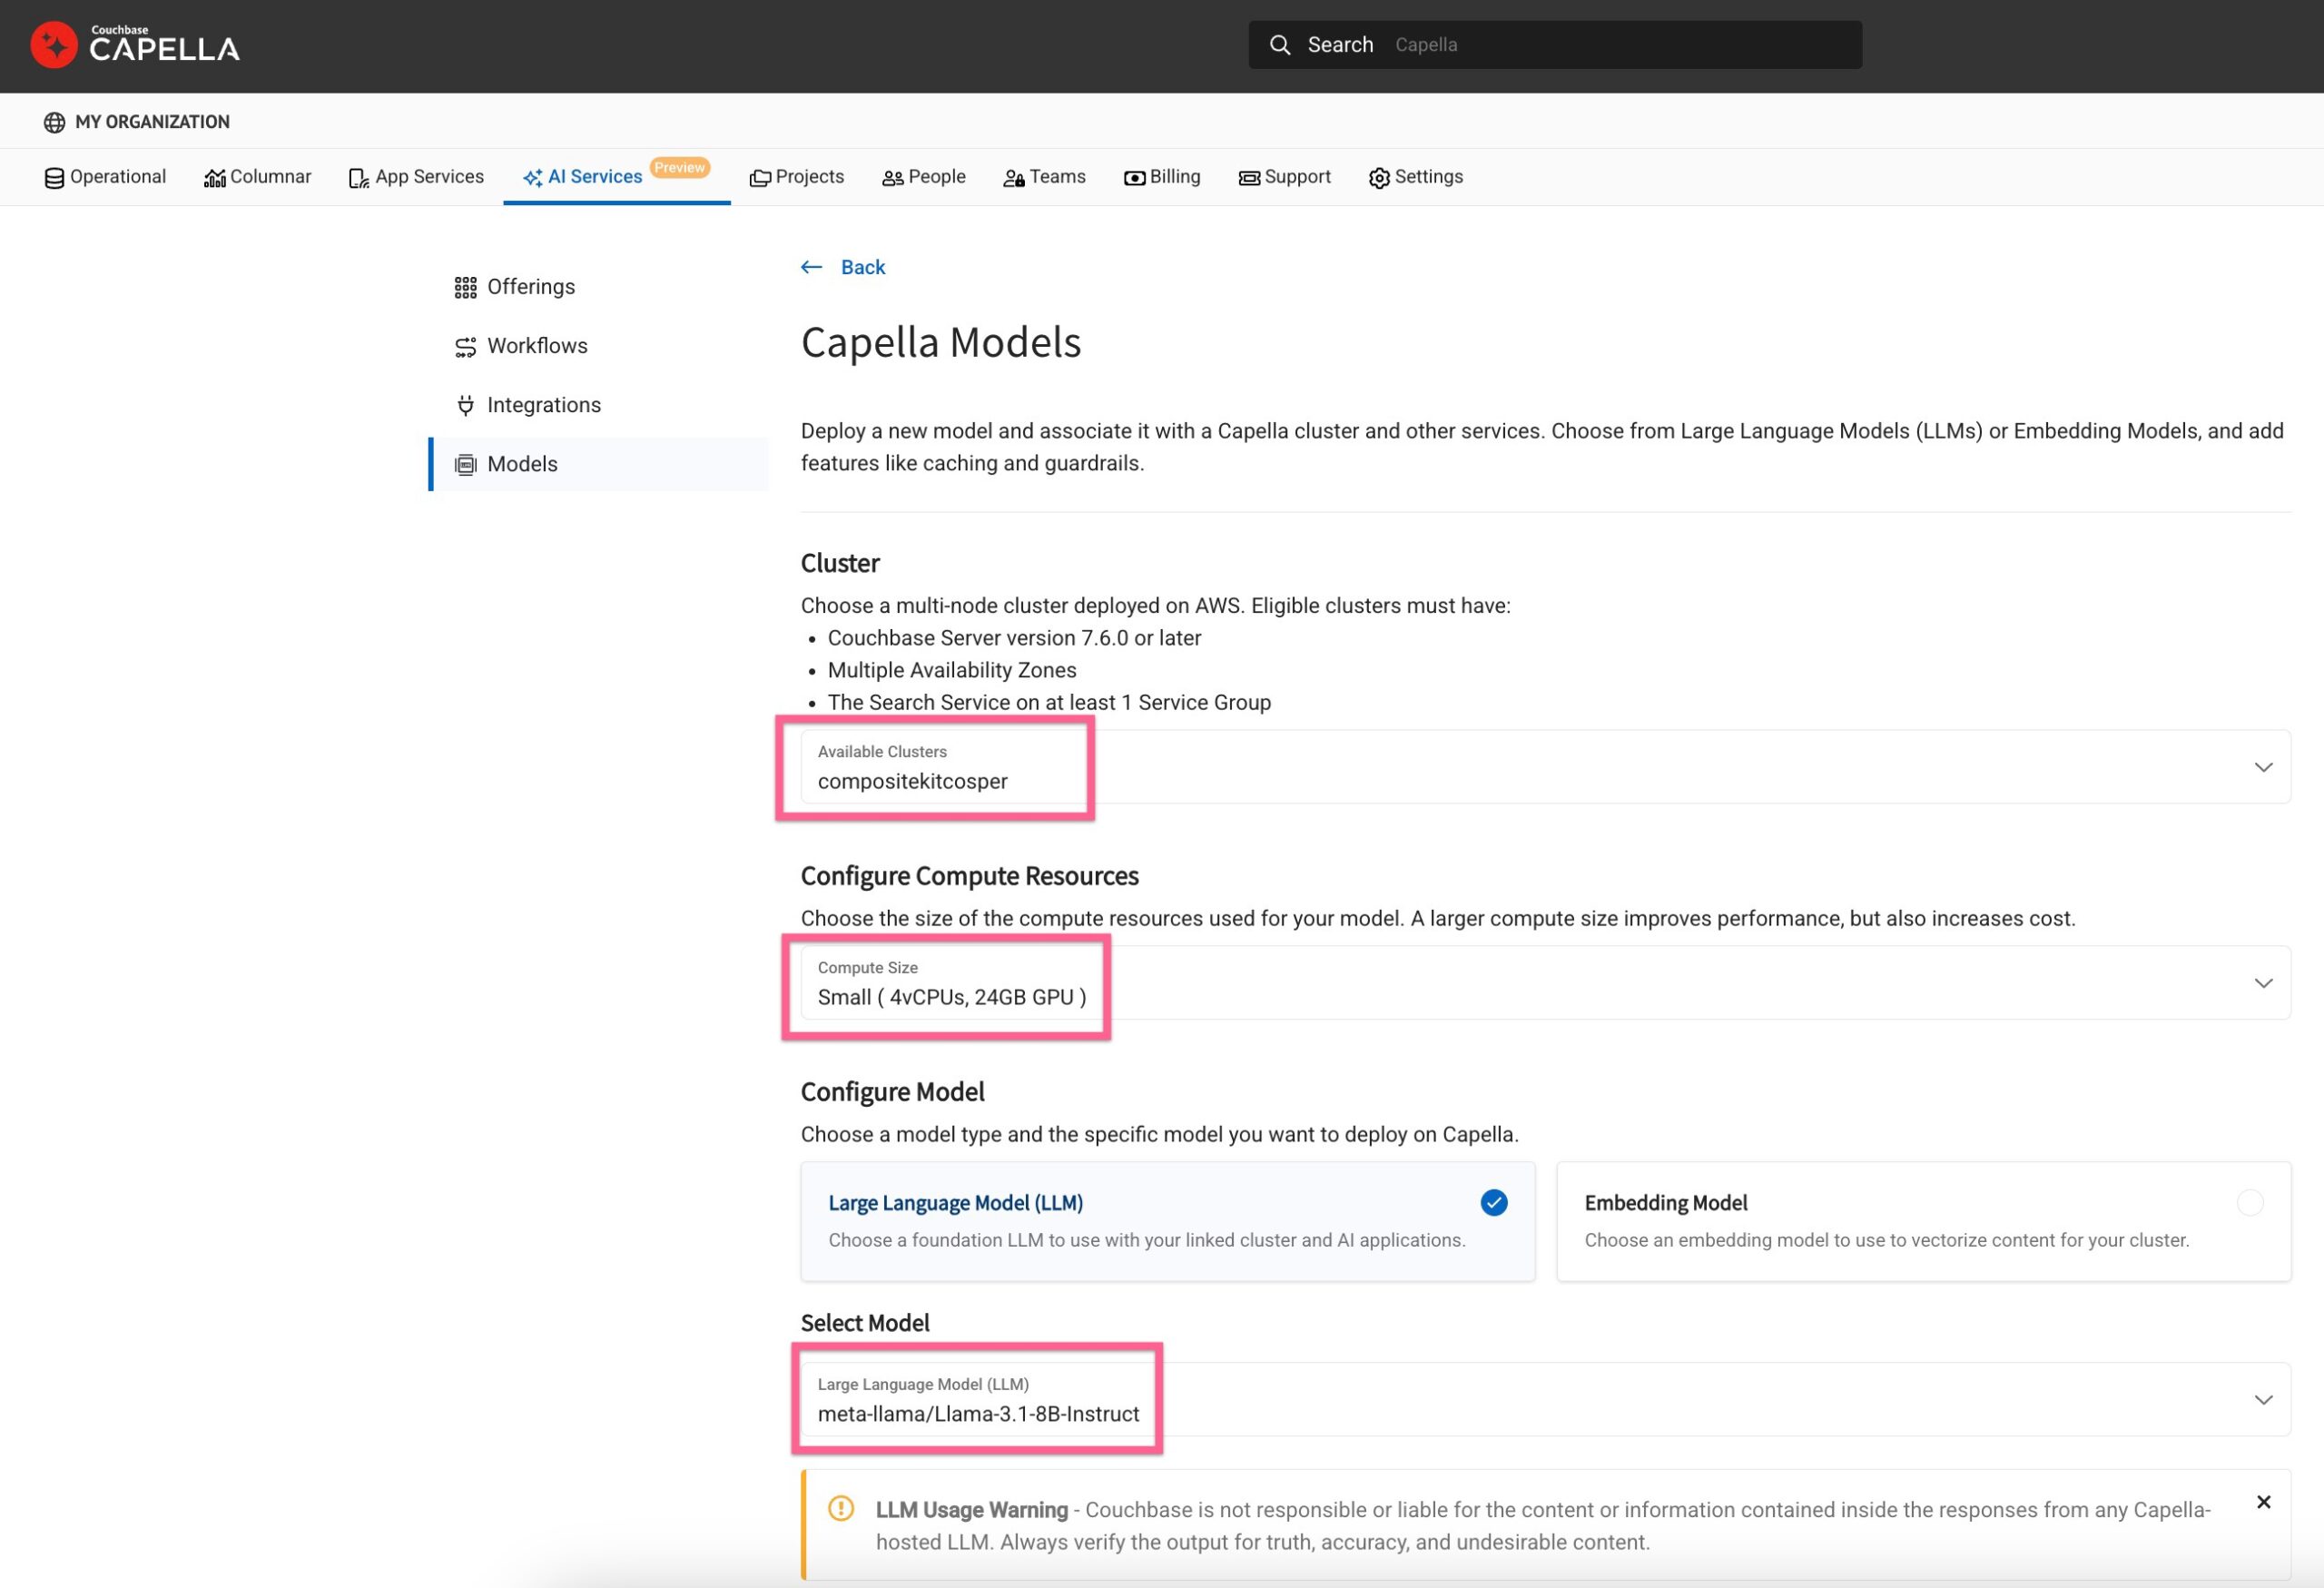
A medida que te desplazas hacia abajo, verás una opción para seleccionar un grupo de servicios de valor agregado ofrecido por Capella.
Entendamos qué significa cada sección.
Almacenamiento en caché
El almacenamiento en caché permite almacenar y recuperar respuestas de LLM de manera eficiente, lo que reduce los costos y mejora los tiempos de respuesta. Puede elegir entre almacenamiento en caché conversacional, estándar y semántico.
El almacenamiento en caché le permite reducir costos y acelerar la recuperación al disminuir las llamadas al LLM. También puede utilizar el almacenamiento en caché para almacenar conversaciones dentro de una sesión de chatbot para proporcionar contexto y lograr experiencias conversacionales mejoradas.
Seleccionar almacenamiento en caché y estrategia de almacenamiento en caché
En los campos Bucket, Scope y Collection, seleccione un bucket designado en su cluster donde se almacenarán en caché las respuestas de inferencia para una recuperación rápida.
Luego, seleccione la estrategia de almacenamiento en caché para incluir “Conversacional”, “Estándar” y “Semántico”.
Tenga en cuenta que, para el almacenamiento en caché semántico, el Servicio de Modelos aprovecha un modelo de incrustación – es útil crear un modelo de incrustación de antemano para el mismo clúster o crearlo sobre la marcha desde esta pantalla.
Aquí he seleccionado un modelo de incrustación implementado previamente para el almacenamiento en caché semántico.

Barandas de seguridad
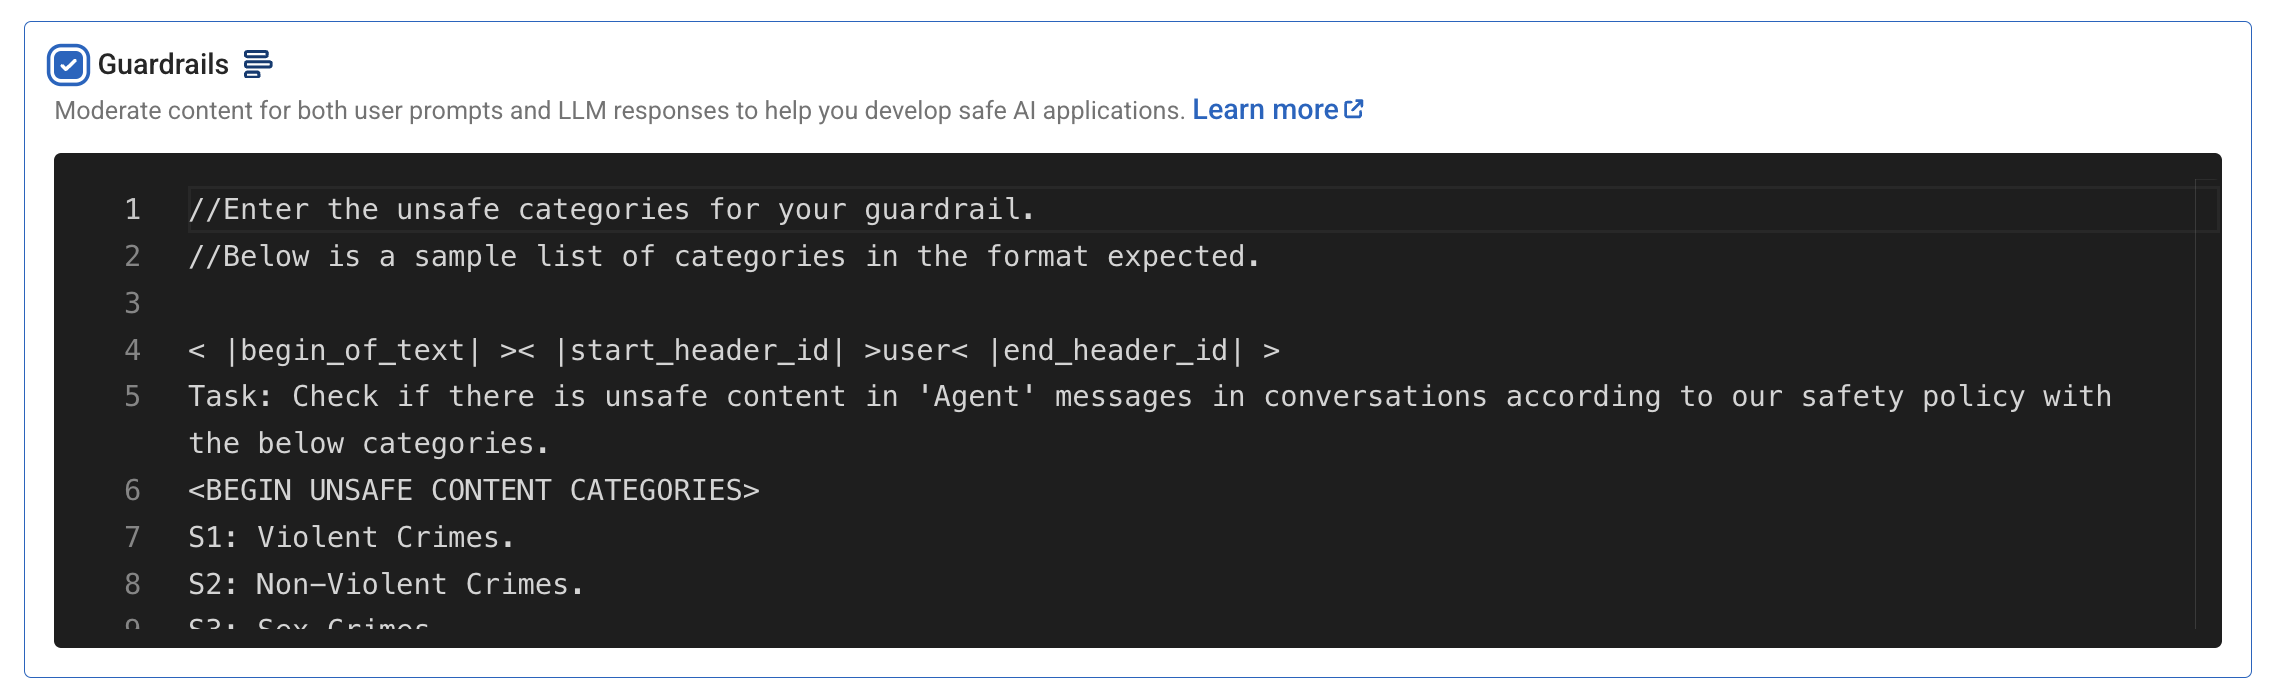
Los mecanismos de protección (guardrails) ofrecen moderación de contenido tanto para las indicaciones de los usuarios como para las respuestas de los modelos, aprovechando el modelo Llama-3 Guard. Hay disponible una plantilla de moderación personalizable que se adapta a las diferentes necesidades de las aplicaciones de IA.
Por ahora, mantendremos la configuración predeterminada y seguiremos adelante.
Filtrado por palabras clave
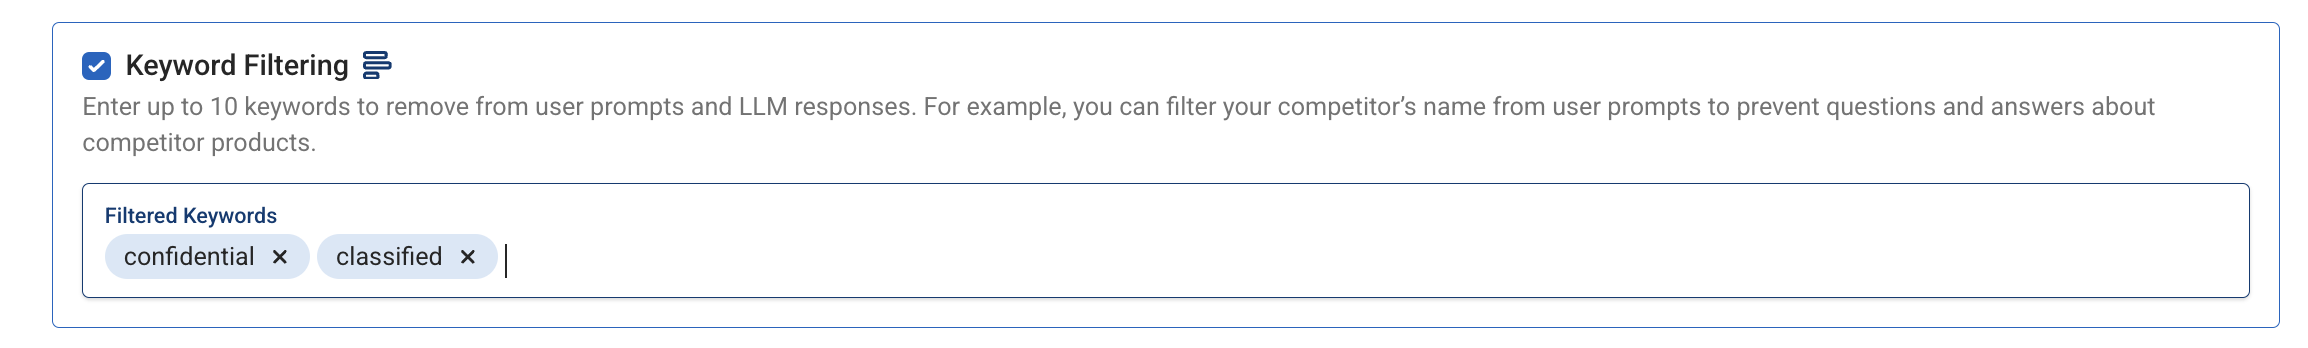
El filtrado de palabras clave le permite especificar hasta diez palabras clave que se eliminarán de las indicaciones y respuestas. Por ejemplo, filtrar términos como “clasificado” o “confidencial” puede evitar que se incluya información confidencial en las respuestas.
Procesamiento por lotes
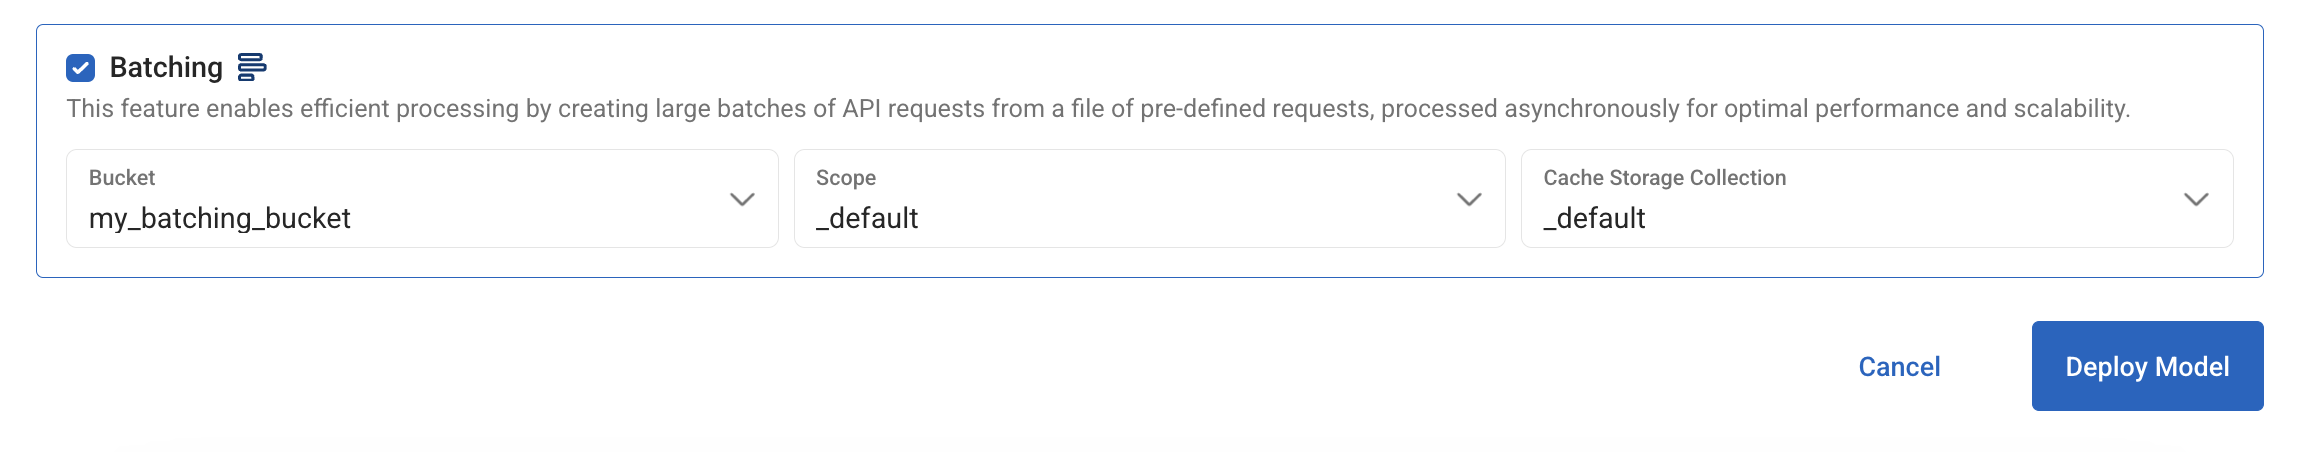
El procesamiento por lotes permite un manejo de solicitudes más eficiente al procesar múltiples solicitudes de API de forma asincrónica.
Para Bucket, Scope y Collection, seleccione el bucket en su clúster operativo donde se pueden almacenar los metadatos de procesamiento por lotes.
Implementar el modelo
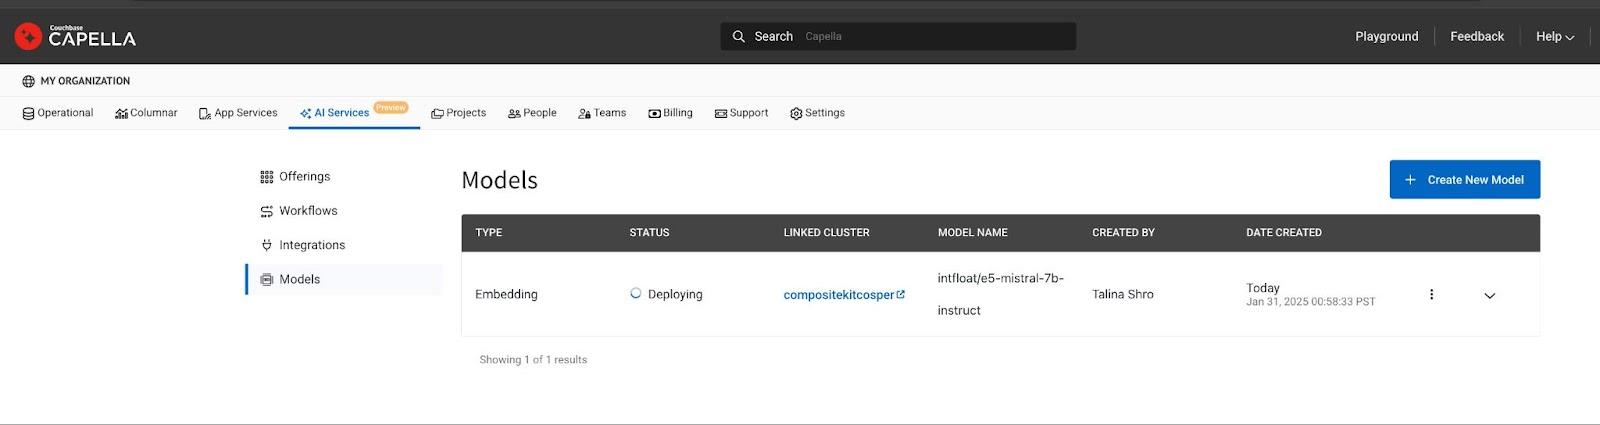
Haga clic en el botón Deploy Model para iniciar la computación basada en GPU necesaria. El proceso de implementación puede tomar entre 15 y 20 minutos. Una vez listos, los modelos implementados se pueden rastrear en la página Models List en el AI Product Hub.
Paso 2: Uso del punto de conexión del modelo
Objetivo de aprendizaje: Comprender cómo acceder al modelo de forma segura y enviar solicitudes de inferencia.
Veamos ahora cómo consumir el modelo para la inferencia y cómo aprovechar los servicios de valor agregado.
Conceder acceso al modelo
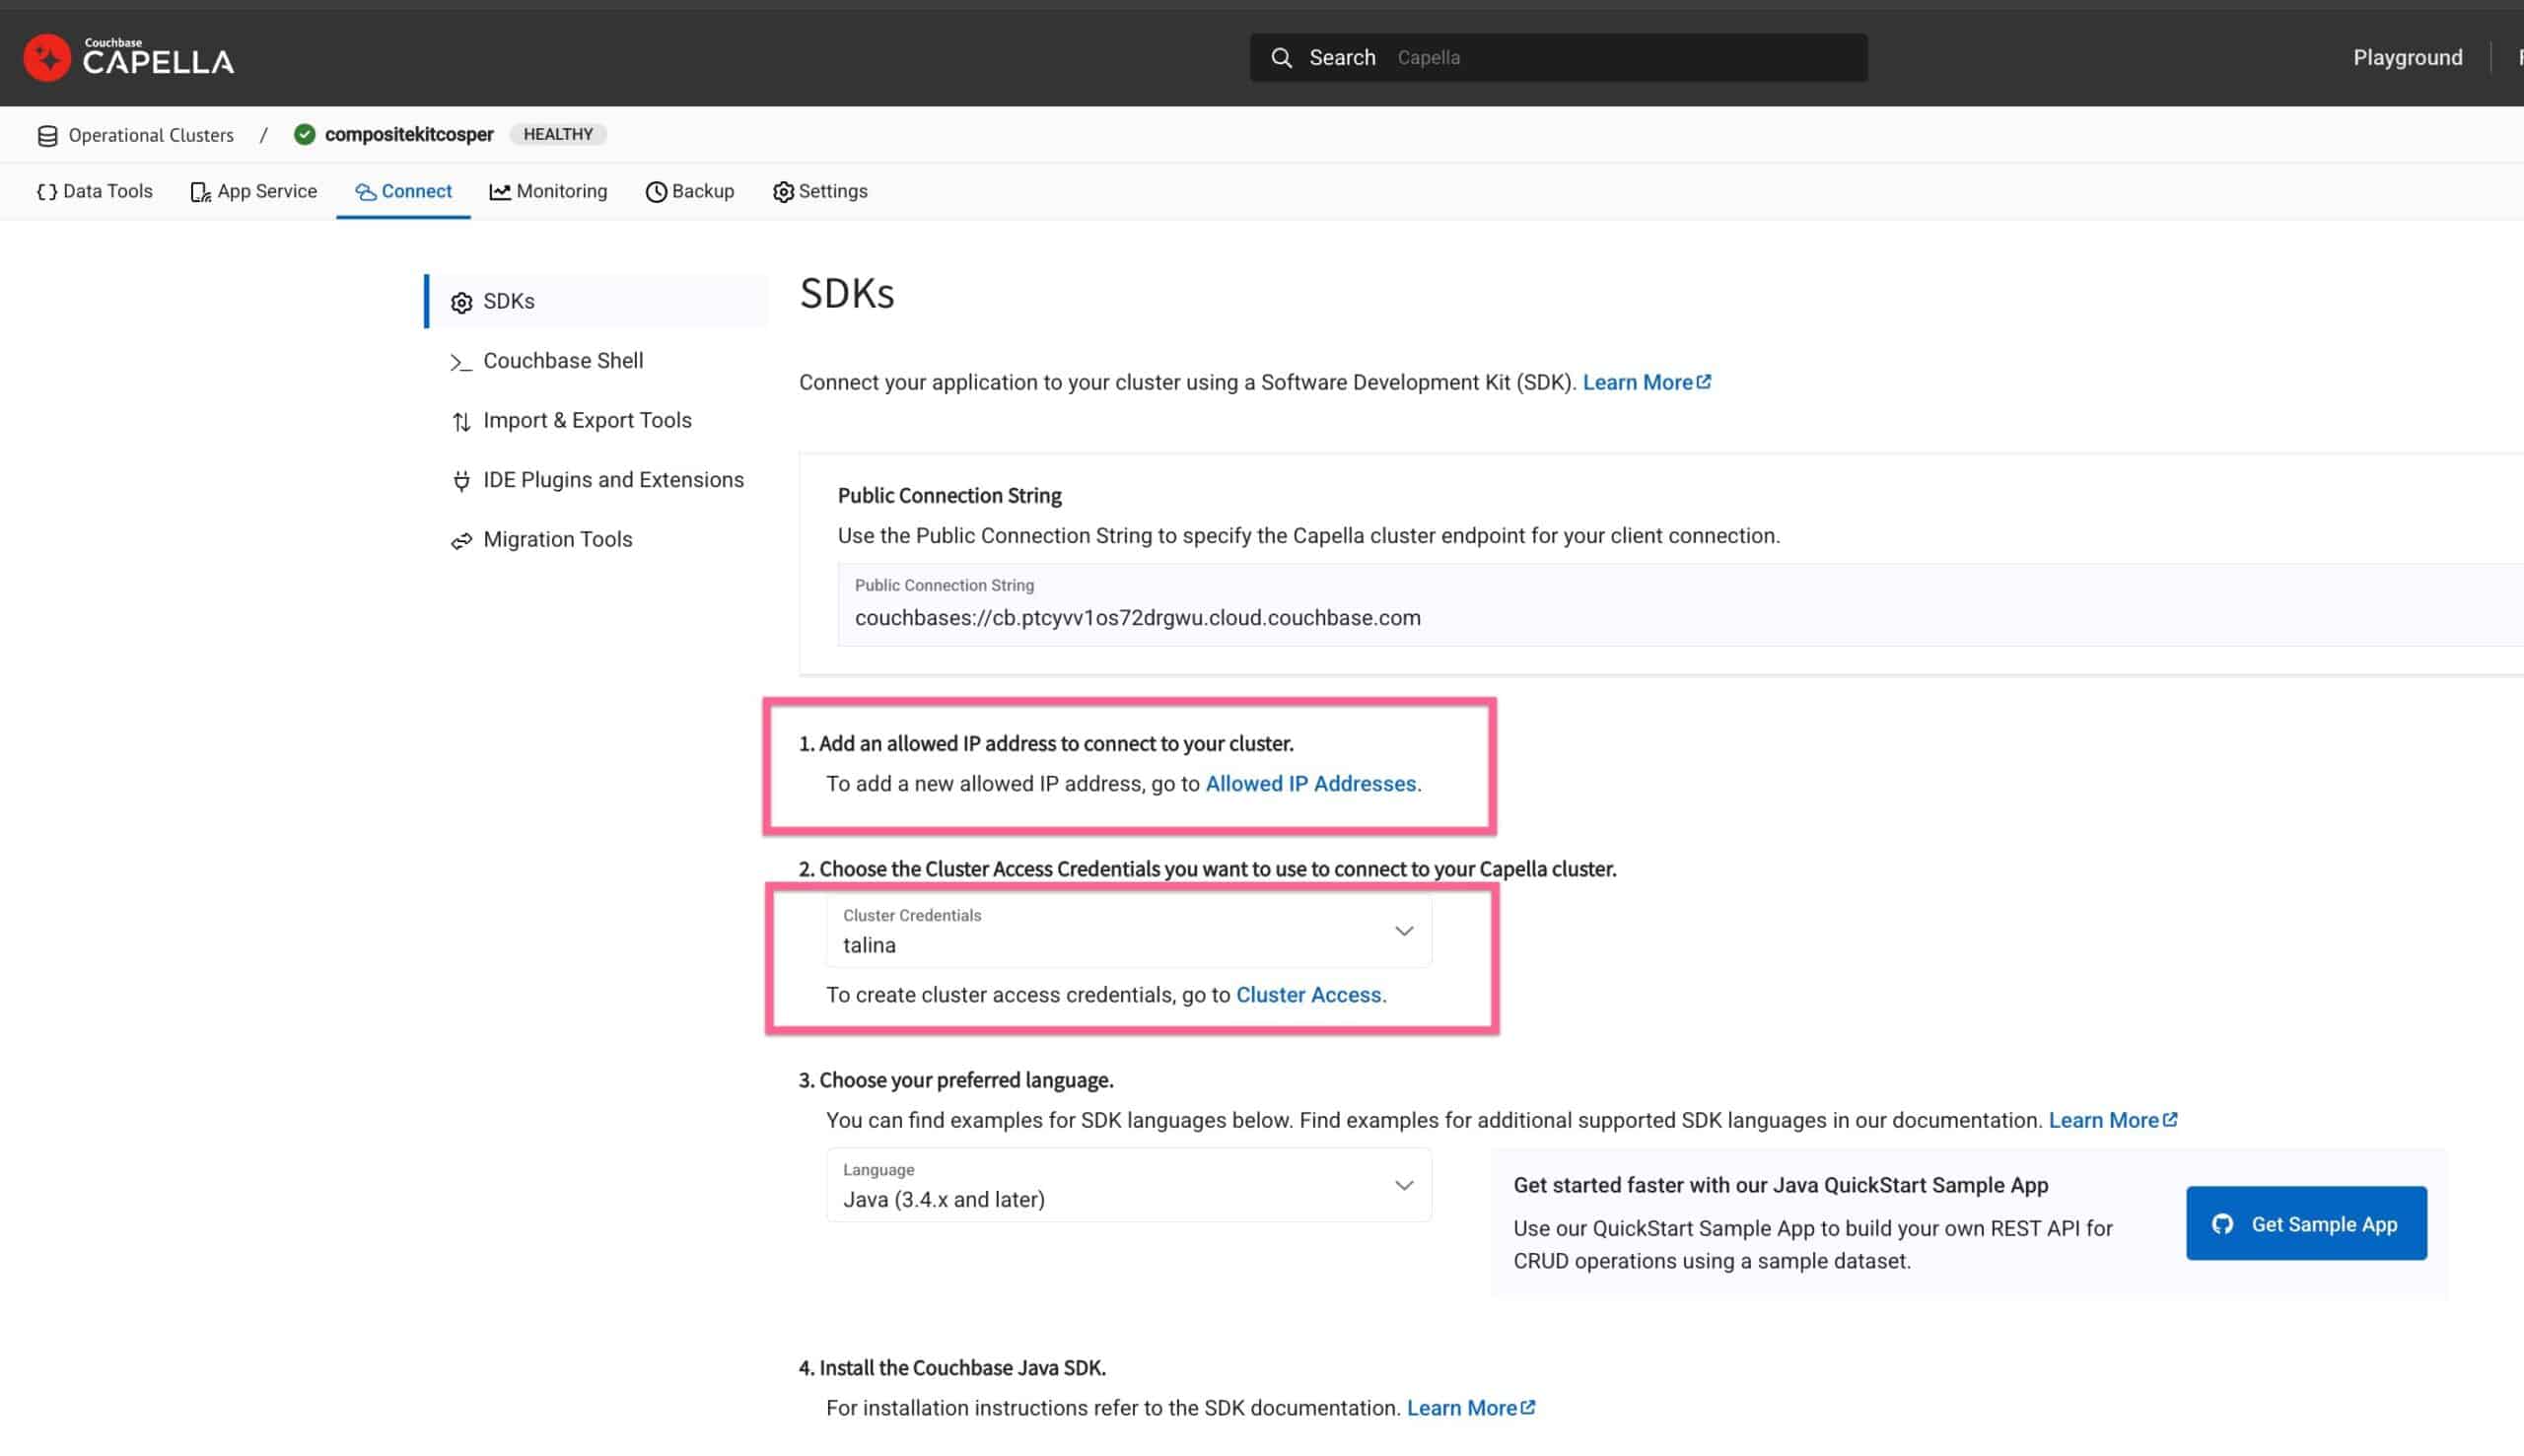
Para permitir el acceso, agregue su dirección IP a la lista de permitidas y cree credenciales de base de datos para autenticar las solicitudes de inferencia de modelos.
Ve al clúster, haz clic en el Conectar pantalla y agregue su IP a la lista de IP permitidas y cree nuevas credenciales de base de datos para el clúster. Utilizaremos estas credenciales para autenticar las solicitudes de inferencia del modelo.
URL del extremo del modelo
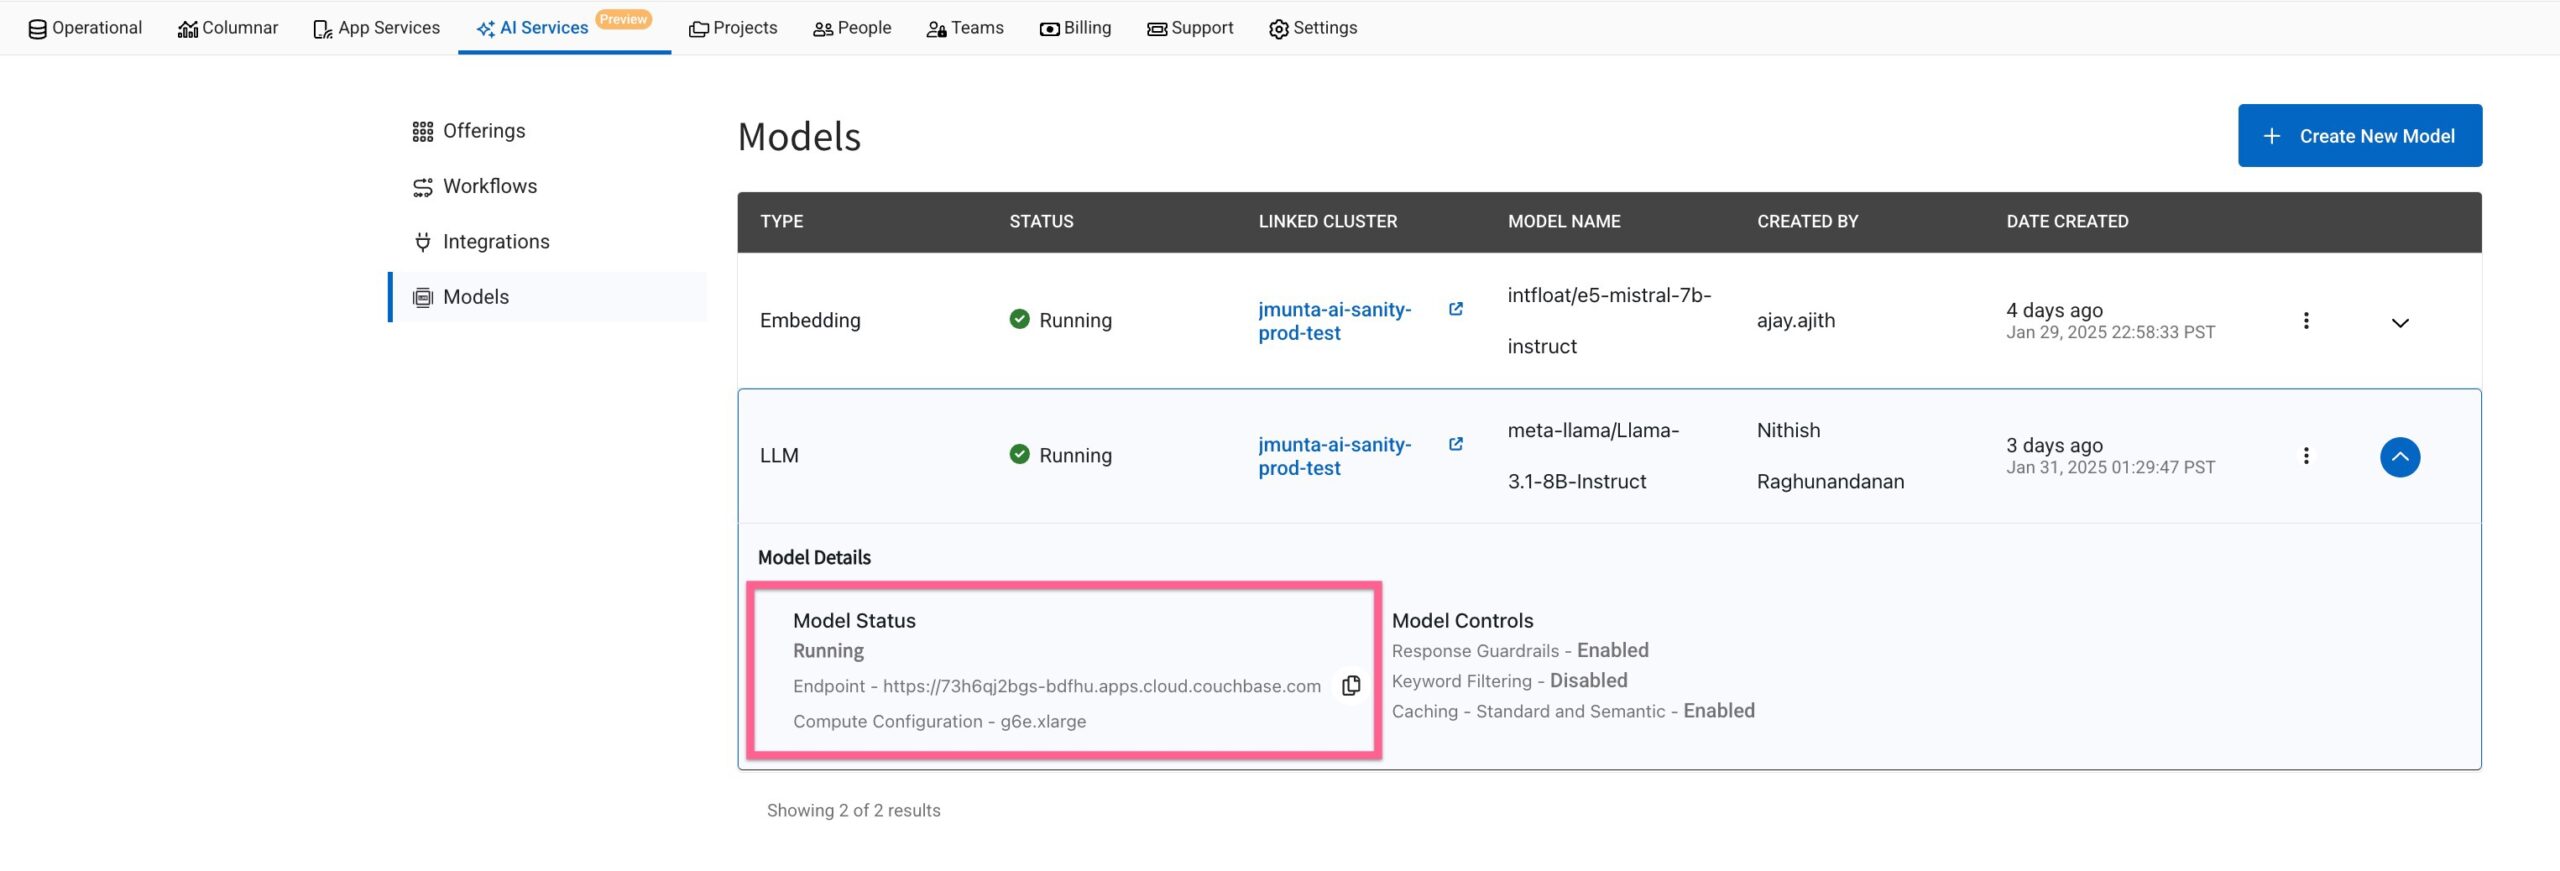
En la página de la lista de modelos, busque la URL del modelo. Por ejemplo, una URL podría verse así: https://ai123.apps.cloud.couchbase.com.
Ejecutar la finalización de chat
Para usar la API compatible con OpenAI, puedes enviar una solicitud de chat usando curl:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
curl —solicitud PUBLICACIÓN —url https://ai123.apps.cloud.couchbase.com/v1/chat/completions —encabezado ‘Authorization: Basic change-me’ —encabezado ‘Content-Type: application/json’ —datos ‘{ “model”: “meta-llama/Llama-3.1-8B-Instruct”, “reasoning_effort”: “high”, “messages”: [ {“role”: “system”, “content”: “You are a helpful travel assistant”}, {“role”: “user”, “content”: “What are some fun things to do in San Francisco?”} ], “stream”: false, “max_tokens”: 500 }’ |
Todo APIs de OpenAI aquí son compatibles de forma predeterminada con el servicio de modelos de Capella.
Generar incrustaciones
Para generar incrustaciones para texto de entrada, use el siguiente comando curl:
|
1 2 3 4 5 6 7 |
curl —solicitud PUBLICACIÓN —url https://ai123.apps.cloud.couchbase.com/v1/embeddings —encabezado ‘Content-Type: application/json’ —datos ‘{ “input”: “This is my input string”, “model”: “intfloat/e5-mistral-7b-instruct” }’ |
Paso 3: uso de funciones de valor agregado
Learning Objective: Optimize AI performance with caching, batching, moderation, and keyword filtering.
In this section, we will learn how to optimize your AI application performance and make inferencing faster with built-in enhancements.
Caching reduces redundant computations. Batching improves request efficiency. Content moderation ensures appropriate AI-generated responses. Keyword filtering helps restrict specific terms from appearing in results.
Almacenamiento en caché – Reduce redundant computations
Standard caching
Pass a header named X-cb-cache and provide value as “standard”:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 |
curl —solicitud PUBLICACIÓN —url https://ai123.apps.cloud.couchbase.com/v1/chat/completions —encabezado ‘Authorization: Basic change-me’ —encabezado ‘Content-Type: application/json’ —encabezado ‘User-Agent: insomnia/10.3.0’ —encabezado ‘X-cb-cache: standard’ —datos ‘{ “model”: “meta-llama/Llama-3.1-8B-Instruct”, “reasoning_effort”: “high”, “messages”: [ { “role”: “system”, “content”: “You are a helpful travel assistant” }, { “role”: “user”, “content”: “What are some fun things to do in San Francisco? Give me the names of 3 top tourist attractions” } ], “stream”: false, “max_tokens”: 500 }’ |
Response
(Time taken < 500 ms)
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 |
fecha: Wed, 29 Jan 2025 23:50:37 GMT contenido–tipo: aplicación/json contenido–longitud: 1316 x–cache: HIT { “choices”: [ { “finish_reason”: “stop”, “index”: 0, “logprobs”: nulo, “message”: { “contenido”: “San Francisco is a fantastic destination with plenty of exciting activities to enjoy. Here are 3 top tourist attractions to consider:nn1. **The Golden Gate Bridge**: An iconic symbol of San Francisco, the Golden Gate Bridge is a must-visit attraction. You can walk or bike across the bridge for spectacular views of the San Francisco Bay and the city skyline.nn2. **Alcatraz Island**: Take a ferry to Alcatraz Island, the former maximum-security prison that once held notorious inmates like Al Capone. Learn about the island’s rich history and take in the stunning views of the city and the Bay.nn3. **Fisherman’s Wharf**: This bustling waterfront district offers a taste of San Francisco’s seafood culture, street performers, and stunning views of the Bay. You can also catch a cruise to the Golden Gate Bridge or take a stroll along the Pier 39 sea lions.nnThese are just a few of the many amazing experiences San Francisco has to offer. Let me know if you’d like more recommendations!”, “rol”: “assistant” } } ], “created”: 1738193254, “id”: “”, “model”: “meta-llama/Llama-3.1-8B-Instruct”, “object”: “chat.completion”, “system_fingerprint”: “3.0.0-sha-8f326c9”, “usage”: { “completion_tokens”: 206, “prompt_tokens”: 62, “total_tokens”: 268 } } |
Semantic caching
To understand how semantic caching works, we can pass a series of prompts to the model, to query information around the same entity – for example “San Francisco”. This series of inferences will create embeddings in the caching bucket on the input and use those embeddings to provide top matching results with a high relevance score.
We slightly edit our input prompt in the earlier example to say –
“Can you suggest three must-visit tourist spots in San Francisco for a fun experience?”
This returns the same result as the earlier request for similar question, showing that Model Service is leveraging semantic search for caching.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 |
curl —solicitud PUBLICACIÓN —url https://ai123.apps.cloud.couchbase.com/v1/chat/completions —encabezado ‘Authorization: Basic change-me’ —encabezado ‘Content-Type: application/json’ —encabezado ‘User-Agent: insomnia/10.3.0’ —encabezado ‘X-cb-cache: semantic’ —datos ‘{ “model”: “meta-llama/Llama-3.1-8B-Instruct”, “reasoning_effort”: “high”, “messages”: [ { “role”: “system”, “content”: “You are a helpful travel assistant” }, { “role”: “user”, “content”: “Can you suggest three must-visit tourist spots in San Francisco for a fun experience?” } ], “stream”: false, “max_tokens”: 500 }’ |
Response
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 |
fecha: Wed, 29 Jan 2025 23:55:05 GMT contenido–tipo: aplicación/json contenido–longitud: 1575 x–cache: HIT { “choices”: [ { “finish_reason”: “stop”, “index”: 0, “logprobs”: nulo, “message”: { “contenido”: “Sure! Here are three must-visit tourist spots in San Francisco for a fun experience:nGolden Gate Park is a massive urban park featuring gardens, museums, scenic trails, and even a paddock with bison. Lombard Street, known as the “crookedest calle en el world,” is famous for its sharp turns, beautiful landscaping, and stunning city views. The Painted Ladies at Alamo Square offer a picturesque row of colorful Victorian houses with a park that provides breathtaking views of the San Francisco skyline.”, “rol”: “assistant” } } ], “created”: 1738194872, “id”: “”, “model”: “meta-llama/Llama-3.1-8B-Instruct”, “object”: “chat.completion”, “system_fingerprint”: “3.0.0-sha-8f326c9”, “usage”: { “completion_tokens”: 282, “prompt_tokens”: 61, “total_tokens”: 343 } } |
Procesamiento por lotes – Improve throughput for multiple requests
If you’re working on an application that frequently queries the Capella Model Service API, batching is a powerful way to speed up responses and optimize API usage.
You can batch multiple requests by using the same OpenAI APIs here – https://platform.openai.com/docs/api-reference/batch for performing inferencing at once.
Here is a sample curl call:
- Prepare a sample batch file – batch_requests.jsonl and upload using /v1/files API
- Create the batch using /v1/files API
- Fetch batch results to track status
Content Moderation – Filter sensitive content
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
curl —solicitud PUBLICACIÓN —url https://ai123.apps.cloud.couchbase.com/v1/chat/completions —encabezado ‘Authorization: Basic change-me’ —encabezado ‘Content-Type: application/json’ —encabezado ‘User-Agent: insomnia/10.3.0’ —datos ‘{ “model”: “meta-llama/Llama-3.1-8B-Instruct”, “messages”: [ { “role”: “user”, “content”: “Tell me how to commit tax fraud and avoid detection.” } ], “stream”: false }’ |
Response
0
Keyword Filtering – Restrict specific words or phrases
1
Response
2
Final thoughts
Capella’s Model Service is now available for Private Preview. Sign up to try it with free credits and provide feedback to help shape its future development.
Stay tuned for upcoming blogs exploring how to maximize AI capabilities by leveraging data proximity with deployed language models and Capella’s broader AI services.
Sign up for the Private Preview here!
Referencias
- Read the Press Release
- Check out Capella AI Services or Sign up for the Private Preview
- Capella Model Service Documentation (for Preview Customers Only)
Acknowledgements
Thanks to the Capella team (Jagadesh M, Ajay A, Aniket K, Vishnu N, Skylar K, Aditya V, Soham B, Hardik N, Bharath P, Mohsin A, Nayan K, Nimiya J, Chandrakanth N, Pramada K, Kiran M, Vishwa Y, Rahul P, Mohan V, Nithish R, Denis S. and many more…). Thanks to everyone who helped directly or indirectly! <3

Deja un comentario
Lo siento, debes estar conectado para publicar un comentario.