
Couchbase 또는 Capella와 함께 작업하는 개발자라면, 아래 내용을 알고 싶으실 겁니다. 카펠라 데이터스튜디오. 관리하기 위한 매끄럽고 한 눈에 보이는 UI를 갖춘 무료 커뮤니티 지원 도구입니다. 카펠라 운영 중, 카펠라 주상절리, 그리고 Couchbase 서버 클러스터. 이는 개발자의 생산성을 높일 뿐만 아니라 사용자의 경험을 훨씬 더 원활하고 멋진 방식으로 만들어줍니다.
이제 새로운 기능이 추가되었습니다: 합성 데이터 생성기.
Capella DataStudio의 합성 데이터 생성기 이 기능은 개발자들이 프로젝트에 현실감 있고 의미 있는 데이터를 손쉽게 생성할 수 있도록 지원하는 것입니다. 애플리케이션 테스트, 기계 학습 모델 교육, 대규모 시스템 시뮬레이션 등 어떤 작업이든 이 기능은 탁월한 유연성과 성능을 제공합니다.
합성 데이터란 무엇인가?
합성 데이터는 단순히 “가짜” 데이터가 아닙니다. 합성 데이터는 실제 데이터의 속성, 분포 및 관계를 모방하도록 설계되었습니다. 가짜 데이터는 맥락 없이 무작위 값을 생성할 수 있지만, 합성 데이터는 다음과 같은 목적을 지닙니다.
- 영역 간의 논리적 관계 유지(예: 도시와 주가 일치)
- 실제적인 분포를 따르세요. 예를 들어 일반 분포 또는 가중 분포에 부합하는 값을 생성하세요.
- 시험, 분석 및 시뮬레이션에 통계적으로 유용한 데이터가 되도록 함
- 이는 실제 데이터가 불가능하거나 민감하거나 부족한 상황에서 합성 데이터를 매우 유용하게 사용할 수 있게 해줍니다.
자세히 살펴보거나 합성 데이터 생성에 대해 알아보기 위해 계속 읽거나, 이 동영상을 시청해 보세요.
Capella DataStudio의 합성 데이터 생성기의 주요 기능
실제적이고 관련성이 있는 데이터
우리의 생성기는 데이터 관계가 의미 있는 것을 보장합니다. 예를 들어 주소에는 도시, 주, 우편번호, 위도 및 경도 값이 일치하는 값이 포함됩니다. 이름과 인구 통계학적 데이터는 논리적으로 일관적입니다.
내장된 서체, 완전하게 구성 가능
데이터 생성에 박차를 가기 위해 다양한 기본 문자 체계를 선택할 수 있습니다. 각 문자 체계는 이름, 위치, 날짜 또는 숫자 필드와 같은 특정 요구에 맞게 사용자 지정할 수 있습니다.
확장 가능: 자신만의 서체 가져오기
자체 데이터 세트 또는 특정 요구 사항이 있으신가요? 맞춤형 서체를 가져오셔서 생성기의 기능을 확장하고 고유한 사용 사례에 맞는 맞춤형 데이터를 만들 수 있습니다.
주요 키/외국 키 관계s
필드 간의 관계를 정의하여 복잡한 데이터 세트를 쉽게 모델링할 수 있습니다. 이중 키는 기본 키 데이터에 참조할 수 있어 현실적인 관계형 데이터 구조를 구현할 수 있습니다.
강력한 함수를 통한 표현식 처리
내장 함수를 활용하여 단 한 줄의 코드를 작성하지 않고도 복잡한 표현식을 생성할 수 있습니다. 필드를 조합하고 동적으로 조작하여 데이터에 대한 완전한 제어를 실현하십시오.
데이터 크기에 대한 제한 없음
작은 테스트용으로 몇 줄의 데이터부터 대규모 시뮬레이션용으로 수백만 개의 문서까지, 어떤 규모의 데이터도 생성할 수 있습니다. 생성할 수 있는 항목의 제한은 없습니다.
캡펠라 운영 시스템과 쿠버베이스 서버 간의 완벽하게 연동
합성 데이터를 Capella Operational 또는 Couchbase Server에 직접 가져오면 더욱 향상된 결과를 얻을 수 있습니다. 이를 통해 생성부터 배포까지의 프로세스가 간소화됩니다.
합성 데이터 생성에 Capella DataStudio를 선택하는 이유는 무엇인가요?
Intuitive UI와 강력한 기능 세트로 Capella DataStudio의 Synthetic Data Generator는 고품질이고 의미 있는 데이터 세트를 생성하는 최적의 도구입니다. 개발자, 데이터 과학자 또는 테스터이든, 이 기능은 시간 절약과 복잡성 감소, 그리고 현실적인 데이터로 프로젝트를 향상시킬 것입니다. 끝없는 가능성을 탐험하고 데이터 생성 경험을 새롭게 정의하세요.
합성 데이터 생성
합성 데이터 생성기가 어떻게 작동하는지 살펴보겠습니다.
스키마 빌더
스키마는 필드별로 하나씩 하나씩 구축됩니다. 각 행에는 최소 두 개의 속성이 있습니다:
- 영역 이름
- 필드의 데이터 형식 – t그의 능력은 그것으로부터 비롯될 수 있다. 핵심 또는 사용자 타이프셋팅
데이터 유형에 따라 더 많은 속성이 노출될 수 있습니다:
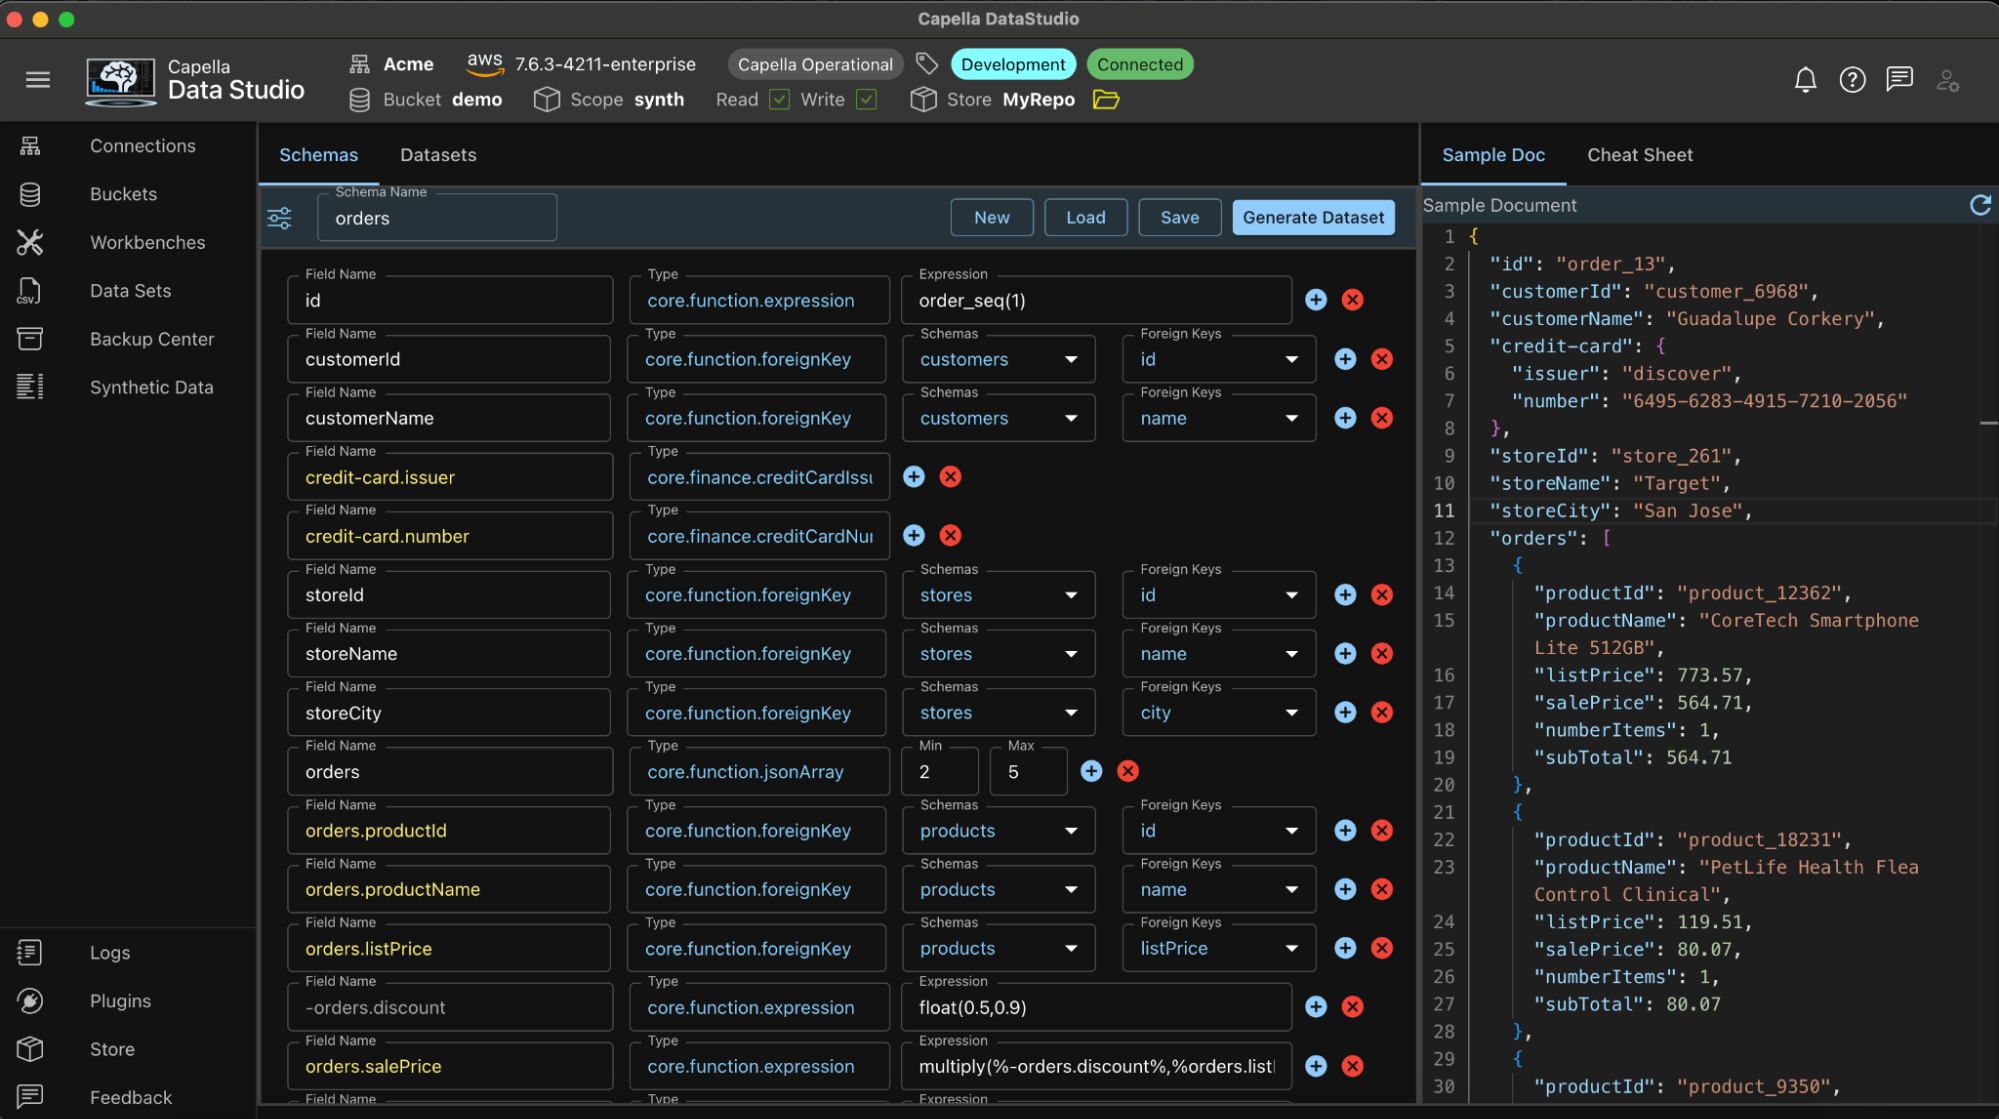
영역 이름
- 필드 이름은 JSON 규격에 부합하는 모든 필드 이름이 될 수 있습니다.
- 중첩된 JSON 객체는 점줄기 형식으로 지정됩니다.
- 깊이 중첩된 JSON 지원
- 두 줄 구분 기호 앞글자를 가진 필드 이름은 기본 키로 처리됩니다.
- 데이터 세트를 생성할 때 이러한 키들도 내보내져 저장됩니다. localStore/SyntheticData/DataSets/SchemaName.pk 파일
- 주 키는 루트 문서의 필드에서만 지정할 수 있습니다.
- JSON 객체, 중첩된 필드 및 숨겨진 필드는 기본 키가 될 수 없습니다.
- 단일 화살표 앞글자가 있는 필드 이름은 숨겨진 필드로 처리됩니다.
- 숨겨진 필드는 필드 참조에 사용되는 임시 저장소로 사용됩니다.
- 숨겨진 필드는 기본 키가 될 수 없습니다.
- 숨겨진 필드는 JSON 문서에 나타나지 않습니다.
- JSON 객체는 숨길 수 없습니다.
- 중첩된 필드는 숨길 수 있습니다.
데이터 유형
데이터 형식을 대화 상자에서 선택합니다:

핵심 서체
Capella DataStudio에서 제공합니다:

사용자가 타이핑합니다.
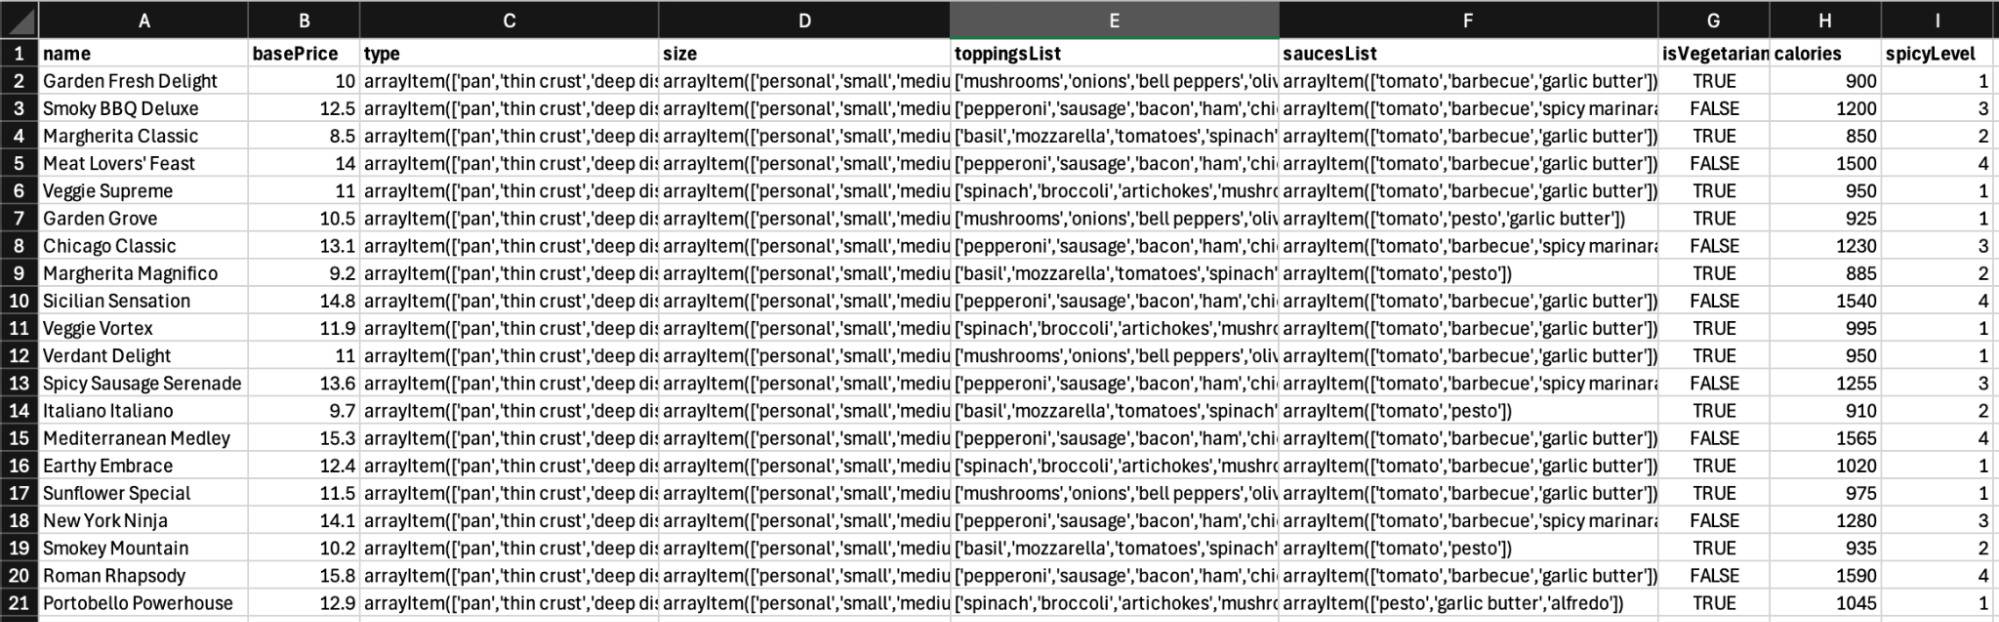
데이터 생성기의 기능을 확장하기 위해 귀하가 제공합니다. 두 개의 파일을 제공해야 합니다:
- 데이터가 포함된 CSV 파일
- TypeSet를 설명하는 매니페스트 파일
사용자 서체 설정 프로세스
사용자 입력 텍스트로 문서를 생성하면 다음이 발생합니다.
- 파일에서 임의의 행이 읽어집니다.
- 행은 행 캐시에 캐시됩니다.
- 그 다음 필드는 이 행 캐시에서 읽어집니다.
- 어떤 필드가 읽힌 후에는 해당 필드가 행 캐시에서 삭제됩니다.
- 필드가 null이면 전체 행 캐시가 무효화되고 새로운 임의 행이 읽어집니다.
- 필드는 행 캐시에서 읽어오며, 주어진 문서에 대한 데이터는 상호 연관됩니다.
- 각 문서의 시작은 새 행 캐시로 시작됩니다.
핵심 기능
특별 데이터 형식은 세 가지가 있습니다:
- 표현
- 외국키
- jsonArray
1. core.function.expression
표현은 스키마를 맞춤설정하는 강력한 방법입니다:
- 문법 표현들은 단지 문자열일 뿐입니다.
- 그들은 내장될 수 있습니다. 참고자료 (포함된) %%) 그리고 함수
문서 및 표현 아키텍처
문서가 어떻게 만들어지는지 봅시다:
- 이 문서의 구조는 위에서 아래로, 줄을 따라 만들어진다.
- 우리는 항상 모든 행 단계마다 부분 문서가 있습니다.
- 먼저, 이 표현은 문자열입니다.
- 그것은 이렇게 된다. 표현 평가기
- 부분 문서에는 필드와 값들이 포함되어 평가자에게 제공됩니다.
- 이는 이전 필드와 그에 따른 평가된 값이 이제 사용할 수 있음을 의미합니다.
- 부분 문서에는 필드와 값들이 포함되어 평가자에게 제공됩니다.
- 그 문자열은 다음으로 검사됩니다. 참고자료
- 참조는 이전 사용되었던 필드 이름과 해당 값들로 구성된 부분 문서에서 가져온 것입니다.
- 참조는 값으로 대체됩니다.
- 이는 참조가 내부에도 있을 수 있음을 의미합니다. 함수
- 그 문자열은 다음으로 검사됩니다. 함수
- 그런 다음 함수가 실행되고 그 값들은 부분 문서에서 대체됩니다.
- 평가자는 결국 출력값을 반환합니다.
2. core.function.foreignKey
외국 키와 데이터 연관성
관계형 데이터를 작업할 때 외래 키를 통해 참조 완전성을 유지하는 것이 매우 중요합니다. 여기서는 합성 데이터 생성기가 외래 키 관계를 어떻게 처리하는지 설명합니다.
외래 키의 작동 방식
먼저 기본 데이터 세트를 생성해야 합니다. 예를 들어 다음의 스키마가 있습니다. 부서 이는 부서 ID와 이름이 포함된 CSV 파일을 생성합니다. 이러한 부서 ID는 부서 데이터셋의 기본 키 역할을 합니다.
다른 스키마를 만들 때, 예를 들어 직원, 이러한 기존 기본 키를 참조하는 필드를 지정할 수 있습니다. 스키마 빌더는 두 개의 드롭다운 메뉴를 제공합니다:
- 소스 데이터 세트를 선택하는 드롭다운 메뉴(예: “부서”)
- 참조할 기본 키 필드를 선택하는 드롭다운 메뉴(예: “id”)
데이터 생성 프로세스
외래 키 참조를 사용하여 데이터를 생성할 때 시스템은:
- 소스 데이터 세트에서 일괄적으로 행을 선택합니다.
- 그 행에서 기본 키 값을 읽습니다.
- 생성 중인 새 데이터 세트에서 이러한 값을 사용합니다.
데이터 상관성 유지
중요한 기능 중 하나는 여러 개의 외래 키 참조를 어떻게 처리하는지에 있습니다. 스키마에 동일한 소스 데이터 세트의 여러 열이 참조되어 있는 경우, 논리적 상관 관계를 유지하기 위해 값들은 동일한 행에서 가져옵니다.
예를 들어, Employee 스키마가 Departments 데이터셋에서 both department_id 및 department_location을 참조하는 경우, 두 값 모두 동일한 department 레코드에서 가져옵니다. 이를 통해 합성 데이터가 관련 필드 간의 사실적인 관계를 유지할 수 있습니다.
이러한 접근 방식은 실제 데이터에 존재하는 참조 무결성과 논리적 관계를 유지함으로써 보다 현실적인 합성 데이터 세트를 생성하는 데 도움이 됩니다.
3. core.function.jsonArray
JSON 배열 구성
JSON 배열 필드를 구성할 때 다음을 지정할 수 있습니다.
- 매트릭스 안의 개체 최소 수
- 매개변수 배열의 최대 개수
그 후 생성기는 지정된 범위 내의 개체 수에 따라 임의의 배열을 생성합니다.
구조와 한계
JSON 배열은 다음의 규칙을 따릅니다:
- 각 배열에는 단순하고 평면한 JSON 객체가 들어 있습니다.
- 매트릭스 결합 기능은 지원되지 않습니다(매트릭스 내에는 매트릭스가 없습니다)
- 매 배열 요소는 동일한 구조를 따릅니다.
데이터 생성
스키마가 만족스러운 상태로 작성되면 데이터 생성의 시간입니다.
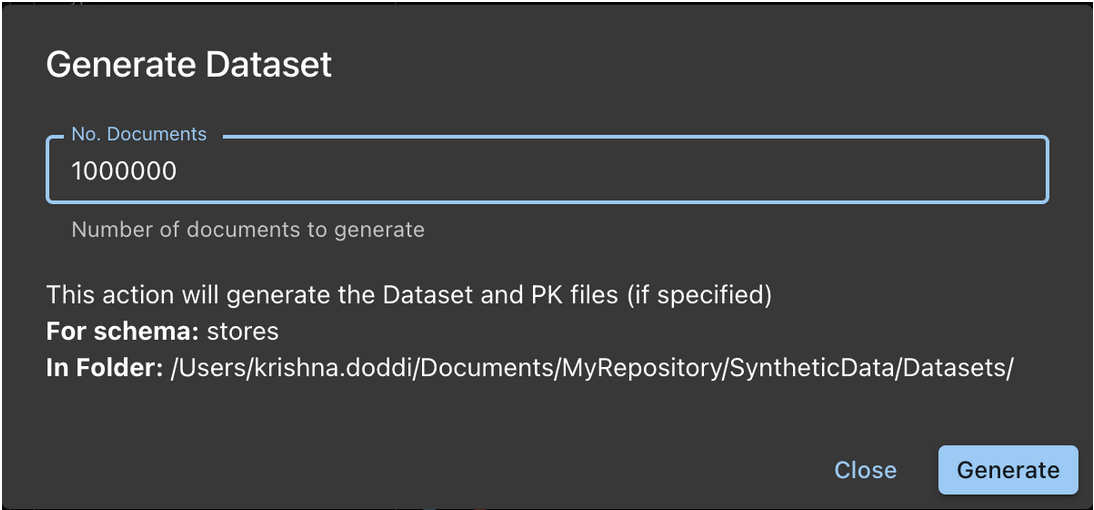
- 데이터 세트는 생성되고 기록됩니다. LocalStore/SyntheticData/DataSets/
- 데이터 세트 파일 이름은 schemaName.json
- 이것은 JSON 라인 파일
- 문서에 기본 키로 표시된 필드가 있는 경우(두 줄 구분 기호로 시작), schemaName.pk 또한 생산됩니다.
- .pk 파일은 CSV 파일입니다.
- 어떤 필드가 seq() function의 경우, 시퀀스는 1씩 증가됩니다.
- 문서의 수에는 제한이 없습니다.
예시 데이터 세트
customer.json
|
1 2 3 4 5 6 7 8 9 |
[ {“id”:“customer_1”,“이름”:“루라 쿠히치”,“성별”:“드림맨”,“나이”:65,“이메일”:“Electa29@yahoo.com”,“주소”:{“거리”:“46938 폰루덴 빌리지 스위트 474”,“도시”:“로스앤젤레스”,“state”:“캘리포니아”,“zip”:“90001”,“geo”:{“위도”:33.7423,“위도”:–117.4412}},“폰들”:{“집”:“(310) 788-5382”,“셀”:“(310) 923-5319”}}, {“id”:“customer_2”,“이름”:“첼시 와일드어맨”,“성별”:“트랜스젠더 여성”,“나이”:58,“이메일”:“Augusta_Mann27@yahoo.com”,“주소”:{“거리”:“8409 제시 밀 아파트 289호”,“도시”:“사크라멘토”,“state”:“캘리포니아”,“zip”:“95814”,“geo”:{“위도”:38.8607,“위도”:–121.0356}},“폰들”:{“집”:“(916) 879-6009”,“셀”:“(916) 503-2269”}}, … ] |
customer.pk
|
1 2 3 4 |
아이디,이름 “customer_1”,“루라 쿠히치” “customer_2”,“첼시 와일드어맨” … |
데이터 세트 미리보기
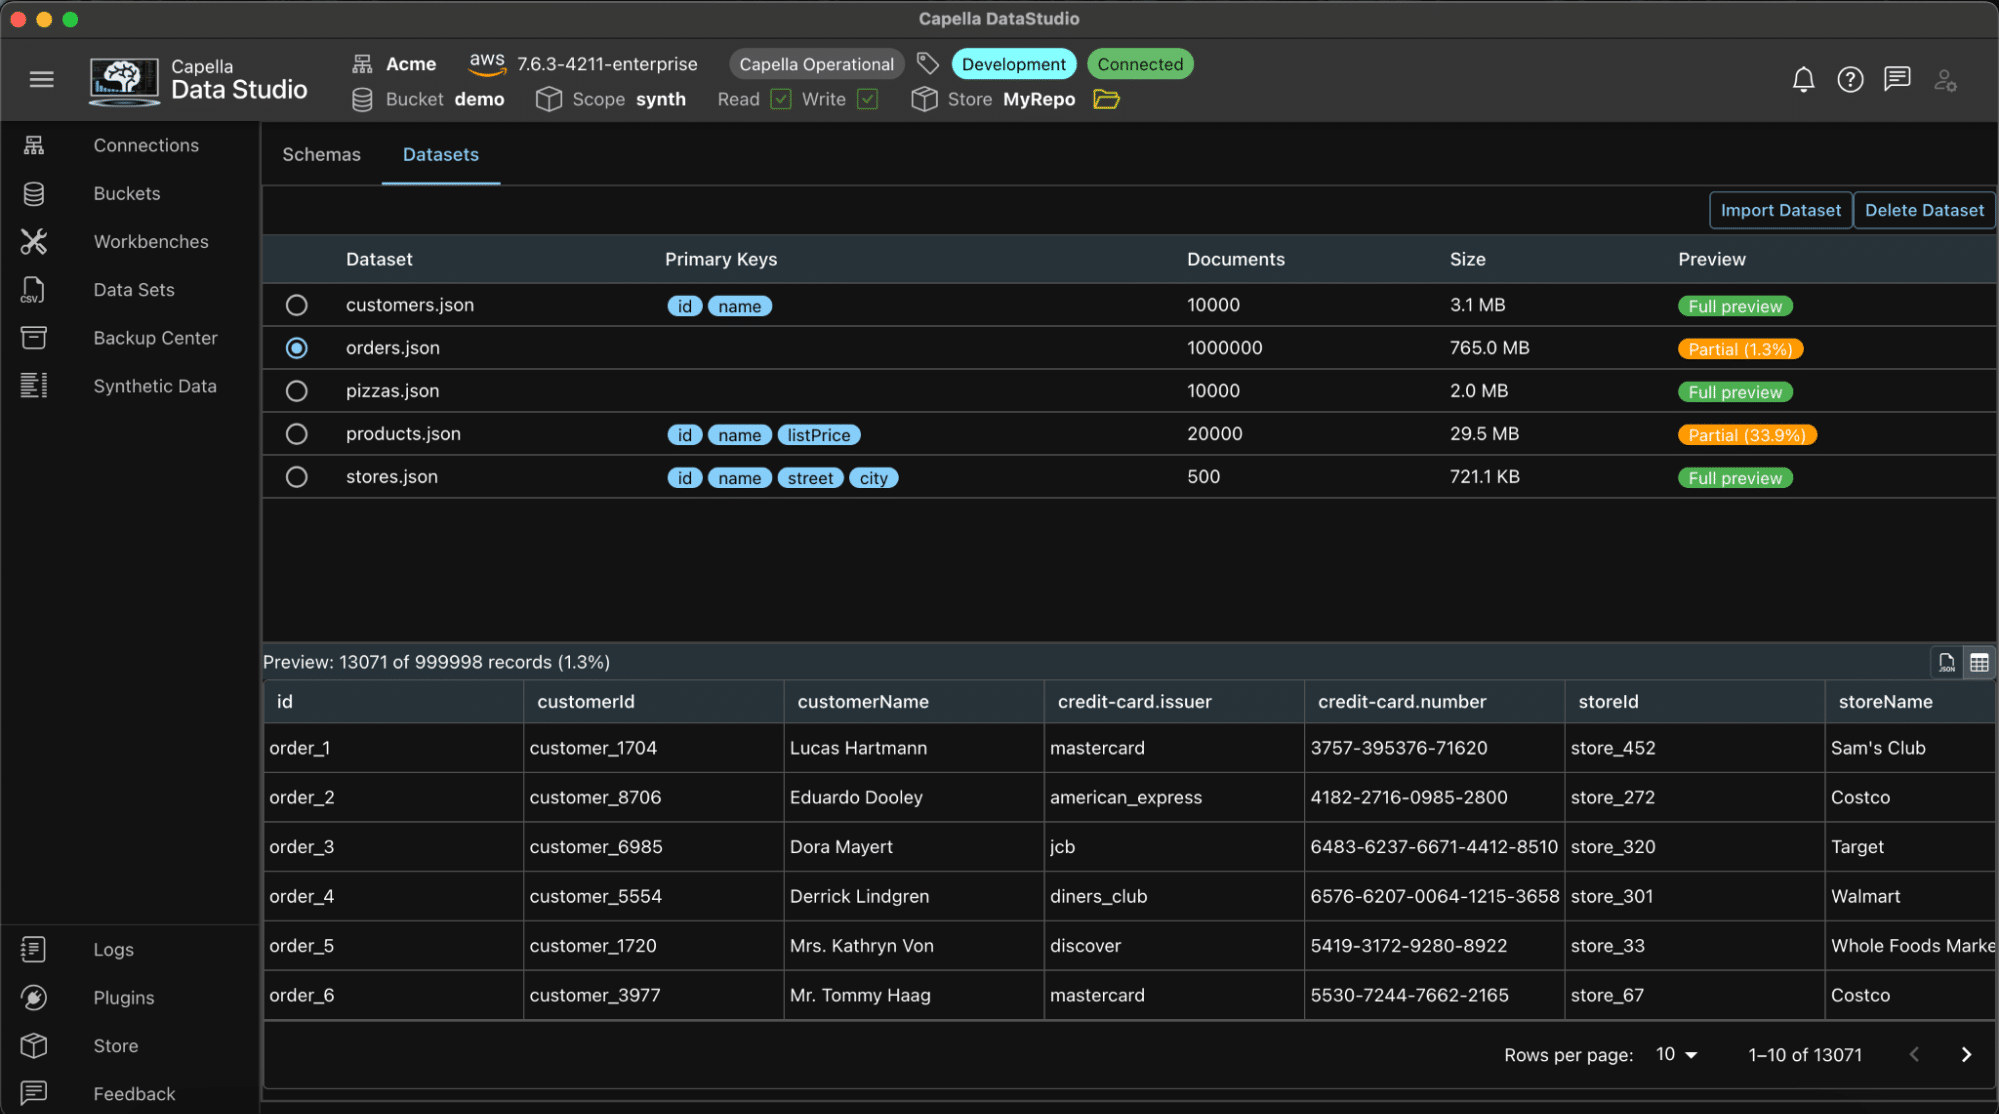
생성된 데이터 세트를 미리 볼 수 있습니다. 미리 보기 패널에서는 데이터의 미리 보기를 JSON 형식 또는 테이블 형식으로 지원합니다.
수입
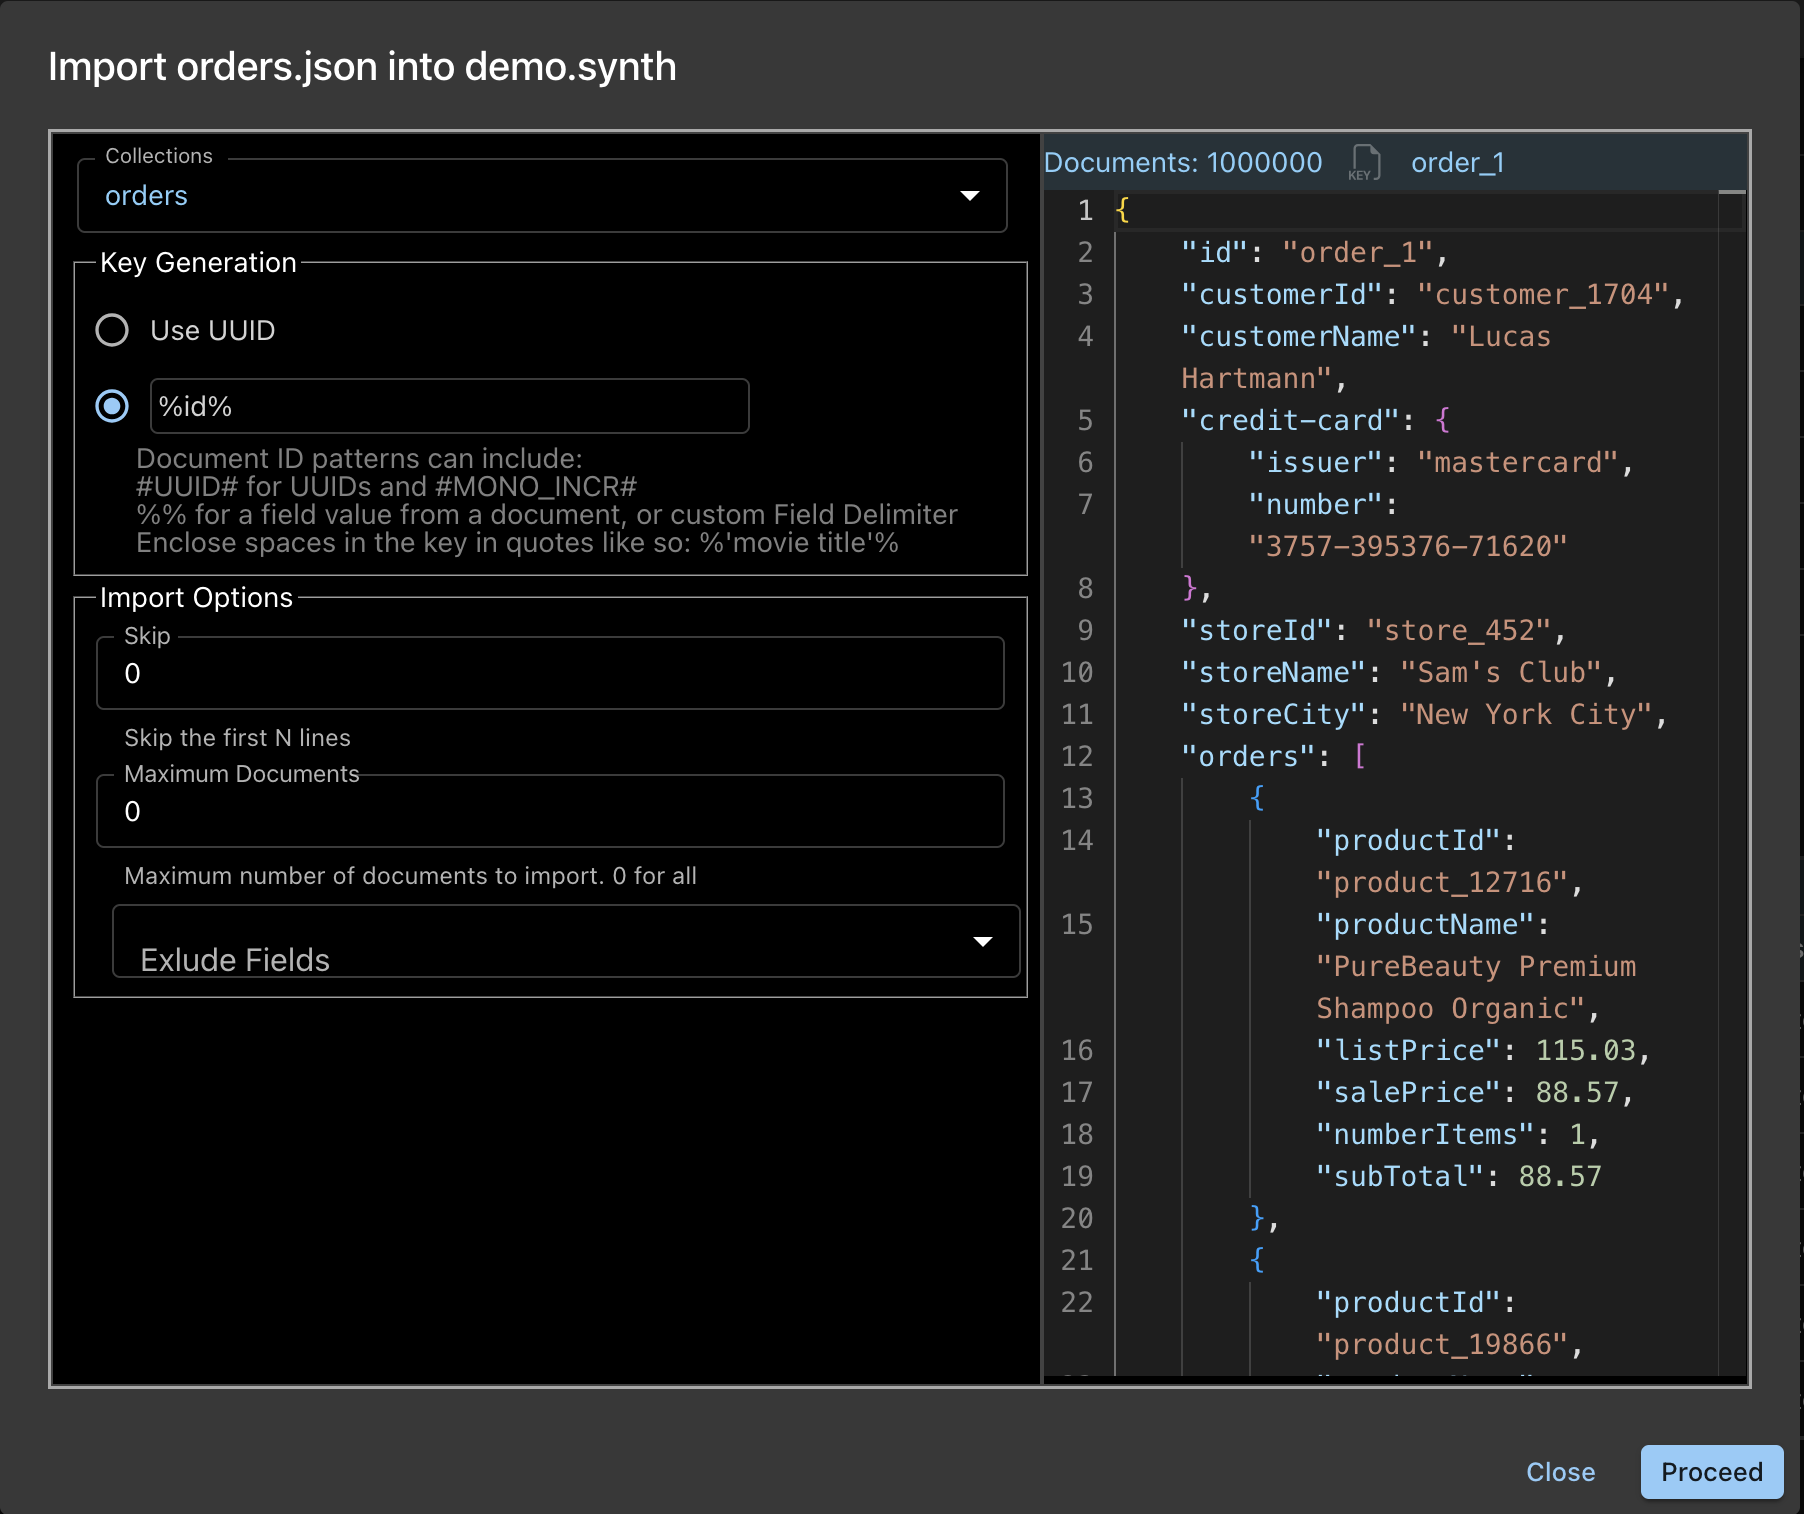
생성된 데이터 세트를 Couchbase 컬렉션으로 가져올 수 있습니다:
- Import는 cbimport 유틸리티를 사용하며 모든 가져오기 옵션을 제공합니다.
- 업로드할 파일 제한은 없습니다.
업무 생산성을 높이려면 준비됐나요?
Capella DataStudio는 개발자들이 기다려 온 도구입니다. Couchbase Server, Capella Operational 또는 Capella Columnar 클러스터를 관리하든 이 앱은 여러분의 작업을 더 쉽고 빠르게, 그리고 더욱 멋지게 만들어줍니다.
시도해 보세요 Capella DataStudio를 무료로 사용하세요 그리고 저희의 제품을 확인해 보세요 튜토리얼 동영상:
Capella DataStudio를 사용하면 데이터 관리가 이렇게 재미있고 생산적이었던 적이 없었습니다!
부록 – f식에서 지원되는 유혈
표는 표현식에서 사용할 수 있는 함수 목록을 보여줍니다:
| 입력 | 예시 | 출력 |
| int(min,max) | int(1,10) | 6 |
| float(min,max) | float(1.234,10.587) | 5.824 |
| float(min,max,dec) | float(1,10,2) | 5.82 |
| normal(평균, 표준편차, dec) | normal(50,10,3) | 56.48 |
| bool() | bool() | 거짓말입니다. |
| bool(bias) | bool(0.8) | TRUE |
| date(from,to) | 날짜(2024년 1월 1일, 2024년 12월 31일) | “02/02/2024” |
| 시간(출발지, 도착지) | 시간(오전 8시, 오후 5시) | “08:47 AM” |
| arrayItem(array) | arrayItem [“cat”,”mouse”,”dog”]() | “고양이” |
| arrayItem(array) | arrayItem [“cat:2″,”mouse:1″,”dog:7”]() | “개” |
| arrayItems(array,length) | arrayItems([“cat”,”mouse”,”dog”],2) | [“cat”,”mouse”] |
| arrayItems(array,length) | arrayItems [“cat:2″,”mouse:1″,”dog:7”]() | [“cat”,”dog”] |
| arrayKV(array,field) | arrayKV([“cat:2″,”mouse:1″,”dog:7″],”cat”) | 2 |
| GPS(위도, 경도) | GPS(37.3382,-121.8863) | gpsObject |
| gpsNearby(gps,radius) | gpsNearby(%gps%,20) | gpsObject |
| seq(startNumber) | seq(1000) | 1030 |
| uuid() | uuid() | “e46b493a-…” |
| add(num1,num2) | add(1.23,3.45) | 4.68 |
| subtract(num1,num2) | subtract(1.23,3.45) | -2.22 |
| multiply(num1,num2) | multiply(1.23,3.45) | 4.24 |
| 퍼센트(num, den) | 퍼센트(1.23,3.45) | “35.65%” |
| 수집(num,name) | accumulate(%orders.subTotal%,sale) | 1304.84 |

댓글 남기기
댓글을 달기 위해서는 로그인해야합니다.