
Seja você novo no Couchbase ou um veterano experiente, você provavelmente já ouviu falar de Scopes e Collections. Se você estiver pronto para experimentá-los por conta própria, este artigo ajuda você a fazer isso acontecer.
Escopos e Coleções são um novo recurso introduzido em o lançamento do Couchbase Server 7.0 que permite organizar logicamente os dados dentro do Couchbase. Para saber mais, leia a introdução a Escopos e Coleções a seguir.
Você deve aproveitar Escopos e Coleções se quiser mapear seu SGBDR legado para um banco de dados de documentos ou se estiver tentando consolidar centenas de microsserviços e/ou tenants em um único Couchbase cluster (resultando em um TCO muito menor).
Neste artigo, vou explicar como você pode planejar sua migração de uma versão mais antiga do Couchbase para o uso de Scopes e Collections no Couchbase 7.0.
Etapas de Migração de Alto Nível
As etapas de alto nível para a migração para Escopos e Coleções no Couchbase 7.0 são as seguintes.
Nem todas as etapas são essenciais: tudo depende do seu caso de uso e dos seus requisitos tecnológicos específicos. Apresentarei os detalhes de cada uma dessas etapas nas seções seguintes.
- Atualizar para o Couchbase Server 7.0
- Planeje sua estratégia de Escopos e ColeçõesDetermine quais Buckets, Scopes, Collections e índices você precisa. Determine o mapeamento do(s) Bucket(s) antigo(s) para o(s) novo(s) Bucket(s)/Scope(s)/Collection(s). Escreva scripts para criar Scopes, Collections e índices.
- Migre o código do seu aplicativo: Este código de aplicativo é o seu código do SDK do Couchbase, incluindo consultas N1QL.
- Migração de dados: Determine se uma estratégia offline funciona para a sua implantação ou se você precisa de uma migração online. Tome as providências necessárias.
- Planeje e implemente sua estratégia de segurança de banco de dados: Determine quais usuários e atribuições de função você precisa. Crie scripts para gerenciar essas atribuições.
- Lance sua nova aplicação compatível com Collections
- Configure o XDCR e configure o Backup para o seu banco de dados Couchbase
Atualizar para o Couchbase 7
Aqui é o que você precisa saber sobre a atualização para Couchbase Server 7.0:
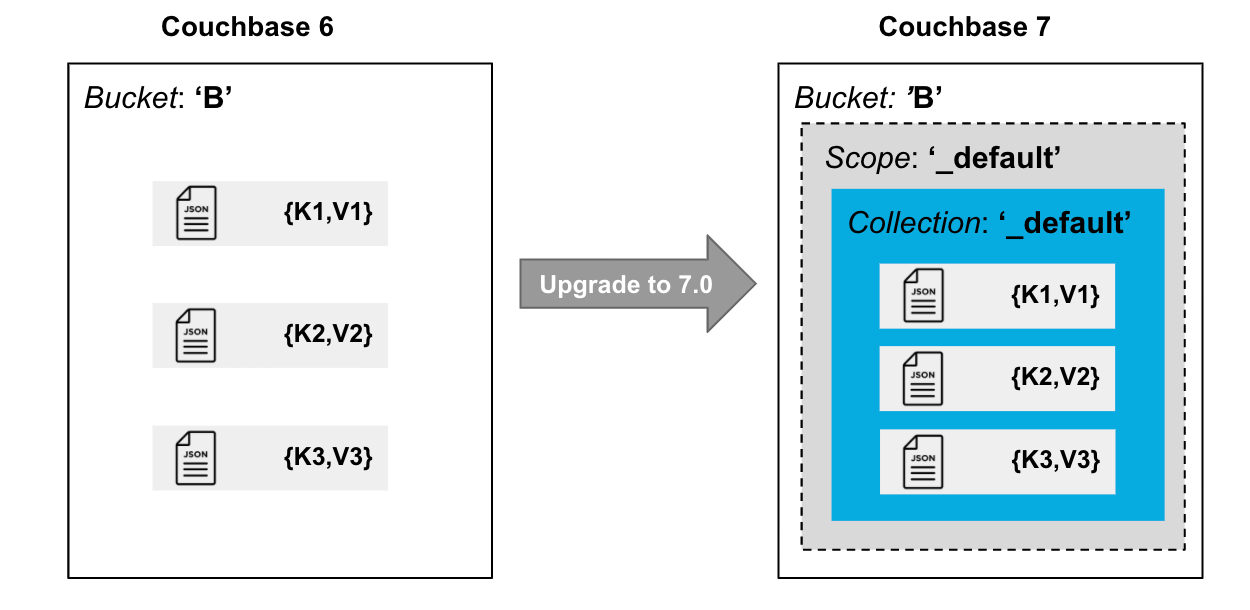
- Todo Bucket no 7.0+ tem um
_defaultEscopo com um_defaultColeção nele. - A atualização para o Couchbase 7.0 move todos os dados no Bucket para o
_defaultColeção do Balde. - Há sem impacto nos aplicativos existentes. Por exemplo, uma referência do SDK 2.7 a Bucket
Bresolve-se automaticamenteB._default._default(referindo-se ao_defaultEscopo e Coleção, respectivamente).
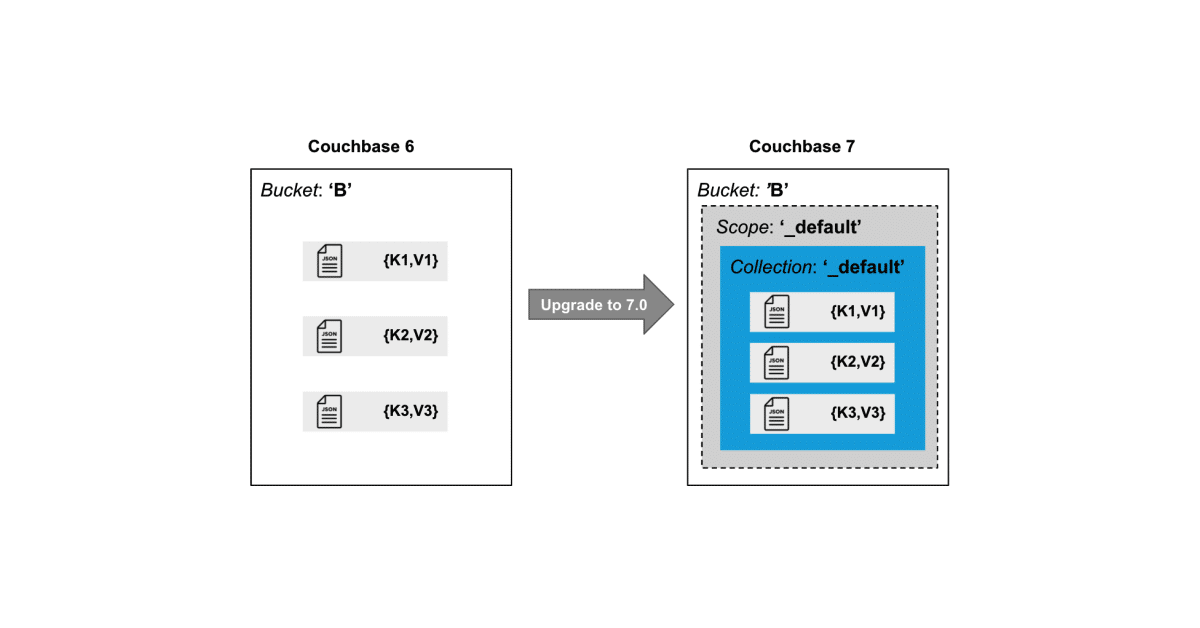
O diagrama abaixo ilustra como os dados são organizados em Buckets, Scopes e Collections após a migração de dados do Couchbase 6 para o Couchbase 7.
Se você não deseja usar Escopos e Coleções nomeados, pare por aqui.
Mas se você estiver pronto para usar esse novo recurso de organização de dados, continue lendo.
Planeje sua Estratégia de Escopos e Coleções
Abaixo estão os cenários de migração de banco de dados mais comuns que encontrei. Seu cenário de migração pode ser diferente e os resultados podem variar.
Consolidação: De Múltiplos Buckets para Collections em um Único Bucket
Um cenário comum é quando você está tentando reduzir seu custo total de propriedade (TCO) consolidando vários Buckets em um único Bucket.
Um cluster pode ter no máximo 30 Buckets, enquanto você pode ter 1000 Coleções por cluster, permitindo uma densidade muito maior. Este é um cenário comum para consolidação de microsserviços.
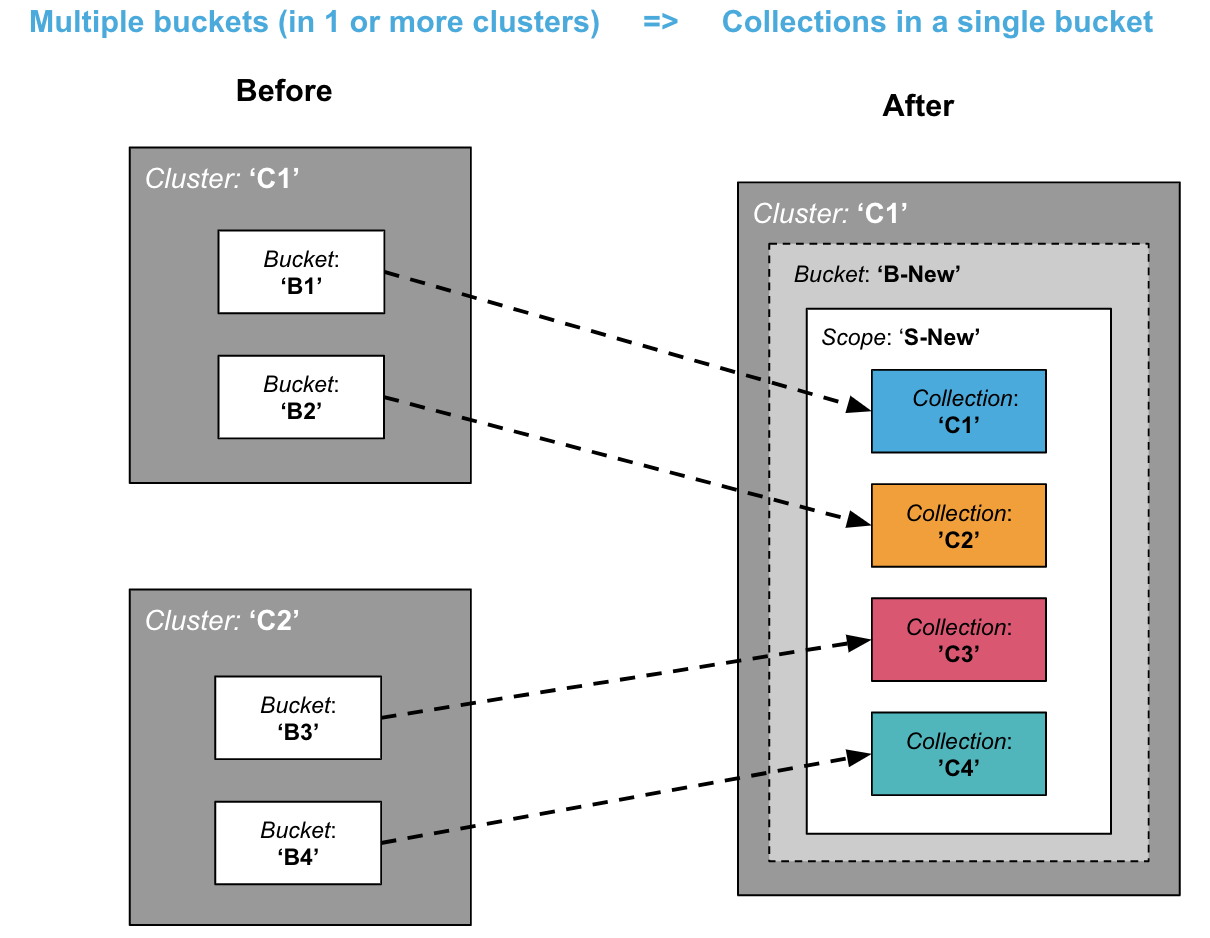
O diagrama acima mostra todas as Coleções de destino pertencentes ao mesmo Escopo. Mas você também poderia facilmente ter as Coleções de destino pertencentes a Escopos diferentes.
Dividindo: De um Único Bucket para Múltiplas Coleções em um Bucket
Outro cenário comum é migrar os dados que residem em um único Bucket e dividi-los em várias Collections (dentro do mesmo Bucket).
Você pode ter qualificado anteriormente diferentes tipos de dados com um tipo = foo campo ou com um prefixo de chave como foo_key. Agora, cada um desses tipos de dados pode residir em sua própria Coleção, oferecendo as vantagens de isolamento lógico, isolamento de segurança, replicação e controle de acesso.
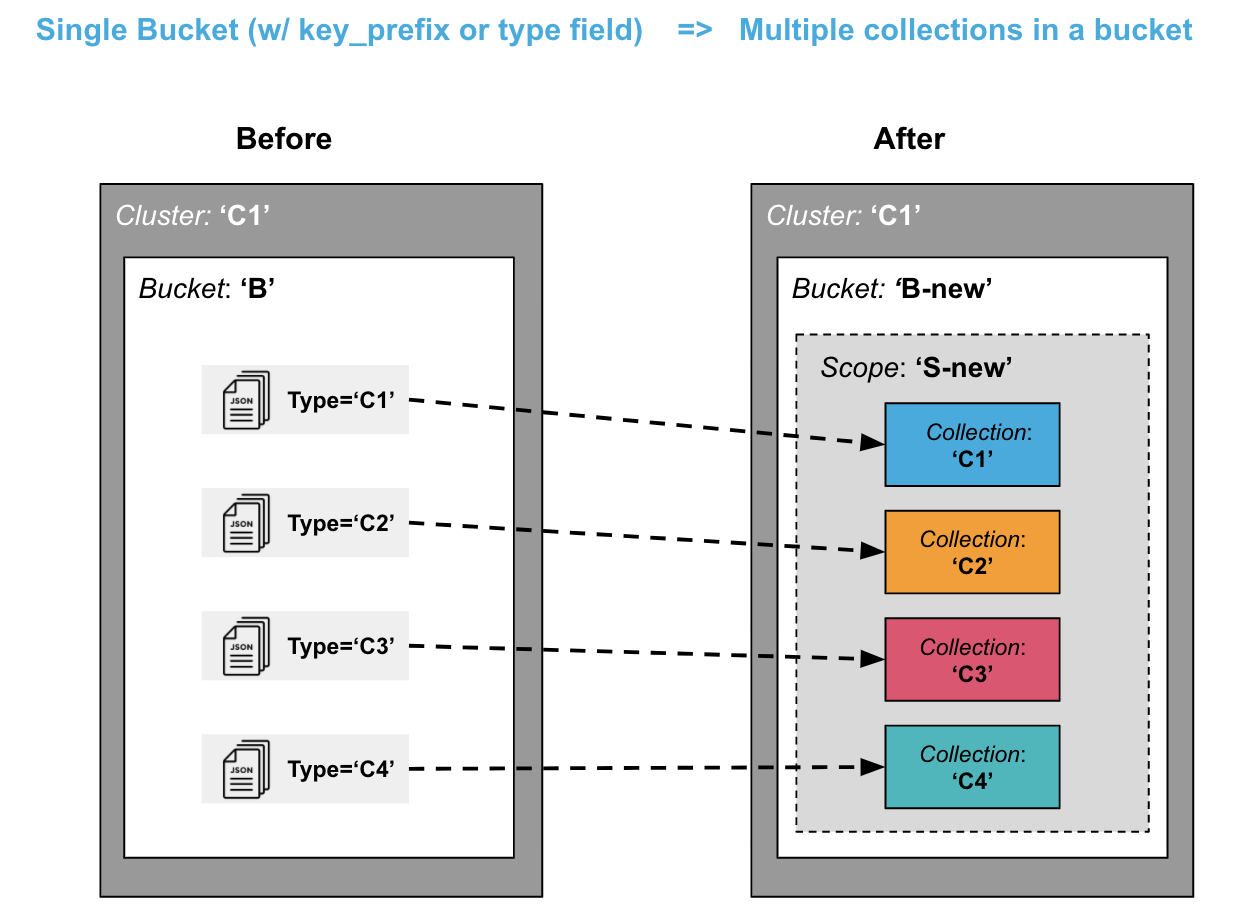
Este cenário pode ser um pouco mais complexo do que o cenário de “consolidação” anterior, especialmente se você quiser se livrar do prefixo da chave ou do campo de tipo. Para uma migração mais simples, você pode preferir deixar os prefixos das chave e os campos de dados de tipo como estão, mesmo que possam ser um pouco redundantes com as Collections.
Criação de Escopos, Coleções e Índices
Assim que você tiver planejado quais Scopes, Collections e índices deseja ter, você precisará criar scripts para a criação dessas entidades. Você pode usar o SDK do Couchbase da sua escolha, o couchbase-cli, as APIs REST diretamente, ou até mesmo scripts N1QL para fazer isso.
Abaixo está um exemplo de uso da CLI (couchbase-cli e shell cbq) para criar um Escopo, uma Coleção e um índice.
|
1 2 3 4 5 6 7 8 |
// crie um Scope chamado ‘myscope’ usando o couchbase-cli ./Couchbase–CLI coleção–gerenciar –c localhost –u Administrador –p senha —balde testBucket —criar–escopo meu escopo // criar uma Coleção chamada mycollection em myscope ./Couchbase–CLI coleção–gerenciar –c localhost –u Administrador –p senha —balde testBucket —criar–coleção meu escopo.minhacoleção // criar um índice em mycollection usando cbq ./cbq —motor=localhost:8093 –u Administrador –p senha —roteiro=“create index myidx1 on testBucket.myscope.mycollection(field1,field2);” |
Note que o criação de índice declaração faz não exigir que você qualifique os dados com um tipo = foo ou cláusula de qualificação de prefixo de chave.
Migre o código da sua aplicação
Para usar Scopes e Collections nomeados, o código do seu aplicativo (incluindo Consultas N1QLprecisa ser migrado.
Se você estava usando campos de tipo ou prefixos de chave anteriormente (como no cenário de divisão), você não mais deles.
Exemplo de Código do SDK
No código do seu SDK, você precisa se conectar a um cluster, abrir um Bucket e obter uma referência a um objeto Collection para armazenar e recuperar documentos. Antes das Collections, todas as operações de chave-valor eram realizadas diretamente no Bucket.
Nota: Se você migrou para o Couchbase SDK 3.0, você já fez parte do trabalho de começar a usar Collections (embora até agora você só pudesse usar a Collection padrão).
O seguinte é um simples SDK Java trecho de código para armazenar e recuperar um documento em uma Coleção:
|
1 2 3 4 5 6 7 8 9 10 |
Aglomerado aglomerado = Aglomerado.conectar(“127.0.0.1”, “Administrador”, “senha”); Balde balde = aglomerado.balde(“nome-do-bucket”); Escopo escopo = balde.escopo(“nome-do-escopo”); Coleção coleção = escopo.coleção(“nome-da-coleção”); Objeto Json conteúdo = Objeto Json.criar().colocar(“autor”, “mike”); ResultadoDaMutação resultado = coleção.atualização upsert(“chave-do-documento”, conteúdo); ObterResultado obterResultado = coleção.obter(“chave-do-documento”); |
Consultas N1QL
Agora, se você quiser executar uma consulta N1QL na Collection do exemplo em Java acima, faça o seguinte:
|
1 2 3 |
//executar uma N1QL usando o contexto do Scope escopo.consulta(“select * from collection-name”); |
Observe que você pode consultar diretamente em um Escopo. A consulta acima no objeto Escopo é mapeada automaticamente para select * from bucket-name.scope-name.collection-name.
Outra maneira de fornecer contexto de caminho para o N1QL é defini-lo no QueryOptions. Por exemplo:
|
1 2 |
QueryOptions qo = QueryOptions.opções de consulta().cru(“contexto_da_consulta”, “bucket-name.scope-name”); aglomerado.consulta(“select * from collection-name”, qo); |
Um Escopo pode ter várias Coleções, e você pode juntá-las diretamente referenciando o nome da Coleção dentro do Escopo. Se precisar consultar vários Escopos (ou vários Buckets), é melhor usar o objeto cluster para fazer a consulta.
Observe que as consultas N1QL não precisam mais qualificar um tipo = foo campo (ou prefixo_da_chave qualificador), se aplicável.
Por exemplo, esta consulta N1QL antiga...
|
1 2 3 4 5 6 |
SELECIONAR r.aeroportodedestino DE Viagem a PARTICIPAR Viagem r LIGADO a.FAA = r.aeroporto de origem E r.tipo = “rota” ONDE a.cidade = “Toulouse” E a.tipo = “aeroporto”; |
...agora se torna:
|
1 2 3 4 |
SELECIONAR r.aeroportodedestino DE Aeroporto a PARTICIPAR Rota r LIGADO a.FAA = r.aeroporto de origem ONDE a.cidade = “Toulouse”; |
Migração de Dados para Coleções
Em seguida, você precisa migrar os dados existentes para seus novos Escopos e Coleções nomeados.
A primeira coisa que você precisa determinar é se você pode arcar com os custos de fazer uma migração offline (onde sua aplicação fica offline por algumas horas), ou se você precisa fazer uma migração majoritariamente online com o mínimo de tempo de inatividade da aplicação.
Uma migração offline pode ser mais rápida no geral e exigir menos recursos extras em termos de espaço em disco adicional ou nós.
Migração Offline
Se você optar por fazer a migração offline, poderá usar N1QL ou Backup/Restauração. Analisaremos ambas as opções mais de perto.
Usando N1QL para uma Migração Offline
Pré-requisitoSeu cluster deve ter espaço em disco disponível e estar usando o Serviço de Consulta.
Seguindo esta abordagem, sua migração seria algo parecida com a seguinte:
- Criar novos Escopos, Coleções e índices.
- Desativar aplicativo antigo.
- Para cada Coleção nomeada:
- Inserir-Selecionar de
_defaultCollection to named Collection (using appropriate filters). - Delete data from
_defaultCollection that was migrated in above step (to save space; or if space is not an issue, you can do this at the end).
- Inserir-Selecionar de
- Verify your migrated data.
- Drop old Buckets.
- Online your new application.
Using Backup/Restore for an Offline Migration
Pré-requisito: You need disk space to store backup files.
With this approach, your migration would look like this:
- Create new Scopes, Collections and indexes
- Take application offline
- Take backup (
cbbackupmgr) of 7.0 cluster - Restore using explicit mapping to named Collections. Use
--filter-keyse--map-data(see examples 1 and 2 below). - Online your new application.
Example 1: No Filtering during Restore
This example moves the entire _default Collection to a named Collection. (This is the likely case for the consolidation scenario).
|
1 2 3 4 5 6 7 8 |
// Backup the default Scope of a Bucket upgraded to 7.0 cbbackupmgr configuração –a backup –r teste–01 —include–dados beer–sample._default cbbackupmgr backup –a backup –r teste–01 –c localhost –u Administrador –p senha // Restore above backup to a named Collection cbbackupmgr restaurar –a backup –r teste–01 –c localhost –u Administrador –p senha —mapa–dados beer–sample._default._default=beer–sample.beer–service.service_01 |
Example 2: Restore with Filtering
This example moves portions of _default Collection to different named Collections (This is the likely case for the splitting scenario).
|
1 2 3 4 5 6 7 8 9 10 |
// Backup the travel-sample Bucket from a cluster upgraded to 7.0 cbbackupmgr configuração –a backup –r teste–02 —include–dados viagem–sample cbbackupmgr backup –a backup –r teste–02 –c localhost –u Administrador –p senha // Restore type=’airport’ documents to a Collection travel.booking.airport cbbackupmgr restaurar –a backup –r teste–02 –c localhost –u Administrador –p senha —mapa–dados viagem–sample._default._default=viagem.booking.airport —auto–criar–baldes —filtro–valores ‘”type”:”airport”‘ // Restore key_prefix =’airport’ documents to a Collection travel.booking.airport cbbackupmgr restaurar –a backup –r teste–02 –c localhost –u Administrador –p senha —mapa–dados viagem–sample._default._default=viagem.booking.airport —auto–criar–baldes —filtro–keys airport_* |
Online Migration Using XDCR
In order to do a mostly online migration, you need to use cross data center replication (XDCR).
Depending on your spare capacity in the existing cluster, you can do self-XDCR (where the source and destination Bucket are on the same cluster), or you can set up a separate cluster to replicate to.
Here are the steps you need to follow:
- Setup XDCR from yoursource cluster to your target cluster (you can do self-XDCR if you have spare disk space and compute resources on the original cluster).
- Create new Buckets, Scopes and Collections.
- Set up replications either directly from a Bucket to a
bucket.scope.collectionor using Migration Mode (details shown below) if a single Bucket’s default Collection has to be split into multiple Collections. - Explicit mapping rules are specifiable for each destination to specify subset of the data.
- Once replication destinations are caught up, offline your old application.
- Online your new application directing it to the new cluster (or new Bucket if using self-XDCR).
- Delete your old cluster (or your old Bucket if using self-XDCR).
Using XDCR to Migrate from Multiple Buckets to a Single Bucket
These steps are for the consolidation scenario.
The XDCR set up will look something like the following:
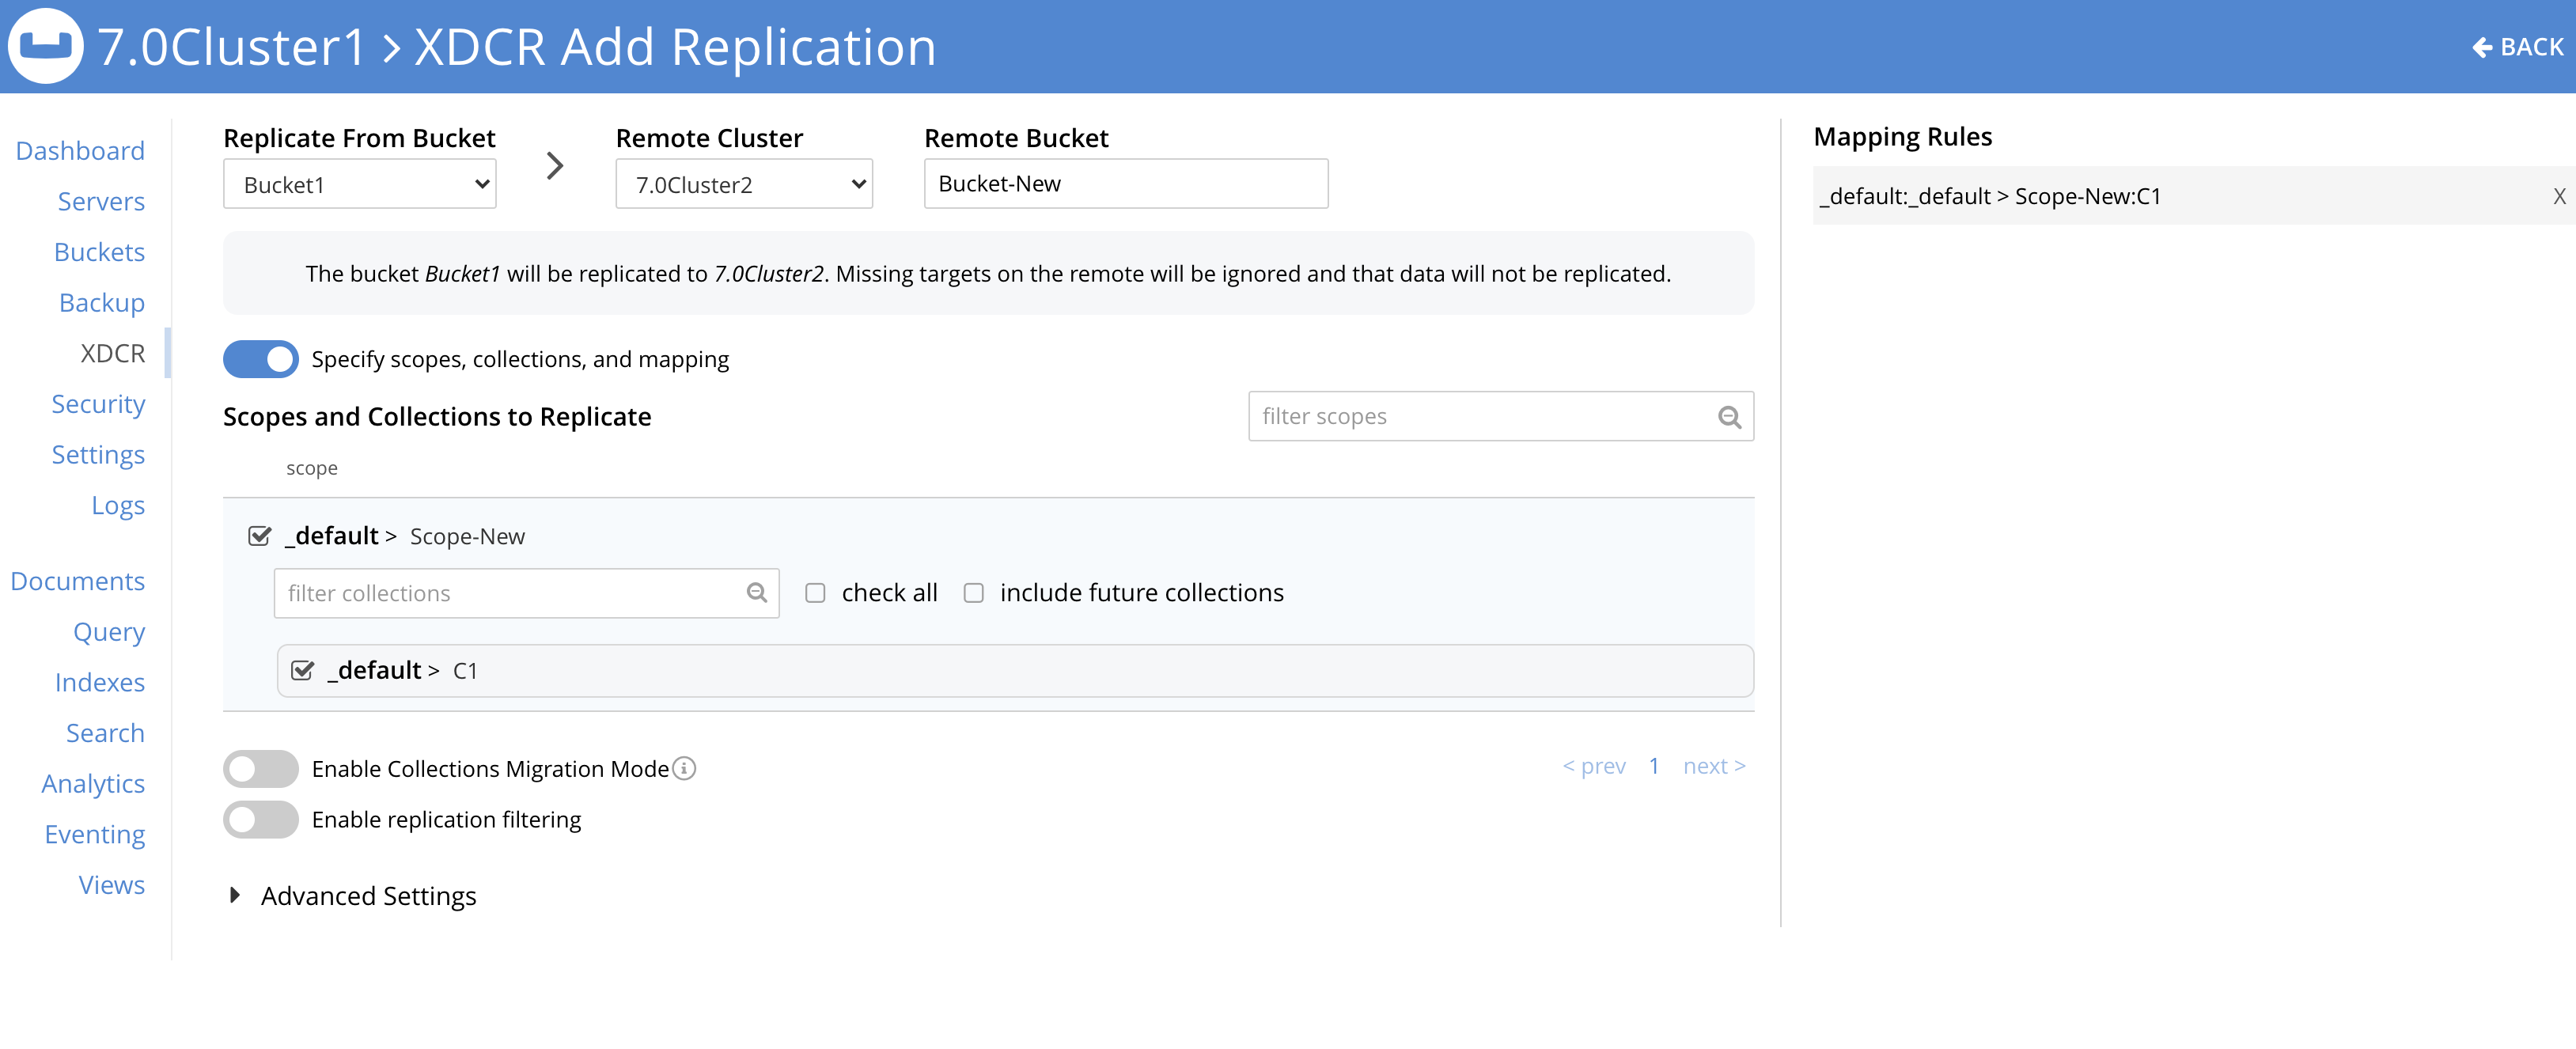
- For each source Bucket, set up a replication to the named Collection in the destination Bucket and Scope
The following screenshot shows the XDCR set up for one source Bucket:
Using XDCR to Split to Multiple Collections from within a Single Bucket
These steps are for the splitting scenario.
In order to map the source _default Collection to multiple target Collections, you should use the Migration Mode provided by XDCR.
The XDCR screens below show Migration Mode being used:
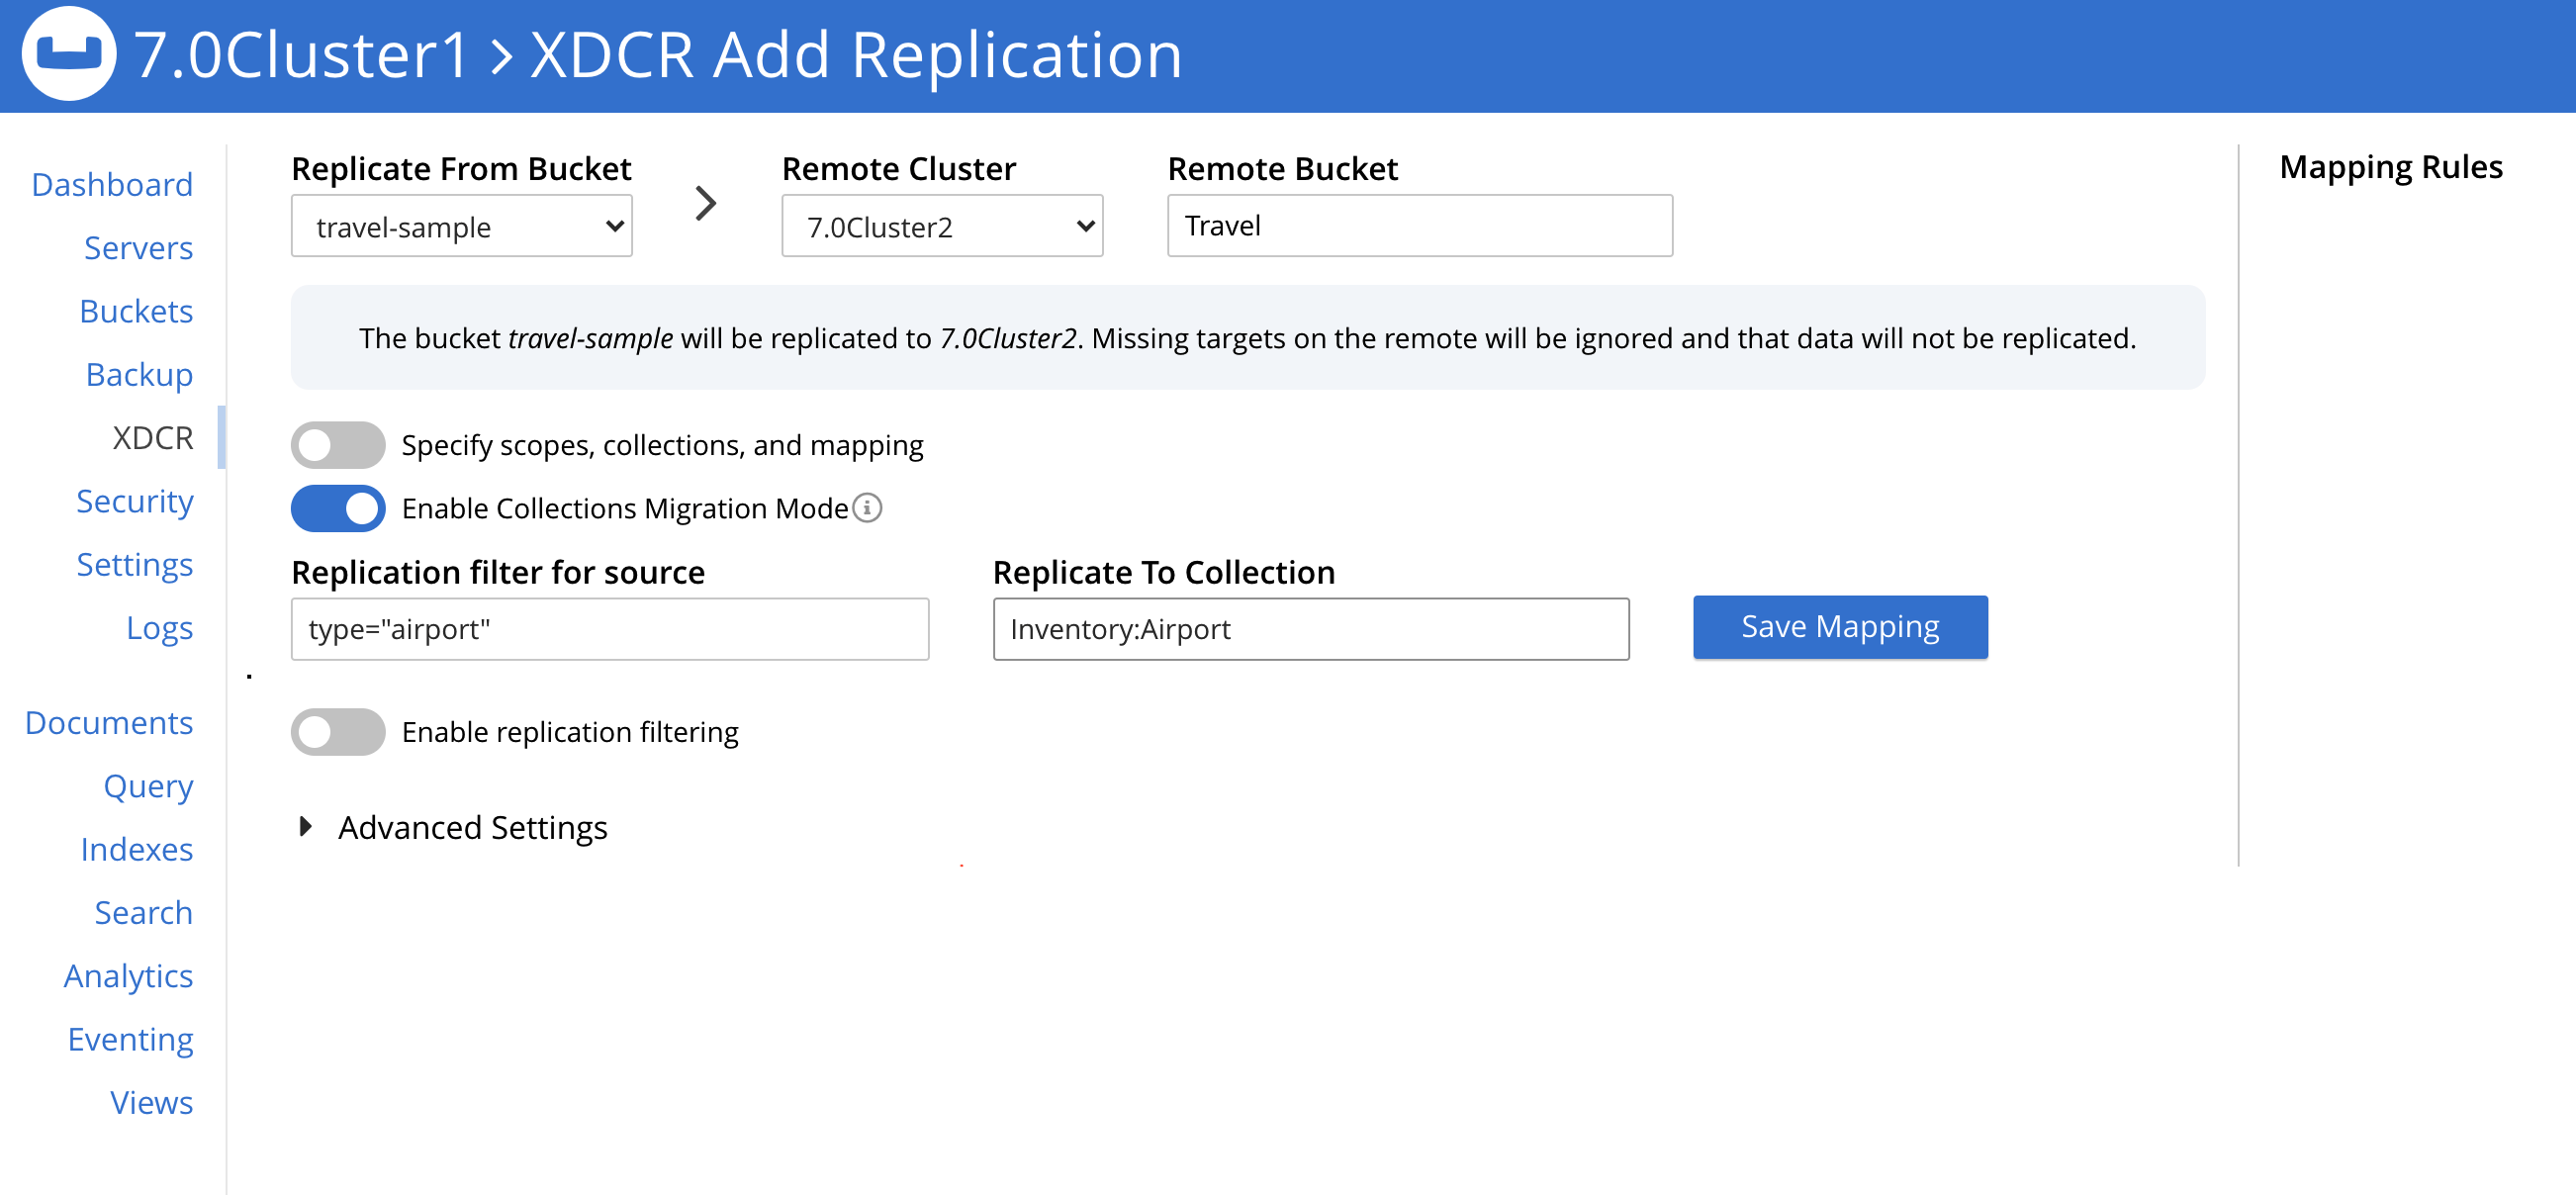
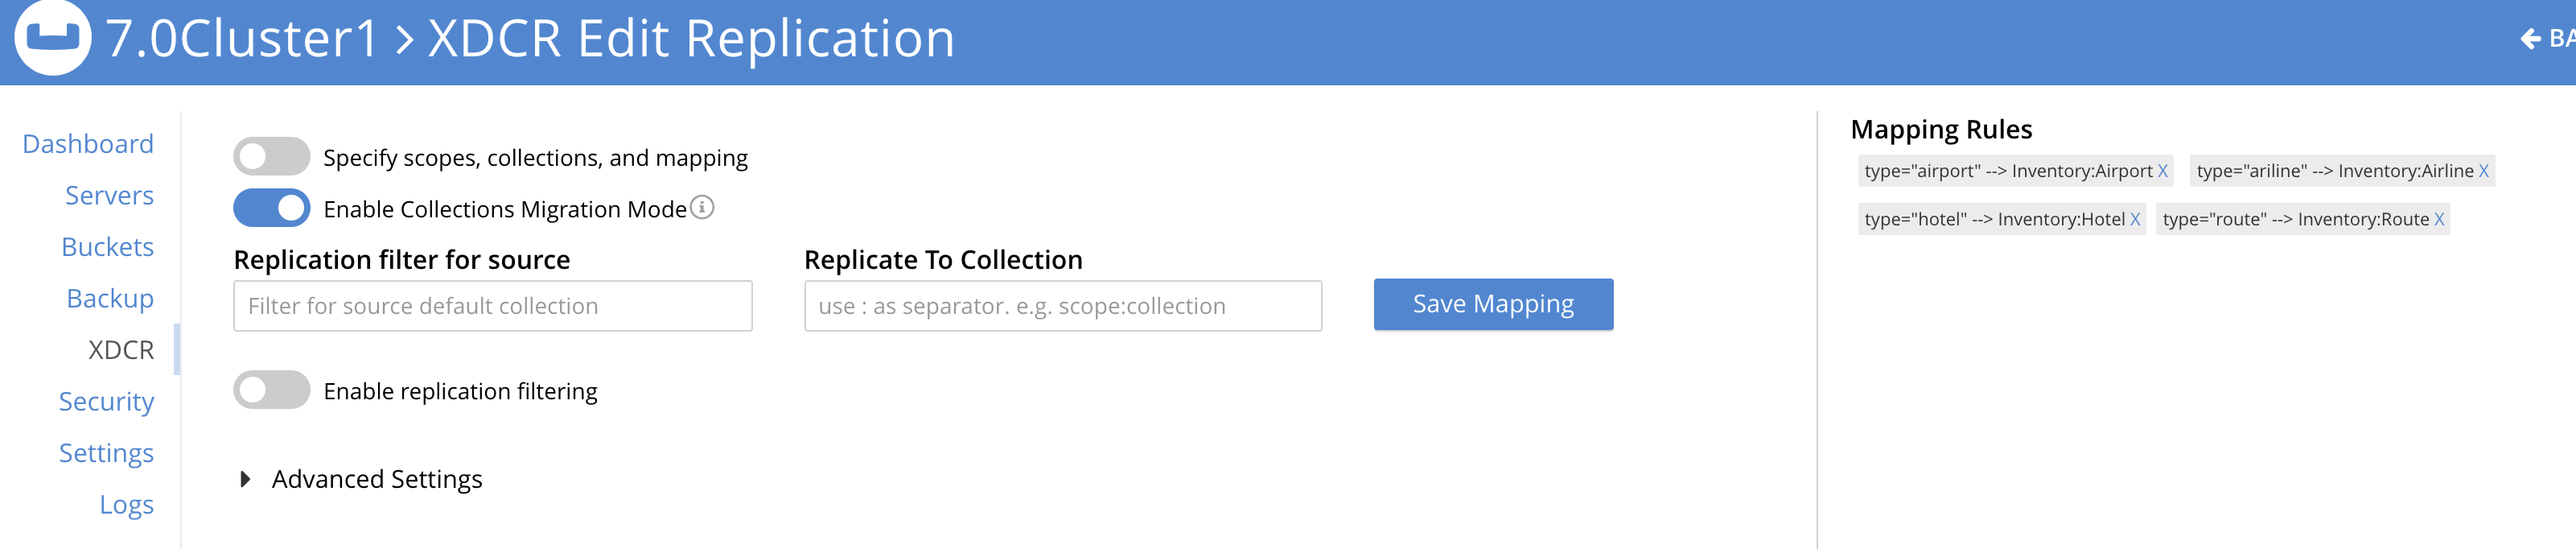
There are four filters you need to set up: (Travel-sample._default._default is the source. A new Bucket called Viagem is the target.)
- filtro
type="airport", replicate toInventory:Airport - filtro
type="airline", replicate toInventory:Airline - filtro
type="hotel", replicate toInventory:Hotel - filtro
type="route", replicate toInventory:Route
Plan & Implement Your Database Security Strategy
Now that you have all your data in named Scopes and Collections, you have finer control over what data you can assign privileges to. Previously you could do so only at Bucket level.
For more information on role-based access control (RBAC) security for Scopes and Collections, read this article: Introducing RBAC Security for Collections or consult the documentation on RBAC.
The following roles are available at Scope and Collection level in Couchbase 7.
Admin Roles:
- Scope Admin role is available at the Scope level. A Scope admin can administer Collections in their Scope.
Data Reader Roles:
- Data Reader
- Data Writer
- Data DCP Reader
- Data Monitoring
Query Roles:
- FTS Searcher
- Query Select
- Query Update
- Query Insert
- Query Delete
- Query Manage Index
- Query Manage Functions
- Query Execute Functions
Conclusão
I hope this guide helps you successfully migrate to Scopes and Collections in Couchbase 7.
For more information on the 7.0 release, check out the What’s New documentation ou peruse the release notes.
What do you think of the new Scopes and Collections feature? I look forward to hearing your feedback on the Couchbase Forums.
Ready to try out Scopes and Collections for yourself?
Dig into Couchbase 7 today
Autor

6 respostas
-
@Shivani, Is it possible to configure the scope and collections to be sync’d in the sync gateway? I would like to restrict the documents sync’d only of a particular scope/collection?
-
Sync Gateway support will come a later. So with 7.0 you can also receive documents in the default collection using Sync Gateway.
-
Sorry typo above. I meant with 7.0 you can only receive documents in the default collection using Sync Gateway.
-
I planned to categorize a multi-tenant application using scope and collections. I would have liked sync gateway to allow syncing based on collections or scopes. When can we expect sync gateway support?
Couple of more questions
1. Can the same document be part of default collection and another custom collection?
2. Can multiple scope refer to default collection?
-
-
-
The timeframe for Sync Gateway support is TBD.
1) The ‘same’ document in two different collections (default and custom, or two different custom) is essentially two different documents. If you are asking whether the same document key can be used in two different collections, then the answer is Yes.2) I don’t understand this question. The default collection only exists in the default scope. No other scope has a default collection. As a user you cannot create a default collection (it is created by Couchbase only).
-
@Shivani, is there any update about availability of scope&collection support in Sync Gateway?
As user @GaneshN, we are designing multi-tenant application using Couchbase server 7.0 and we need to implement client syncing based on that feature.
GaneshN post is almost 1 year old, I really hope in good news.


Deixe um comentário
Você precisa fazer o login para publicar um comentário.